 AIREITER
카페 메뉴에 가격 네 개를 넣는 일은 쉬워 보입니다. 하지만 모델이 그중 하나를 멋대로 바꾸는 순간, 단순한 이미지 생성이 아니라 검수 작업이 됩니다. MOSS Image는 덩치에 비해 이런 문구를 훨씬 정확하게 처리합니다. 단, 구조를 명확히 전달하고 디자이너처럼 결과물을 꼼꼼히 확인해야 합니다.
이번 리뷰에서 확인한 핵심은 바로 이 지점입니다. MOSS Image는 Apache 2.0 라이선스로 공개된 50억 파라미터 텍스트-이미지 모델로, 최대 4,096토큰 프롬프트와 텍스트·오브젝트용 선택형 JSON 바운딩 박스를 지원합니다. OpenMOSS 팀은 2026년 10월 16일 Base와 SFT 체크포인트를 공개했고, MOSI 플랫폼의 호스팅 API는 10월 20일 서비스를 시작했습니다. 포스터, 메뉴, 라벨, 인포그래픽처럼 문구를 정확히 넣어야 하는 작업이라면 테스트해볼 가치가 있습니다. 반대로 캐릭터 일관성이나 사진 편집이 목적이라면 아직은 폐쇄형 모델을 선택하는 편이 낫습니다.
첫 결과가 방향을 정한다: 글자는 잘 남지만, 미적인 완성도는 늘 일정하지 않다
MOSS Image의 강점은 전반적인 미감이 아니라 길고 정확한 텍스트입니다. 개발사가 자체 진행한 LongLongTextBench에서 전체 Mean-6 텍스트 커버리지는 96.3을 기록했습니다. 긴 영어는 97.1, 긴 중국어는 92.4였으며, 평균 약 1,340자 분량의 240개 작업을 기준으로 한 결과입니다. GPT Image 2는 99.0, Nano Banana Pro는 96.6이었습니다. 다만 개발사가 직접 설계하고 실행한 벤치마크인 만큼, 보장된 성능이라기보다 확인이 필요한 주장으로 받아들이는 것이 안전합니다.
레이아웃 지시를 얼마나 잘 따르는지도 중요합니다. 이번 리뷰에서 자세히 다룬 기술 보고서에 따르면, 7Bench 박스 추종 테스트에서 MOSS Image는 0.88 mIoU와 0.70 Layout AUC를 기록했습니다. 같은 보고서에서 Ideogram 4는 각각 0.44와 0.20, GPT Image 2는 0.30과 0.16이었습니다. 포스터·인포그래픽·UI를 대상으로 61개 작업을 블라인드 평가한 RealLayoutArena에서는 프롬프트 향상을 적용한 전체 MOSS 시스템이 1,698.70 Elo로 GPT Image 2의 1,844.35에 이어 2위를 차지했습니다. 모든 생성기에 동일한 향상 프롬프트를 적용하면 백본 모델 단독 성능은 1위였습니다. 이 결과 역시 개발사 자체 테스트이며, 독립적인 재현은 아직 필요합니다.
간단한 통제 테스트를 보면 차이가 더 분명해집니다. mossimage.run 팀은 동일한 1024x1024 캔버스와 시드에서 프롬프트마다 한 번씩 MOSS Image SFT와 FLUX.1 dev를 실행했습니다. 결과를 골라내지 않고 실패 사례도 그대로 포함했습니다. 이번 리뷰에서는 MOSI 호스팅 API의 지연 시간을 다시 측정하지 않았습니다. 아래 표는 해당 팀이 fal 엔드포인트를 통해 얻은 첫 결과를 요약한 것이며, MOSI API는 문서와 무료 제공 기간의 과금 상태를 기준으로 검토했습니다.
| 테스트 | 프롬프트 요구 사항 | MOSS Image SFT 첫 결과 | FLUX.1 dev 첫 결과 |
|---|---|---|---|
| 카페 메뉴 | MORNING MENU와 Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50을 오른쪽 정렬 | 네 항목과 가격을 모두 정확히 표시 | 레이아웃은 명확했지만 3.80이 3.60으로 바뀜 |
| 꿀 라벨 | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g)을 라벨 곡선에 맞춰 배치 | 세 줄 모두 정확히 표시 | 제목과 중량은 맞았지만 가운데 문구가 Raw & Unfilterelrd로 변형됨 |
| 이중언어 포스터 | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | 중국어와 영어 정보를 모두 정확히 표시 | 구성은 좋았지만 중국어가 깨졌고 10.00–178.00으로 출력됨 |
MOSS는 50스텝, CFG 3을 사용했고 FLUX는 28스텝, guidance 3.5를 사용했습니다. 실행에는 fal-ai/moss-image와 fal-ai/flux/dev를 이용했습니다. 세 가지 사례만으로 승자를 정할 수는 없다는 점은 해당 페이지도 지적합니다. 하지만 여기서 중요한 것은 실패의 형태입니다. 그럴듯한 이미지 안에서 가격이나 시간이 한 글자 바뀌는 것이, 누가 봐도 망가진 결과보다 오히려 위험합니다.
"5B 모델이라는 점을 감안하면 MOSS Image는 구조화된 레이아웃과 영어 텍스트를 잘 처리했습니다. 작은 디테일까지 매번 완벽하지는 않지만, 마침내 워크플로를 제어할 수 있다는 느낌이 들었습니다." — 전체 포스터 워크플로 영상을 게시한 @Olaemmy1200
API가 실제로 제공하는 것: 작은 생성기와 큰 텍스트 리더
MOSS Image는 처음부터 학습한 42레이어 단일 스트림 확산 트랜스포머입니다. 50억 파라미터라는 수치는 생성기만을 가리킵니다. 프롬프트를 읽는 동결된 Qwen3.5-9B 텍스트 인코더와 픽셀을 렌더링하는 FLUX.2 small-decoder VAE가 주변을 구성합니다. 긴 이중언어 문장을 이해하는 힘이 50억 파라미터 디노이저가 아니라 90억 파라미터 텍스트 리더에서 나온다는 점이 성능과 하드웨어 요구량을 함께 설명합니다.
실사용 관점에서 가장 눈에 띄는 장점은 컨텍스트 길이입니다. 자연어, 태그 시퀀스, JSON 레이아웃이 모두 최대 4,096토큰을 공유합니다. 짧은 캡션으로 포스터 내용을 압축하지 않고, 들어갈 문구를 한 줄씩 명시할 수 있는 길이입니다. MOSI API 문서에서는 호스팅 환경의 한도를 텍스트 렌더링을 지원하는 최대 4,000자 분량의 긴 텍스트로 설명합니다. 네거티브 프롬프트와 레이아웃 생성도 지원합니다. 출력은 1~2메가픽셀 범위를 권장하며, 512x512에서 2K까지 확장할 수 있고 가로·세로 크기는 16의 배수여야 합니다.
어떤 결과를 얻을지는 두 체크포인트에 달려 있습니다.
- MOSS-Image-SFT는 선별된 데이터로 지도학습 파인튜닝을 거친 Base 모델입니다. OpenMOSS 팀은 직접 생성할 때 이 버전을 권장하며, 텍스트 그룹화가 더 정돈되고 레이아웃도 깔끔합니다. 호스팅 API의 기본 모델은
moss-image-sft-1.0이며, 재현성을 위해moss-image-sft-1.0-2026-10-09고정 스냅샷도 제공합니다. - MOSS-Image-Base는 후처리 학습과 CFG 증류를 거치지 않아 원래의 학습 신호를 유지합니다. 공식 가이드는 파인튜닝 시 이 모델을 사용하고 텍스트 인코더는 동결할 것을 권장합니다. LoRA를 학습하거나 다른 스타일 분포를 실험할 때 Base를 선택하세요. 당장 포스터를 만들 목적이라면 SFT가 맞습니다.
Hugging Face 모델 카드와 공식 프로젝트 페이지에 따르면 두 가중치와 포함된 추론 코드는 Apache License 2.0으로 공개되어 있습니다. 상업적 이용과 파인튜닝은 가능하지만, 캠페인에 넣을 캐릭터·로고·초상에 관한 권리까지 자동으로 해결되는 것은 아닙니다. 상업 프로젝트에서는 라이선스 파일과 정확한 리비전을 함께 보관해야 합니다. 코드는 OpenMOSS GitHub 저장소에 있습니다.
이 워크플로를 감수할 이유는 JSON 레이아웃에 있다
자연어만으로도 생성할 수 있지만, 디자이너들이 이 모델을 테스트하는 이유는 레이아웃 문법에 있습니다. 먼저 전체 장면을 설명한 뒤, 각각의 텍스트나 오브젝트에 별도의 설명과 박스를 지정하는 방식입니다. 박스는 생성을 유도할 뿐, 벡터 레이어나 픽셀 단위의 완벽한 보장은 아닙니다.
처음 사용할 때 가장 많이 헷갈리는 부분은 좌표 체계입니다. bbox_coord_space: "abs_centralized"와 bbox_format: "yxyx"를 사용하면 각 박스는 캔버스 중심을 기준으로 한 픽셀 좌표 [y_min, x_min, y_max, x_max]로 작성합니다. 1024x1024 이미지라면 각 축의 범위는 -512부터 +512까지입니다. 일반적인 왼쪽 위 기준 좌표나 커뮤니티에서 사용하는 0~1000 레이아웃을 변환 없이 그대로 넣으면 안 됩니다.
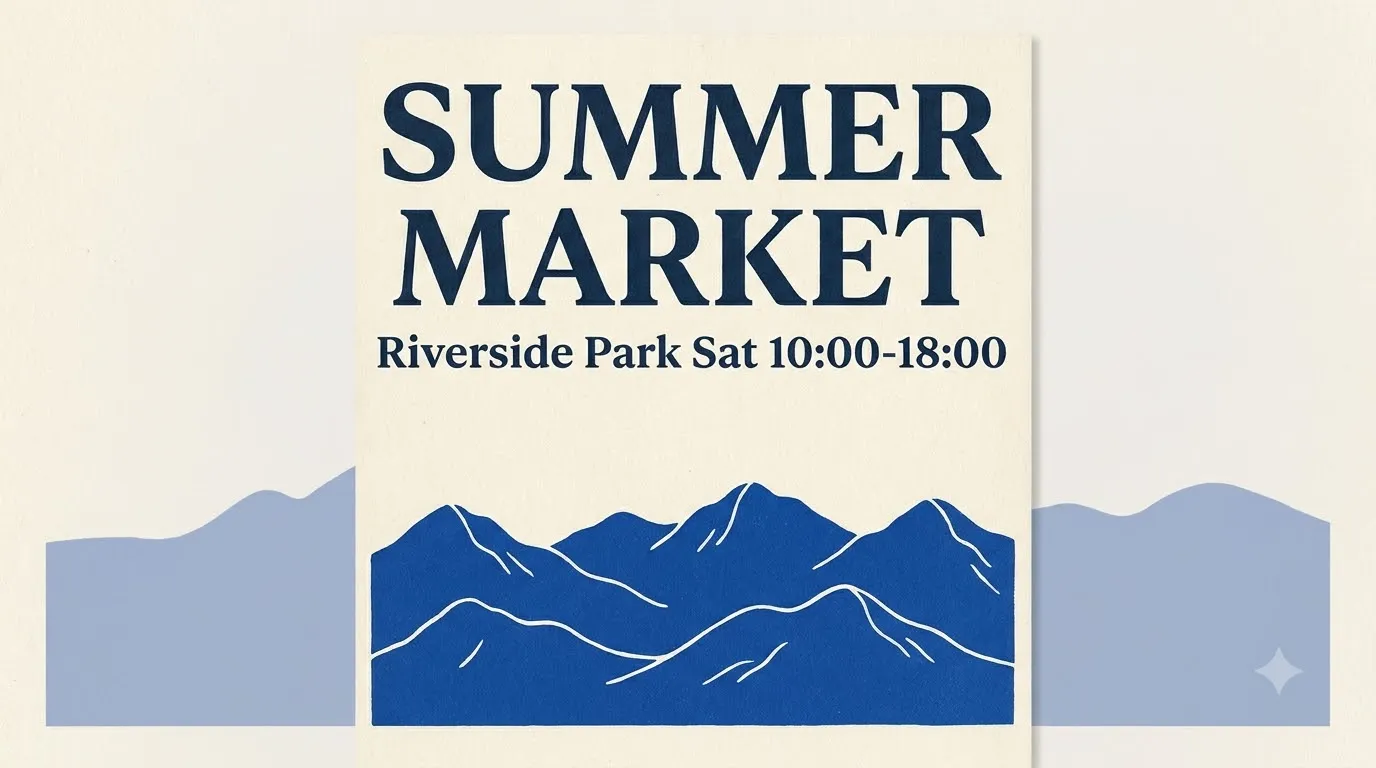
제목을 위에, 일러스트를 아래에 두는 최소 예시는 다음과 같습니다.
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
요소가 20개인 인포그래픽의 박스를 사람이 전부 직접 입력할 필요는 없습니다. 초기 사용자들이 주로 사용하는 방식은 비전 기능을 갖춘 LLM에 기획안이나 스케치를 바탕으로 JSON 초안을 만들게 한 뒤, 생성 전에 좌표를 직접 수정하는 것입니다. 일본 테스터 @chimolog7은 사람이 bbox 형식을 작성하기에는 너무 어렵다며 Opus로 JSON을 생성했다고 설명했습니다. 이후 Krea 2가 자주 일본어를 틀리는 상황에서도 일본어 렌더링의 체감 오탈자가 1%에 불과했다고 밝혔습니다(게시물).
두 번째 요령은 통제된 재생성입니다. 이 모델은 이미지 입력을 지원하지 않는 텍스트-이미지 모델이므로 사진을 img2img로 넣고 유지할 수 없습니다. 대신 한 박스의 텍스트나 위치만 바꾸고 같은 시드로 다시 생성하면 나머지 레이아웃은 대체로 유지됩니다. 사용자 @li9292는 수천 자의 중국어와 20개 박스로 구성된 주간 보고서 표지에서 이 방식을 보여줬습니다. 같은 시드를 유지한 채 한 박스만 수정했는데 나머지 레이아웃은 그대로 남았습니다(게시물). 정확한 문구가 중요한 작업에서는 스타일 프리셋보다 이 ‘한 박스 수정 + 동일 시드’ 루프가 더 유용합니다.
텍스트 렌더링 전반의 맥락은 2026년 텍스트 렌더링에 가장 적합한 이미지 모델 테스트에서도 확인할 수 있습니다. 레이아웃을 우선하는 선택지가 왜 필요했는지 잘 보여주는 비교입니다.
호출 방법과 ‘무료’의 실제 비용
호스팅 환경에서는 하나의 엔드포인트를 사용합니다. MOSI API 문서에는 moss-image-sft-1.0용 POST /v1/images/generations가 안내되어 있습니다. 입력은 텍스트, 출력은 이미지만 가능하며 이미지 입력, 오디오·비디오, 스트리밍, 비동기 작업 API는 제공하지 않습니다. 프롬프트 향상 기능은 내장되어 있지만 기본값은 꺼져 있습니다. prompt_enhance: true로 활성화할 수 있으며, 향상 모델 버전은 서버에서 선택됩니다.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
박스 단위 제어가 필요하다면 전체 JSON 레이아웃 문자열을 prompt에 넣으면 됩니다. 위의 짧은 자연어 예시는 그대로 복사해 실행하기 가장 쉬운 형태입니다.
확인 시점의 과금 상태는 Free for a limited time, 즉 0 credits였습니다. 이후의 전체 가격표로 연결되는 링크도 제공됩니다. Base와 SFT 비교 가이드 역시 같은 상황을 전합니다. 플레이그라운드는 10월 20일부터 운영 중이지만, 이미지 한 장당 지속적으로 적용될 가격은 공개되지 않았습니다. 프로토타입 단계에서는 무료 기간을 활용하되, 이후에는 제공업체 요금과 오탈자로 폐기하는 결과물의 비율까지 예산에 반영해야 합니다.
로컬 추론은 이미지당 비용이 없지만 하드웨어 비용이 발생합니다. 10월 20일 확인된 Comfy-Org 파일 목록 기준으로 환경과 캐시를 제외한 BF16 가중치는 총 약 29.72GB입니다. 백본은 약 10.16GB, 텍스트 인코더는 약 19.31GB, small VAE는 약 0.25GB입니다. INT8 ConvRot을 사용하면 트랜스포머 용량이 대략 절반으로 줄어들어 백본은 약 5.41GB, 인코더는 약 9.75GB가 됩니다. W4A8 GPTQ 인코더 옵션은 약 7.34GB 수준입니다.
| 구성 | 다운로드 항목 | 실사용 메모 |
|---|---|---|
| 전체 BF16 | 29.72GB 가중치 + 실행 메모리 | 오프로딩 없이 32GB에서도 빠듯하며 시스템 RAM과 프롬프트 길이의 영향을 받음 |
| INT8 양자화 | 약 15GB급 + 오프로딩 | 약 1MP, 배치당 이미지 한 장 기준 12GB 경로가 문서화되어 있음(여기에 인용한 커뮤니티 테스트에서 피크 약 9.7GB). 8~12GB 그래픽카드라면 여기서 시작할 것 |
| 커뮤니티 8스텝 DMD / 4스텝 | 어댑터 + 호환 워크플로 | 동일한 1MP RTX 3060 보고서에서 약 137초가 약 24초로 줄었지만, 초기 어댑터는 디테일을 잃음. 먼저 50스텝 기준선을 확보할 것 |
공식 샘플링 기준은 1024x1024에서 Euler, 50스텝, CFG 3.0, shift 5.0, 22번 레이어의 skip-layer guidance입니다. ComfyUI 네이티브 지원은 10월 16일 머지됐습니다(공지). ComfyUI를 업데이트한 뒤 템플릿에서 MOSS-Image를 검색하고, Comfy-Org 파일에 맞는 Base 또는 SFT 워크플로를 사용하세요. 플러그인 그래프와 네이티브 로더를 섞어 쓰면 안 됩니다.
여러 제공업체의 비용을 비교하고 있다면 가장 저렴한 이미지 생성 API 비교 글이 GPU 사용 시간과 폐기 결과를 포함한 비용 계산의 기준점이 될 수 있습니다.
그래도 폐쇄형 모델이 앞서는 영역
아트워크를 이 스택에 맡기기 전에 한계를 먼저 확인해야 합니다. 현재 공개 버전은 텍스트-이미지 생성만 지원합니다. 이미지 편집과 레퍼런스 이미지 입력은 없으며, 레퍼런스 기반 생성은 향후 작업으로 분류되어 있습니다. 업로드한 사진을 보존하거나 여러 장면에서 캐릭터를 동일하게 유지해야 한다면 프로덕션 편집용 Qwen Image 2.1처럼 편집 기능을 중심으로 설계된 모델을 사용하는 편이 낫습니다.
사람을 표현하는 능력과 미적 취향도 두 번째 격차입니다. 50억 파라미터 규모에서는 얼굴이 다소 평범하게 보일 수 있고, 비율이 흔들리며 손은 여느 이미지 생성 모델과 비슷한 오류를 반복합니다.
"캐릭터 비율을 잘 처리하지 못합니다. 흔히 말하는 ‘망가진 손’ 같은 문제에도 그다지 강하지 않습니다." — @SlipperyGem
인용한 실사용 테스트에서도 결과물을 배포하기 전에 같은 항목을 점검하라고 말합니다. 짧은 프롬프트, 캐릭터 이름, 작가 태그, 정확한 제약 조건은 여전히 일관성이 부족하고, 작은 글씨는 반드시 교정 과정이 필요합니다. 영어·중국어 벤치마크에 포함되지 않은 언어는 수동 확인이 필수입니다. 공식 50스텝 설정은 보급형 하드웨어에서 무겁고, 빠른 어댑터는 속도를 얻는 대신 조명 디테일과 제약 조건 준수 능력을 희생합니다. 최종 결과물을 보관할 때는 체크포인트, 인코더, VAE, 정밀도, 프롬프트, 시드, 인코딩 시간을 포함한 전체 처리 시간을 함께 기록하세요.
속도에 초점을 맞춘 로컬 서빙 결과도 하드웨어 측면에서 같은 결론을 보여줍니다. Lucebox 측정에서는 자체 커널을 사용한 Radeon AI PRO R9700이 CFG 1, 8스텝, 1024x1024에서 2.7초를 기록했습니다. 같은 설정의 DGX Spark ComfyUI보다 엔드투엔드 기준 1.8배 빨랐습니다. 하지만 자체 육안 검사에서는 CFG 1에서 8개 중 4개가 형태가 무너졌고, CFG 2.5에서는 8개 중 1개로 줄어드는 대신 5.2초가 걸렸습니다. 빠르다고 해서 자동으로 더 쓸 만한 것은 아닙니다.
MOSS Image API FAQ
MOSS Image를 상업적으로 무료로 사용할 수 있나요?
가중치와 포함된 코드는 Apache 2.0으로 공개되어 있어 라이선스 비용 없이 상업적 이용과 파인튜닝이 가능합니다. 호스팅 엔드포인트는 각자의 가격과 콘텐츠 규정을 적용하며, 서드파티 양자화 모델이나 LoRA에는 별도의 조건이 적용됩니다.
Base와 SFT 중 API에는 어떤 모델을 사용해야 하나요?
호스팅 API는 생성용으로 팀이 권장하는 파인튜닝 체크포인트인 SFT(moss-image-sft-1.0)를 제공합니다. 지금 포스터와 정보 그래픽을 만들 목적이라면 SFT를 다운로드하고, 파인튜닝이나 LoRA 학습이 목적이라면 Base를 선택하세요.
12GB VRAM에서도 실행할 수 있나요?
약 1MP 해상도와 배치당 이미지 한 장 조건에서 양자화 워크플로와 CPU 오프로딩을 사용하면, 12GB 환경에서 실행할 수 있는 구성이 문서화되어 있습니다.
사진을 편집하거나 캐릭터를 완전히 동일하게 유지할 수 있나요?
아니요. 공개된 백본은 레퍼런스 이미지 조건을 지원하지 않습니다. 수정한 JSON을 같은 시드로 다시 생성하면 레이아웃을 어느 정도 유지할 수 있지만, 업로드한 사진을 보존하거나 인물의 동일성을 보장하지는 않습니다.
다음으로 MOSS Image를 선택할 사람
| 작업 | MOSS Image를 선택할 상황 | 다른 모델을 선택할 상황 |
|---|---|---|
| 정확한 문구가 들어가는 포스터, 메뉴, 슬라이드, UI 목업 | 실사 인물보다 긴 이중언어 텍스트와 박스 단위 배치가 중요할 때 | 한 줄짜리 슬로건만 필요할 때. 폐쇄형 모델이 프롬프트 입력은 더 빠름 |
| 이커머스 또는 편집 워크플로 | LLM에서 JSON을 생성하는 단계와 교정 과정을 추가할 수 있고, 직접 호스팅하거나 파인튜닝할 Apache 2.0 가중치가 필요할 때 | 지금 당장 img2img, 인페인팅, 레퍼런스 기반 캐릭터 고정이 필요할 때 |
| 예산이 제한된 로컬 개발자 | 12GB VRAM과 양자화 구성을 받아들일 수 있거나 MOSI 무료 기간으로 프로토타입을 만들 수 있을 때 | 보장된 처리량, 스트리밍, 비동기 작업이 필요할 때. 현재 호스팅 API는 어느 것도 제공하지 않음 |
레이아웃을 직접 지정할 수 있는 텍스트 중심 디자인 작업에서 MOSS Image는 제약 조건 시스템 자체가 제품인 드문 오픈 모델입니다. 반면 얼굴을 같은 얼굴로 유지해야 하는 모든 작업에서는 MOSS Image를 대체재가 아니라 폐쇄형 이미지 모델과 함께 사용하는 타이포그래피 엔진으로 보는 편이 정확합니다.