 AIREITER
Modal 멀티노드 작업은 별도의 클러스터 구독료가 아니라 전체 리소스 할당량을 기준으로 과금됩니다. Modal Clusters는 정식 출시된 기능이지만, 실제 청구액은 각 컨테이너가 사용하는 GPU, CPU, 메모리, 스토리지와 네트워크 사용량을 합산해 결정됩니다.
1분 만에 이해하는 Modal Clusters 가격
공식 Modal 가격 페이지와 정식 출시 안내에 따르면 Modal은 사용량 기준으로 과금하며, 여러 컨테이너를 함께 실행할 때는 @modal.clustered 진입점을 사용합니다. RDMA를 선택하면 통신 경로가 달라질 뿐, 기본적인 과금 공식 자체는 바뀌지 않습니다.
GPU 수 × GPU 사용 초 × GPU 요금 + CPU 사용 초 + 메모리 GiB-초 + 스토리지 + 해당되는 데이터 전송 요금
이 공식이 중요한 이유는 클러스터를 구성할 때 노드 전체에 할당된 리소스가 그대로 곱해지기 때문입니다. 노드 4개에 노드당 H100 GPU 8개를 요청했다면, 코디네이터 1개와 ‘무료’ 워커를 따로 계산하는 것이 아니라 H100 32개에 대해 과금됩니다.
Modal Clusters가 요금표에 더하는 것
Modal은 2026년 10월 1일 정식 출시를 통해 멀티노드 실행을 관리형 기능으로 제공하기 시작했습니다. size는 컨테이너 수를 지정하고, rdma=True는 지원되는 환경에서 고속 통신 경로를 활성화합니다(Modal 공식 안내).
문서에서 설명하는 방식은 갱 스케줄링입니다. 진행 자체가 불가능한 부분 실행을 시작하는 대신, Modal은 요청된 그룹을 가능한 한 함께 배치하려고 시도합니다. 분산 학습, 파인튜닝, 모델 병렬 추론, 동기화된 GPU 통신이 필요한 프리필·디코드 구조 등이 지원 대상입니다.
클러스터 문서에는 실무적으로 알아둬야 할 제약도 나와 있습니다. GPU는 노드 전체 단위로 할당되며 CPU 전용 클러스터는 지원되지 않습니다. 컨테이너 하나가 실패하거나 프리엠션되면 클러스터 호출 전체가 실패할 수 있습니다. 반환되는 출력은 랭크 0의 결과뿐이므로, 장시간 작업은 컨테이너 외부의 저장소에 체크포인트를 남겨야 합니다.
Modal Clusters 비용을 결정하는 GPU 요금
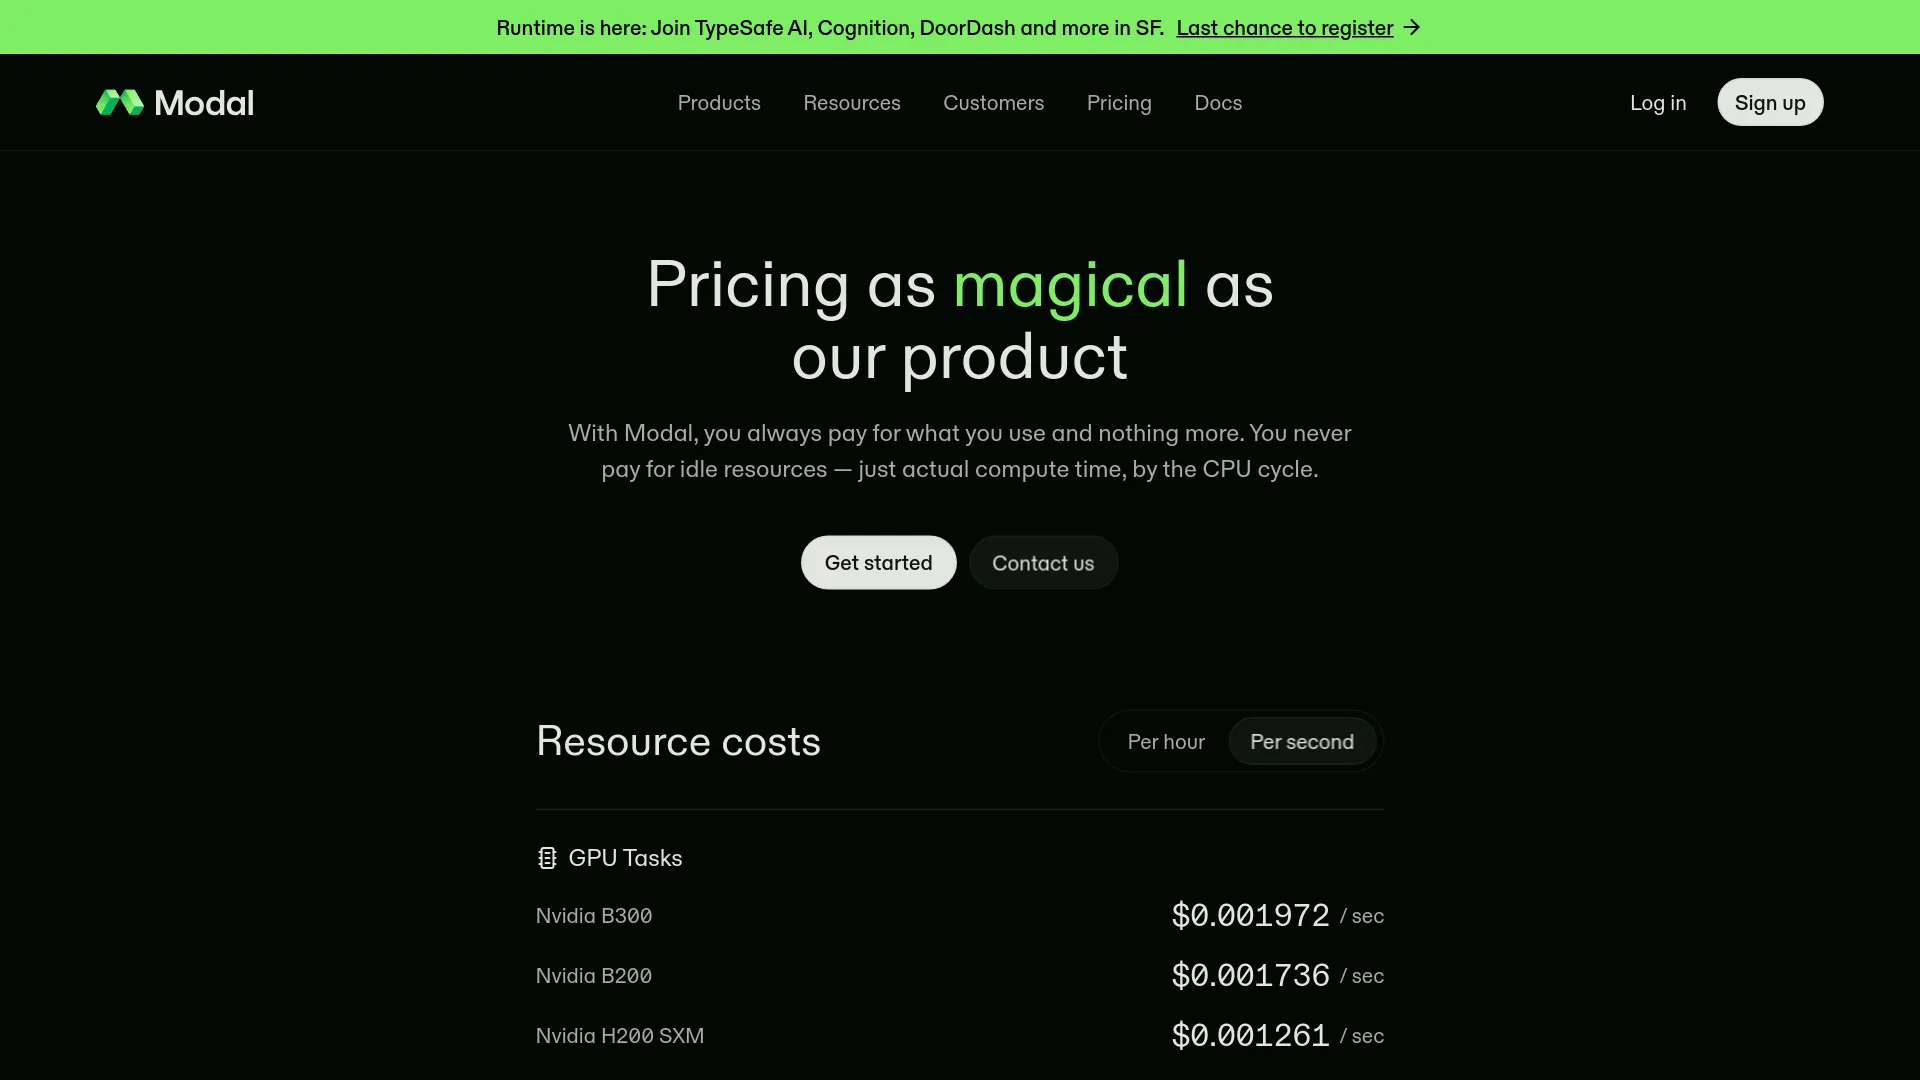
아래 공개 요금은 비용을 추산할 때 유용한 출발점입니다. 시간당 금액은 초당 요금을 기준으로 계산했으며 CPU, 메모리, 스토리지와 지역별로 적용될 수 있는 추가 배수는 포함하지 않습니다.
| GPU | 초당 요금 | GPU 1개당 시간당 요금(약) |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal은 CPU에 물리 코어 1개당 초당 $0.0000131, 메모리에 GiB-초당 $0.00000222를 부과합니다. 볼륨 스토리지는 GiB당 월 $0.09이며, 처음 1TiB는 무료입니다. 네트워크 송신은 기본 제공량을 초과하면 GiB당 $0.04로 표시되어 있습니다. 대규모 작업을 시작하기 전에는 반드시 공식 요금표에서 최신 수치를 확인하세요.
계산 예시: H100 8개를 탑재한 노드 4개
분산 학습 작업에서 size=4를 요청하고 각 노드에 H100:8을 할당한다고 가정해 보겠습니다.
- 노드 4개 × GPU 8개 = H100 GPU 32개.
- 32 × 시간당 $3.95 = GPU 비용만 시간당 약 $126.40.
- $126.40은 GPU 비용만 계산한 최저 기준입니다. CPU, 메모리, 스토리지와 데이터 송신 비용은 별도입니다.
예약형 또는 전용 용량과 비교할 때 기준으로 삼아야 할 숫자가 바로 이 값입니다. 서버리스의 장점은 작업이 끝난 뒤 클러스터를 축소할 수 있다는 데 있지, 클러스터를 가득 채워 사용해도 비용이 저렴해진다는 뜻은 아닙니다.
요금표보다 플랜 한도가 더 큰 걸림돌일 수 있다
정식 출시된 기능이라고 해서 용량이 무제한인 것은 아닙니다. Modal의 공개 워크스페이스 플랜에는 대규모 클러스터를 가격을 따지기도 전에 막을 수 있는 동시 실행 수와 플랫폼 제약이 포함되어 있습니다.
| 플랜 | 플랫폼 요금 | 포함 컴퓨팅 크레딧 | 공개된 GPU 동시 실행 한도 |
|---|---|---|---|
| Starter | 월 $0 | 월 $30 | GPU 10개 |
| Team | 월 $250 | 월 $100 | GPU 50개 |
| Enterprise | 맞춤형 | 맞춤형 | 맞춤형 / 더 높은 한도 |
H100 32개를 사용하는 실험은 이미 GPU 32개를 필요로 하므로, 동시 실행 한도가 GPU 10개인 Starter 플랜으로는 위 예시를 실행할 수 없습니다. Team 플랜은 GPU 수만 보면 가능하지만, 실제 스케줄링에는 리전 선택과 요청한 하드웨어의 가용성도 영향을 줍니다.
Starter의 $30 크레딧을 GPU 30시간 무료 이용권으로 이해해서는 안 됩니다. 표시된 H100 요금 기준으로는 다른 리소스 비용을 제외하고 약 7.6 H100 GPU-시간에 해당합니다.
Modal Clusters가 경제적으로 유리한 경우
Modal Clusters는 규모가 크고 간헐적으로 실행되며, 계속 프로비저닝해 두기에는 운영 부담이 큰 작업에서 가장 강점을 보입니다. 몇 시간 동안 실행된 뒤 사라지는 학습 작업이라면, 수주 동안 계속 돌아가는 클러스터보다 사용량에 따라 0까지 축소되는 구조의 이점을 더 크게 누릴 수 있습니다.
다음과 같은 작업에 적합합니다.
- 모든 노드가 함께 시작되어야 하는 분산 파인튜닝.
- 고가 GPU 용량이 필요한 단기 학습 작업.
- RDMA 또는 모델 병렬 처리가 필요한 멀티노드 추론.
- Kubernetes, SLURM 또는 수동 RDMA 구성을 직접 운영하고 싶지 않은 Python 팀.
모델이 한 대의 머신에 들어간다면 단일 노드 Modal 함수가 더 적합합니다. 사용률이 예측 가능하거나 고정된 SLA가 필요하거나, 지속적인 GPU-시간 비용을 가장 낮추는 것이 목표라면 전용 또는 예약형 인프라도 반드시 비교해야 합니다.
실제 사용자 의견에서도 유용한 경계선을 확인할 수 있습니다. 한 컴퓨터 비전 관련 스레드에서 u/Substantial_Camel735는 벡터 검색을 Modal 워커에서 실행하기보다 VPS에 두는 방식을 권장했습니다(Reddit 토론). 다만 이는 플랫폼 전체를 대상으로 한 벤치마크가 아니라 한 사용자의 아키텍처 선택으로 봐야 합니다.
“Modal에서 벗어나려는 중이지만 그 설계가 맞는 것 같다. 다만 검색을 Modal 워커에서 처리하지는 않을 것이다. VPS에서 벡터 DB를 대상으로 검색하게 할 것이다.” — u/Substantial_Camel735, r/computervision
대규모 작업을 시작하기 전 확인할 운영 항목
- 전체 할당량부터 곱하세요.
노드 수 × 노드당 GPU 수를 계산한 뒤 그 합계를 워크스페이스 동시 실행 한도와 비교해야 합니다. - 의미 있는 최소 규모로 먼저 테스트하세요. 2노드 테스트를 거치면 32 GPU 작업으로 비용이 커지기 전에 이미지, NCCL, 랭크와 랑데부 문제를 확인할 수 있습니다.
- RDMA와 애플리케이션 디버깅을 분리하세요. 작업이 허용한다면 먼저 RDMA 없이 분산 작업을 검증한 다음
rdma=True를 활성화하고 통신에 민감한 경로를 측정하세요. - 내구성 있는 스토리지에 체크포인트를 저장하세요. 랭크 하나가 실패하거나 프리엠션되면 전체 호출이 실패할 수 있습니다. 체크포인트 없이 재시도하면 비싼 작업 전체를 다시 실행하게 될 수 있습니다.
- CPU, 메모리와 데이터 송신 비용을 예산에 포함하세요. 특히 데이터셋이나 결과물이 리전을 넘나들면 GPU 계산 비용은 청구서의 첫 번째 항목에 불과합니다.
- 리전 고정이 필요한지 판단하세요. 배치 범위를 좁히면 사용할 수 있는 스케줄링 풀과 가격 배수가 달라질 수 있습니다. 지역성을 꼭 필요한 요구사항으로 볼지 측정으로 판단하고, 최신 리전별 가격 문서에서 확인하세요.
Modal의 공식 가격표에는 RDMA 자체에 대한 별도 요금이 표시되어 있지 않습니다. RDMA의 가치는 성능에 있습니다. 동기화된 학습이나 대규모 KV 캐시 전송은 일반 TCP 환경에서 네트워크 병목에 부딪힐 수 있습니다. 대신 RDMA를 지원하는 하드웨어와 배치 조건 때문에 가용성이 좁아질 수 있다는 점은 감안해야 합니다.
Modal Clusters FAQ
Modal Clusters API에 별도 이용료가 있나요?
공개된 별도의 클러스터 추가 요금은 없습니다. Modal은 각 컨테이너가 사용하는 GPU, CPU, 메모리, 스토리지와 해당되는 네트워크 사용량을 기준으로 과금합니다.
클러스터의 최대 규모는 얼마인가요?
정식 출시 자료에 따르면 공개 클러스터는 최대 32개 노드 또는 GPU 256개까지 지원하며, 그보다 큰 요구사항은 Modal과 별도로 조율해야 합니다(정식 출시 안내). 워크스페이스 동시 실행 한도와 실제 용량 제한은 여전히 적용됩니다.
Modal Clusters에서 추론도 실행할 수 있나요?
가능합니다. 다만 작업이 클러스터 실행 모델에 맞아야 합니다. 일반적인 HTTP 엔드포인트보다는 멀티노드 또는 모델 병렬 추론이 더 적합한 사용 사례입니다. 클러스터 웹 함수에는 요청이 랭크 0으로 전달되는 것을 포함한 제약이 있습니다(클러스터 문서).
실무적인 선택 기준
| 워크로드 | 우선 검토할 선택지 |
|---|---|
| 모델이 GPU 한 개 또는 노드 한 개에 들어가는 경우 | 일반 Modal 함수 |
| 짧고 동기화가 필요한 멀티노드 학습 작업 | 소규모 테스트 후 Modal Clusters |
| 장시간 실행되며 사용률이 예측 가능한 작업 | 전용 또는 예약형 GPU 용량과 비교 |
| GPU 추론과 가까운 곳에서 검색·데이터베이스 작업을 수행하는 경우 | 측정 결과가 함께 배치할 이유를 보여주지 않는 한 데이터 서비스를 분리 |
| 엄격한 사설 네트워크 또는 자체 호스팅 요구사항 | 다른 배포 모델 검토 |
Modal Clusters는 멀티노드 GPU 오케스트레이션을 쉽게 시작하게 해주는 기능이지, 본질적으로 더 저렴한 솔루션은 아닙니다. 서버리스 배치와 Python 중심의 개발 경험은 엔지니어링 시간을 줄여줄 수 있지만, 지속적인 사용률과 리전 제약, 전체 클러스터 재시도는 청구액을 크게 키울 수 있습니다. 먼저 전체 노드 수를 계산한 뒤, 전용 용량 대비 편의성에 지불할 비용이 타당한지 비교하세요.