 AIREITER
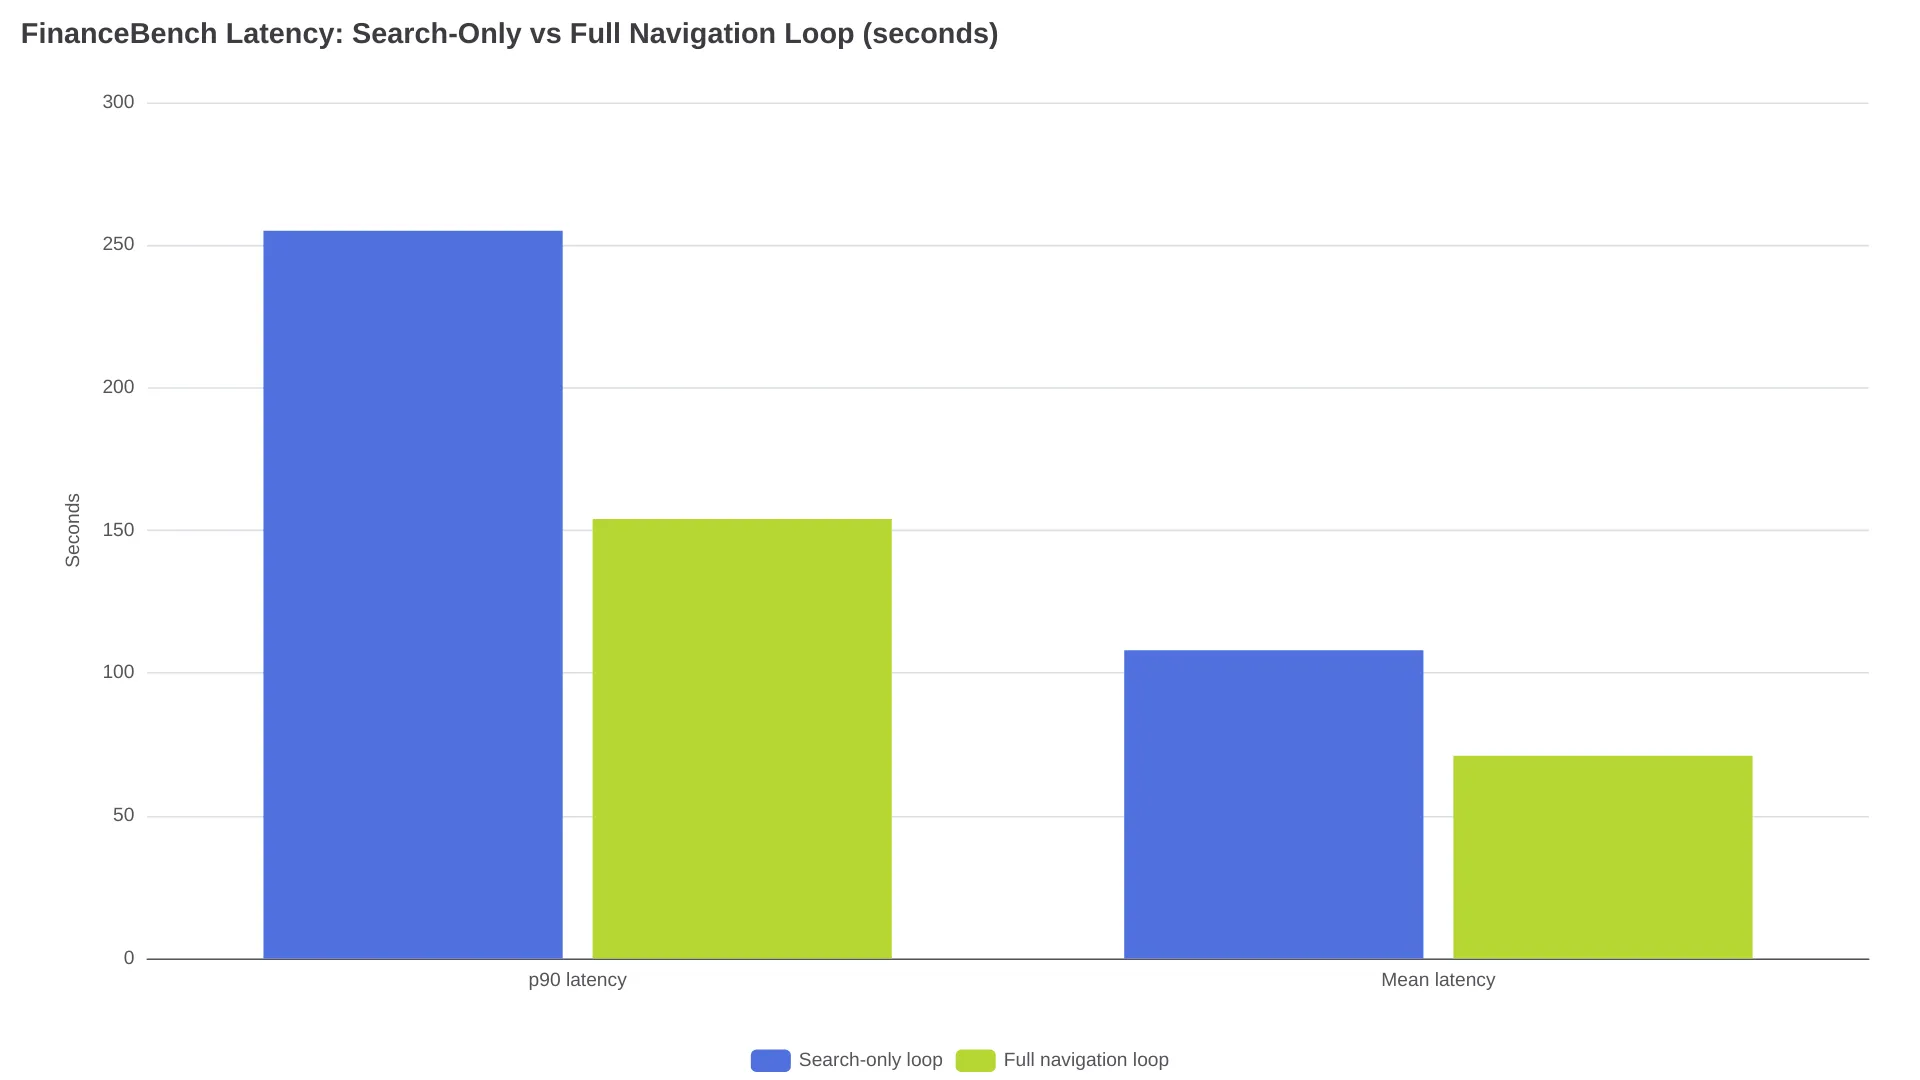
368개 SEC 공시 문서, 약 53,900페이지, 150개 질문으로 구성된 FinanceBench에서 Mistral은 새 Agentic Search 레이어가 단발성 RAG보다 답변 정확도를 크게 높였다고 밝혔다. 검색 전용 루프는 47~53%p, 전체 탐색 루프는 최대 59%p 향상됐고 토큰 사용량은 최대 약 3분의 1 줄었다. 대신 지연 시간은 감수해야 한다. 전체 루프의 p90 지연 시간은 154초, 평균은 71초다.
2026년 8월 20일 공개된 Mistral Agentic Search는 공시, 계약서, 스캔 PDF처럼 까다로운 기업 문서 컬렉션을 위한 검색 레이어다. 웹 검색을 강화한 기능이 아니라, 자체 인덱스를 더 깊게 파고드는 방식이다. 정확도를 얻는 대신 몇 분 단위의 처리 시간을 지불하는 구조라고 보면 된다.
Mistral Agentic Search의 정체
Mistral Agentic Search는 기존 인덱스 위에 다단계 검색 루프를 얹는 검색 레이어다. 2026년 8월 20일 출시됐으며, search, open, navigate, read, grep의 5개 도구를 순차적으로 활용한다. Mistral Search Toolkit에서 사용할 수 있고, Studio와 Vibe의 Libraries에도 통합돼 있다. 인덱스는 그대로 사용하며 파인튜닝도 필요 없다. 단순 청크 검색만으로는 풀기 어려운 질문을 에이전트 루프가 처리한다.
검색부터 문서 탐색까지, 5개 도구는 어떻게 움직이나
작동 방식을 이해하기 좋은 사례로 Mistral은 1953년 미국 국방비를 제시했다. 한 번의 검색 호출은 1~6월 수치만 찾아내고 7~12월 데이터를 놓쳤다. 반면 에이전트 방식은 두 차례 검색으로 treasury_bulletin_1954_02.pdf를 찾은 뒤 15페이지의 Table 3를 읽어 12개월 전체 수치를 확보했다. 그 결과 연간 합계는 44,463 million dollars로 계산됐다.
| 도구 | 역할 |
|---|---|
search | 인덱스에서 가능성 높은 출처를 검색한다 |
open | 찾아낸 문서를 연다 |
navigate | 문서 안의 페이지, 표, 섹션으로 이동한다 |
read | 해당 위치의 내용을 추출한다 |
grep | 정확한 토큰, 코드, 식별자를 패턴으로 찾는다 |
단발성 RAG는 정해진 청크 묶음을 가져온 뒤 한 번에 답해야 한다. 검색 결과가 부실해도 다른 문서를 추가로 요청할 수 없다. 반대로 이 루프는 출처를 비교하고, 각주와 표의 참조를 따라가며, 불완전한 결과를 보완할 수 있다. Mistral의 주장은 단순하다. 더 많은 재시도와 턴을 쓰는 것이 아니라, 낭비되는 재시도와 턴을 줄이는 방식이라는 것이다.
벤치마크 결과에서 실제로 확인되는 것
발표에는 두 가지 벤치마크가 담겼다. 둘 다 기본 Search Toolkit 설정으로 튜닝 없이 수행한 벤더 자체 보고 결과이며, Mistral은 이를 "these results are floors, not ceilings."라고 설명한다. FinanceBench(Islam et al., 2023, GitHub 공개)는 SEC 10-K, 10-Q, 8-K 공시 368개를 사용한다. Mistral 집계로 문서당 약 147페이지이며, 150개 질문의 평가는 사람 라벨로 보정한 LLM 판정 방식으로 이뤄졌다.
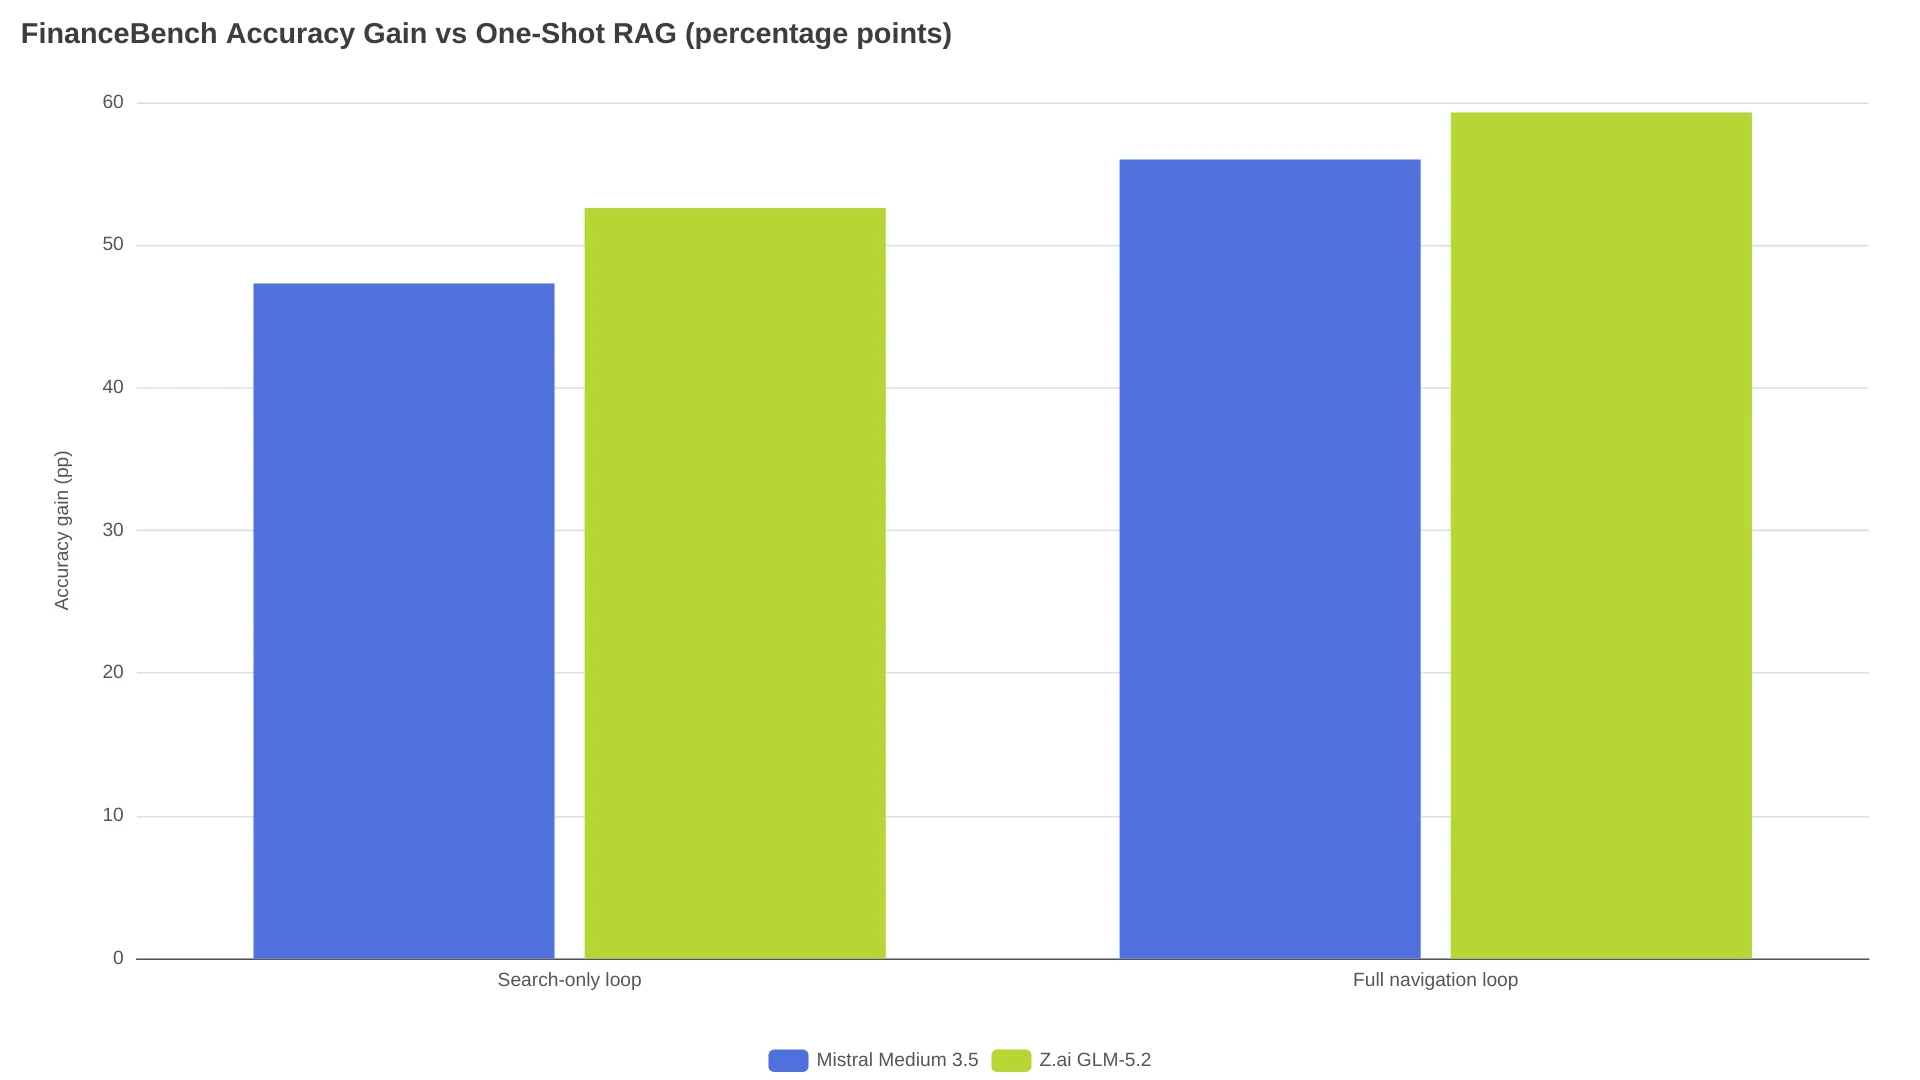
검색 전용 루프에 open, navigate, read, grep를 더한 전체 탐색 루프는 Mistral Medium 3.5에서 추가로 +8.7%p, GLM-5.2에서 +6.7%p를 기록했다. 검색 전용 루프와 비교하면 전체 탐색 루프의 토큰 사용량은 Mistral Medium 3.5에서 23.9%, GLM-5.2에서 33.7% 적었다. 지연 시간도 같은 방향으로 개선됐다. p90은 255초에서 154초로, 평균은 108초에서 71초로 줄었다. 여기서 비교 대상은 단발성 RAG가 아니라 검색 전용 에이전틱 루프라는 점을 구분해야 한다.
더 어려운 테스트는 OfficeQA Pro다. 표가 많은 스캔형 미국 재무부 Bulletin 696개, 약 89,000페이지, 질문 133개로 구성된다. GLM-5.2는 전체 루프에서 51.9% 정확도를 기록했고, 이는 단발성 기준선 6.3%를 의미하는 +45.6%p 상승이다. Mistral Medium 3.5는 +27.1%p 개선됐다. 탐색 기능을 추가하면 턴 수도 최대 7.0% 줄었다.
Mistral은 자사 Mistral Medium 3.5와 서드파티 Z.ai GLM-5.2로 테스트했으며, 두 모델 모두 같은 패턴의 개선을 보였다. 발표에는 Kimi 연구 결과도 인용된다. 해당 내용에 따르면 GLM-5.2는 Claude Code 하니스에서 OfficeQA Pro 41.4%, Mistral 하니스에서 51.9%를 기록했다. 다만 Kimi의 1차 출처 링크는 제공되지 않았으므로, 10.5%p의 하니스 차이는 Mistral의 설명으로 봐야 한다. Mistral은 이를 바탕으로 "retrieval quality scales with model capability,"라고 결론 내리며, 병목은 모델이 아니라 하니스에 있다고 주장한다.
단발성 RAG가 더 나은 경우
Mistral도 인덱스 기반 검색이 여전히 토대이며, 첫 검색 결과가 부족할 때 에이전틱 루프를 쓰는 것이라고 설명한다. 결국 문서의 형태와 허용 가능한 지연 시간이 선택 기준이다.
| 업무 유형 | 우선 선택할 방식 |
|---|---|
| 짧고 정돈된 문서에서의 직접 조회 | 단발성 RAG |
| 대량의 키워드 또는 의미 기반 검색 | 단발성 RAG |
| 답이 이미 알려진 위치에 있는 경우 | 단발성 RAG |
| 표와 각주가 많은 공시, 계약서, 매뉴얼 | Agentic Search |
| 표가 많은 스캔 PDF | Agentic Search |
| 여러 문서에 흩어진 답을 대조·정리해야 하는 경우 | Agentic Search |
| 수 초 단위의 인터랙티브 응답이 필요한 경우 | 단발성 RAG |
제품이 p90 154초를 감당하지 못한다면, 정확도가 아무리 올라도 해결책이 될 수 없다. 다만 재무제표를 일괄 분석하는 작업이라면 이야기가 달라진다.
Agentic Search와 web_search는 다른 제품이다
이 제품을 검색하면 Google은 Mistral의 websearch documentation을 함께 보여준다. 하지만 이는 별개 기능이다. web_search와 web_search_premium는 Agents API에 속한 실시간 웹 검색 도구로, 인용을 포함한 웹 검색을 수행한다. Mistral의 API 가격 페이지 기준 모델 토큰 비용 외에 각각 호출 1,000건당 $30, $50가 부과된다. Agentic Search는 정반대 방향이다. 공개 웹을 조회하지 않고, 자체 인덱스에 담긴 코퍼스를 탐색한다. 두 기능은 해결하는 문제가 다르며, 공개된 가격이 있는 쪽도 하나뿐이다. 발표 어디에도 Agentic Search의 요금은 나오지 않는다.
시작하는 방법은 두 가지
- Search Toolkit. 수집, 임베딩, 인덱싱을 위한 오픈 모듈이다. 클라우드 또는 온프레미스 환경에 배포할 수 있으며, 파서, 청킹, 임베딩 모델, Vespa 스키마, 랭킹 프로필, 하이브리드 검색을 구성할 수 있다.
- Studio 및 Vibe Libraries. 관리형 경로다. Search Starter App을 이용하면 기본 설정으로 코퍼스의 로컬 인덱스를 만들 수 있다. 무엇을 튜닝하기 전에 벤치마크 구성을 가장 빠르게 재현하는 방법이다.
어느 경로를 선택하든 대표 질문을 단발성 RAG와 전체 루프 모두에 실행한 뒤, 도입 전에 답변 품질과 토큰 사용량, p90 지연 시간을 비교하는 것이 좋다.
출시 시점에도 남아 있는 변수
Mistral은 Agentic Search의 가격을 공개하지 않았고, 벤치마크 수치도 벤더 자체 보고다. 출시 시점에는 독립적인 실사용 재현 결과도 없었다. 초기 공개 반응은 첫인상 수준이다.
"mistral just added agentic search to their api is the right move. wrapping perplexity-style search into a native agent tool saves us from writing fragile web-scraping pipelines and managing proxy rotation ourselves." — @AbdoKerdawy, AI 제품 개발자 (X)
토큰 절감 주장에는 Mistral의 발표만으로 충분히 해소되지 않은 반론도 나왔다.
"The Mistral agentic search retrieval tool claims to cut single-pass search failures by over 40%. If it bypasses database lookups, will it reduce the number of tokens you need to spend?" — @therawlogs, 독립 블로거 (X)
공식 답변은 검색 전용 루프 대비 24~34%의 토큰 감소다. 이 결과가 벤치마크 코퍼스 밖에서도 유지되는지는 공개 FinanceBench 세트로 독립 재현을 해봐야 확인할 수 있다.
인접 제품도 같은 물리적 제약을 안고 있다. Mixedbread의 Toast-1 에이전틱 검색 모드는 루프를 최대 4라운드, 병렬 검색 호출을 8회로 제한하며, 자체 문서에서도 단일 검색보다 느리다고 명시한다. 이 분야의 벤더가 정확도를 위해 치르는 비용은 지연 시간이다.
핵심 질문과 답변
Mistral Agentic Search는 Agents API에서 사용할 수 있나?
아니다. Mistral Search Toolkit과 Studio, Vibe의 Libraries를 통해 제공된다. Agents API의 web_search는 별도의 실시간 웹 검색 제품이며 가격 체계도 다르다.
Agentic Search는 정말 토큰 사용량을 줄이나?
공식 벤치마크에 따르면 FinanceBench에서 전체 탐색 루프는 검색 전용 에이전틱 루프보다 토큰을 23.9~33.7% 적게 사용했다. 아직 독립 재현 결과는 공개되지 않았다.
Agentic Search는 어떤 모델에서 작동하나?
Mistral은 Mistral Medium 3.5와 Z.ai GLM-5.2를 테스트했고, 두 모델에서 일관된 개선을 확인했다. 이 레이어는 파인튜닝 없이 사용할 수 있는 모델 비종속형 구조라고 설명한다.
Mistral Agentic Search의 가격은 얼마인가?
Agentic Search 자체의 가격은 공개되지 않았다. Mistral 가격 페이지의 호출 1,000건당 $30은 기존 web_search 에이전트 도구의 요금이다.
결국 남는 선택지는 명확하다. 이는 몇 분의 시간을 들여 정확도를 사는 기술이다. 공시, 계약서, 스캔된 정부 기록을 대상으로 한 일괄 작업이라면 OfficeQA Pro와 FinanceBench 전체 루프에서 각각 +45~+59%p의 정확도 향상, 그리고 더 느린 루프 대비 약 3분의 1의 토큰 절감은 합리적인 교환일 수 있다. 하지만 사용자 대면 서비스에서는 평균 71초 지연 시간이 여전히 탈락 조건이다. 또한 Mistral 외부에서 FinanceBench를 다시 실행하기 전까지, 이 글에서 가장 강력한 수치는 결국 벤더가 제시한 수치로 남는다.
관련 글: GLM-5.2 API guide와 GLM-5.2 review에서 Mistral 테스트에 사용된 두 번째 벤치마크 모델을 다룬다.