 AIREITER
Gemini 4 Carbon은 아무 작업에나 꺼내 들 모델이 아니다. 하룻밤 돌려도 남는 멀티 에이전트 리팩터링, 200개 뷰 문서 구축, 익스플로잇 검증부터 패치까지 이어지는 반복 작업처럼 긴 검증 루프가 필요한 일에 써야 한다. Google도 대다수의 소프트웨어 엔지니어링과 지식 업무에는 Gemini 4 Argon이 여전히 이상적인 선택이라고 밝힌다. Carbon은 더 많은 토큰을 쓰는 대신, 가장 어려운 작업을 맡는 모델이다.
Gemini 4 Carbon은 Gemini 4 Argon을 기반으로 한 최전선 추론 모델이다. Google은 2026년 10월 28일 Carbon을 발표했고, 2026년 11월 10일 정식 출시했다. DeepMind 모델 카드에 따르면 지식 컷오프는 2026년 3월이며, 입출력을 합쳐 최대 100만 토큰을 지원한다. 텍스트·문서·이미지·오디오·비디오를 입력받고 텍스트로 출력한다.
지금 Carbon을 쓸 수 있는 사람
Gemini 4 Carbon의 접근 경로는 채널별로 나뉘며, 일반 소비자에게는 가장 제한적이다. 개발자는 Google AI Studio의 유료 Gemini API 티어와 Android Studio, 기업용 Gemini에서 사용할 수 있다. 소비자는 Google AI Ultra 구독자에 한해 Gemini 앱, Search의 AI Mode, Google Antigravity에서 Carbon을 쓸 수 있다. 과학자는 Antigravity 최고 사용량 티어를 6개월간 무료로 신청할 수 있고, 검증된 방어 담당자는 Fairwind Program을 통해 신청할 수 있다.
Google AI Pro 구독자는 소비자용 서비스에서 Carbon을 이용할 수 없다. 이 제한은 r/GeminiAI 출시 스레드에서도 반복적으로 지적됐다.
"ULTRA에서만 쓸 수 있어요. Pro의 Argon은 두 프롬프트 만에 끝납니다." — r/GeminiAI의 u/Nodayssoff
연결된 출시 자료에는 소비자용 고정 할당량, Pro 티어 제공 날짜, 국가별 동일 제공 여부가 명시되지 않았다. 접근 스레드와 할당량 스레드의 이용자들은 5시간·주간 한도가 몇 번의 프롬프트 만에 소진됐고, 한 서비스에서는 작동하던 키가 Antigravity에서는 막혔다고 보고했다. 출시 첫날에는 An internal error has occurred 오류도 있었다. Ultra는 무제한 Carbon 요금제가 아니라 테스트용 좌석으로 예산을 잡는 편이 맞다.
Carbon과 Argon, 핵심 차이 한눈에 보기
Gemini 4 Carbon과 Gemini 4 Argon은 정가와 컨텍스트 크기가 같다. 실제 차이는 성능, 지연 시간, 그리고 토큰 소비량에서 난다.
| 항목 | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| 기반 | Argon 기반, 어렵고 긴 작업에 더 많은 추론 적용 | 기본 최전선 모델, 일상적 엔지니어링의 기본 선택 |
| 정식 출시 | 2026년 11월 10일 | ToolColumn 비교 기준 2026년 10월 13일 |
| API 모델 ID | 호출 시점에 AI Studio에서 확인, 출시 게시물에는 별도 고정 ID 없음 | ToolColumn 비교 기준 gemini-4-argon |
| API 정가, 2026년 11월 30일까지 도입가 | 입력 100만 토큰당 $2 / 출력 $10, 캐시 입력 $0.10 | 입력 100만 토큰당 $2 / 출력 $10, 캐시 입력 $0.10 |
| API 정가, 2026년 12월 1일부터 | 입력 100만 토큰당 $4 / 출력 $20 | 입력 100만 토큰당 $4 / 출력 $20 |
| 컨텍스트 | 입력+출력 합산 최대 100만 토큰 | ToolColumn 비교 기준 1,048,576토큰 |
| 입력 모달리티 | 텍스트, 문서, 이미지, 오디오, 비디오 | Artificial Analysis 기준 텍스트, 이미지 |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| 인덱스 작업당 가중 비용 | $7.76 | $9.95 |
| 출력 속도 | 82 tok/s | 68 tok/s |
| 첫 답변 토큰까지 걸리는 시간 | 67.54초 | 40.02초 |
| Thinking 레벨 | 설정 가능, 높은 레벨일수록 토큰 소비 증가 | ToolColumn 비교 기준 Low / Medium / High, 기본값은 Medium |
가격은 Google의 출시 안내에서, 속도·지연 시간·작업당 비용·모달리티 차이는 Artificial Analysis의 Carbon vs Argon 비교에서 가져왔다. 캐시 입력은 정가에서 95% 할인되므로, 도입가 기준 100만 토큰당 $0.10이다.
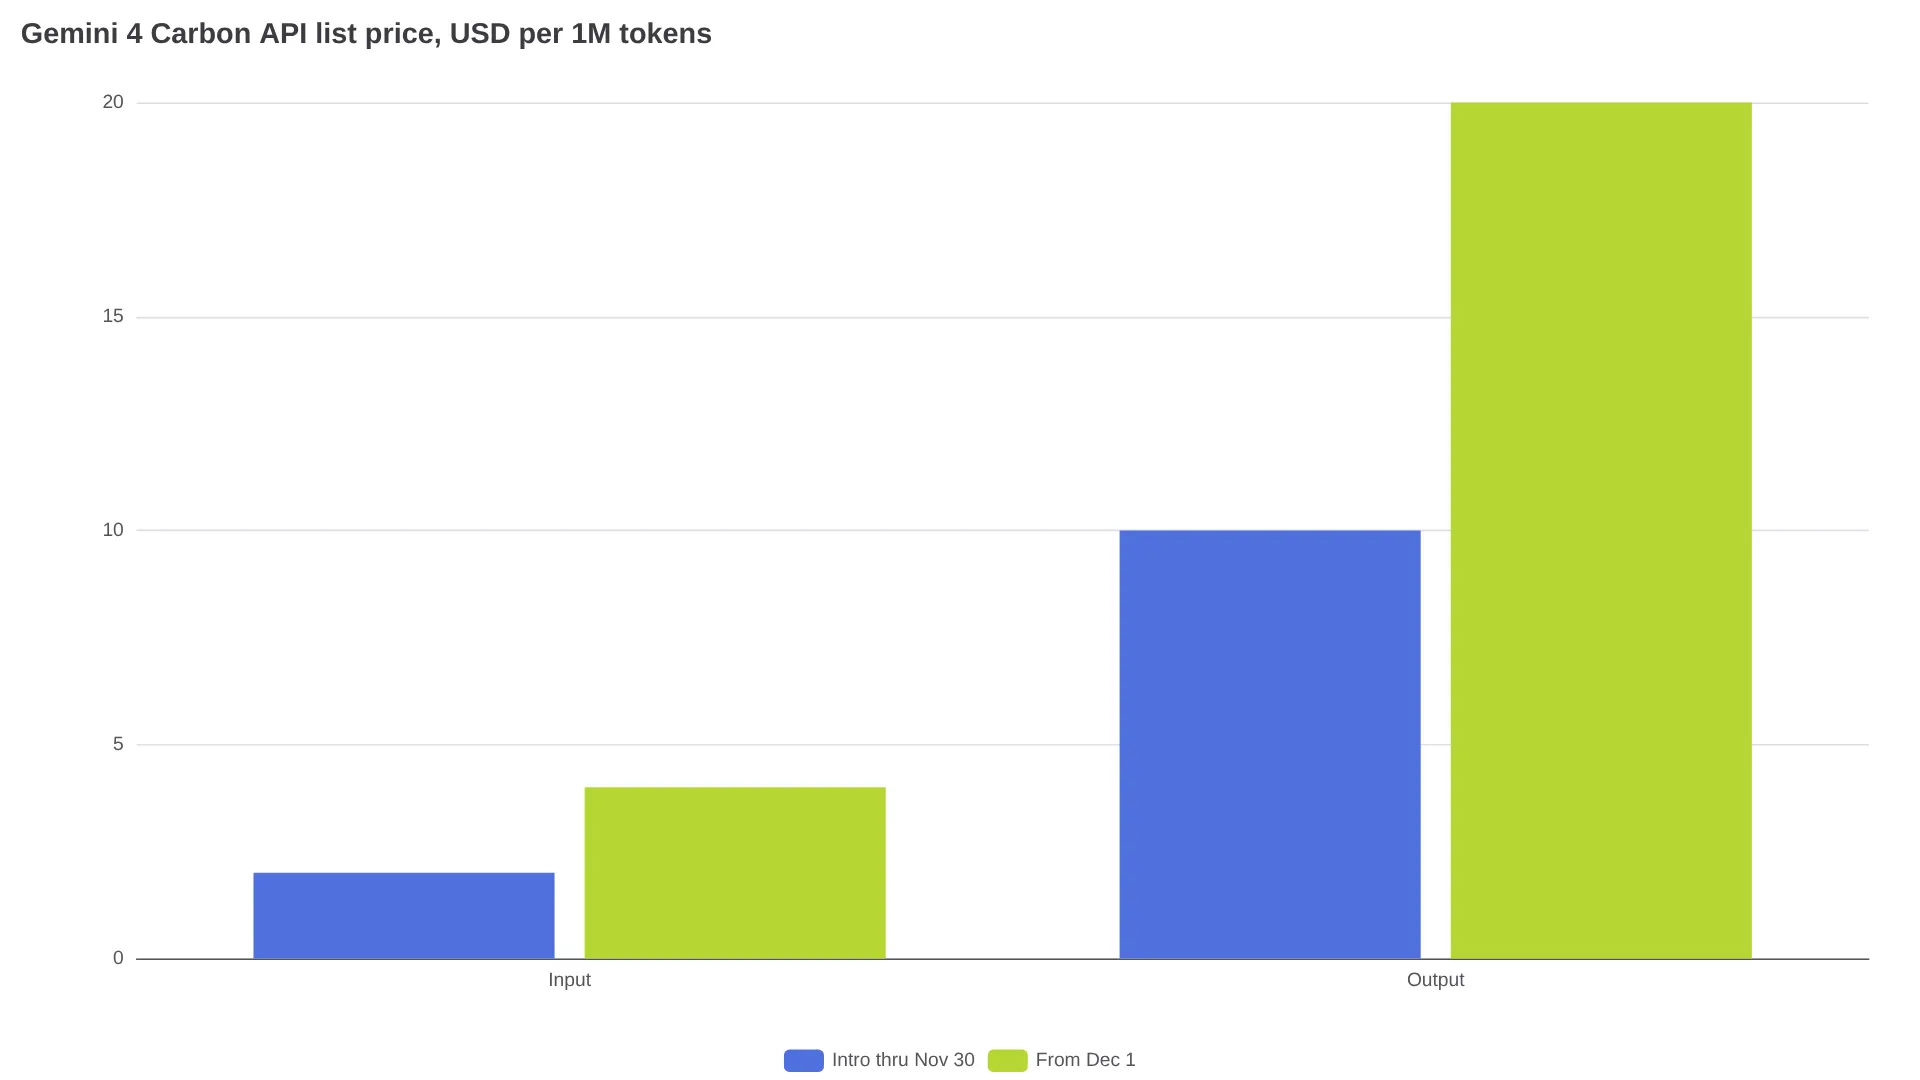
정가는 같지만 워크로드 비용은 다르다. Artificial Analysis는 Carbon이 작업당 평균 약 7,000개의 출력 토큰을 더 생성하는데도, 가중 Intelligence Index 작업당 비용이 $7.76으로 Argon의 $9.95보다 낮다고 기록한다. Carbon은 가중 작업을 24.9분에 끝내며 Argon의 28.6분보다 빠르다. 반면 첫 답변 토큰까지는 Carbon이 67.54초, Argon이 40.02초로 Carbon이 더 오래 기다리게 한다. Carbon은 첫 반응은 느리지만 오래 붙잡고 돌리는 작업에는 더 강하다.
Carbon이 앞서는 작업, 그렇지 않은 작업
Google은 17개 평가 결과를 공개했다. 아래는 Carbon과 Argon을 직접 비교한 주요 항목이다. Gemini 4 Carbon은 17개 항목 모두에서 Gemini 4 Argon을 앞섰고, 5개 모델 전체 비교에서는 15개 항목 1위를 차지했다. 다만 두 가지 예외는 중요하다. FrontierSWE 2에서는 GPT-6 Astra가 Carbon의 61.2%보다 높은 65.5%를 기록했고, OSWorld-2.1 offline에서는 Claude Opus 5.5가 Carbon의 81.5%를 넘어선 87.2%였다.
| 워크로드 | 벤치마크 | Carbon | Argon | 차이 |
|---|---|---|---|---|
| 에이전트 코딩 | SWE-sweep | 9.6% | 4.3% | +5.3%p |
| 에이전트 코딩 | Terminal-Bench 4.0 | 65.2% | 57.1% | +8.1%p |
| 에이전트 코딩 | FrontierSWE 2 | 61.2% | 55.0% | +6.2%p, Astra에는 뒤짐 |
| 컴퓨터 사용 | Agents' Last Exam v1.1 | 77.4% | 69.0% | +8.4%p |
| 컴퓨터 사용 | OSWorld-2.1 offline | 81.5% | 74.7% | +6.8%p, Opus 5.5에는 뒤짐 |
| 지식 업무 | AutomationBench, Zapier | 53.9% | 51.3% | +2.6%p |
| 지식 업무 | Vending-Bench 2 balance | $16,484 | $13,718 | 시뮬레이션 잔액 +$2,766 |
| 롱 컨텍스트 | GraphWalks 256K-1M BFS F1 | 96.2% | 84.2% | +12.0%p |
| 과학 | Terminal-Bench-Science 0.1 | 64.8% | 52.9% | +11.9%p |
| 과학 | RiemannBench | 80.0% | 76.0% | +4.0%p |
| 사이버 | ExploitGym | 54.8% | 42.0% | +12.8%p |
| 사이버 | SEC-bench Pro | 88.2% | 83.4% | +4.8%p |
| 사이버 | CWE-bench | 71.0% | 68.0% | +3.0%p |
모든 수치는 2026년 10월 기준 DeepMind 모델 카드 표에서 가져왔다. 사이버 보안 항목은 일반 제품 동작이 아니라 가드레일이 없는 Fairwind 접근 환경을 반영한다. 같은 모델 카드에는 Chartography(72.5% vs 71.6%), Vals Index(70.4% vs 69.2%), AA Index v5.0(59 vs 50), Blueprint-Bench 2 similarity(58.6% vs 54.4%)도 추가로 실려 있으며, 이로써 17개 항목이 완성된다.
- 가장 어려운 기술 워크로드: 익스플로잇 검증, 256K~1M 그래프 검색, 터미널 과학, 여러 단계의 터미널 코딩에서 Carbon의 우위가 가장 크다.
- 일상적인 지식 업무: 차트 해석, 일반 평가, 오피스 자동화에서는 격차가 1~3포인트로 줄어든다.
- 정직성 및 안전성: Google은 Carbon 소개 게시물에서 에이전트 정직성 평가 375개 작업의 통과율이 Carbon 92%, Argon 70%였다고 밝혔다. 간접 프롬프트 인젝션 성공률은 Carbon 0.0%, Argon 0.7%였고, 근거 없는 주장도 대략 절반 수준으로 줄었다.
Artificial Analysis에서는 Carbon이 Intelligence Index의 9개 구성 항목 모두에서 앞섰다. 특히 물리 추론과 오픈 리포지터리 엔지니어링에서 차이가 컸으며, FrontierCode 2.0은 Carbon 40.6%, Argon 25.7%였다. Google의 출시 안내는 CursorBench 4.0, Perplexity WANDR, Zapier AutomationBench에서 Carbon이 1위를 차지했고, 차상위 외부 모델보다 작업당 비용이 2배 이상 낮았다고도 별도로 주장한다.
Carbon에 맡길 일과 Argon에 남길 일
검증 루프 자체가 비용을 상쇄하는 작업에는 Gemini 4 Carbon을 쓰자. Google의 출시 안내에 나온 200개가 넘는 PDF 도면 뷰에서 Three.js를 재구축하는 10회 반복 야간 작업, 멀티 에이전트 /swarm 물리 빌드가 대표적이다. 아래의 커뮤니티 사례는 더 작은 규모에서 같은 패턴을 보여 준다.
"Gemini 4 Carbon으로 밖에 나가 풀도 밟아 봤습니다. 게임 엔진이나 3D 라이브러리 없이 CUDA와 C++만으로 이 초원을 처음부터 만들었어요. 풀잎과 야생화 5만 2,000개를 넣었고, 결국 같은 돌풍이 오디오도 [구동하도록] C++에서 바람 소리까지 합성했습니다." — X의 @GlitterPixely
일상 업무는 Gemini 4 Argon에 남겨 두는 편이 낫다. Carbon의 측정상 우위가 가장 작은 영역은 차트 해석과 오피스 자동화다. 따라서 단일 파일 수정, 표준 CRUD 작업, 스키마가 고정된 스프레드시트는 Argon에서 시작하자. Carbon보다 첫 토큰이 빠르고 토큰 소비도 적다. 짧은 스토리 작업에서 High thinking은 토큰을 빠르게 태운다. 한 OpenRouter 보고는 High 설정에서 4,000자 스토리에 약 6,000 thinking 토큰이 들었다고 전했다.
실전 설정은 이렇다. 새 에이전트는 먼저 Argon Medium으로 시작해 프롬프트, 할당량, 도구 권한을 검증한다. 이후 실패한 긴 꼬리 작업만 Carbon으로 넘긴다. 패키지를 가로지르는 마이그레이션, 여러 하위 시스템에 걸친 근본 원인 추적, 도면과 표를 포함한 10만 토큰 이상 문서 세트, Google의 출시 안내에서 내부적으로 스캔 재현율 100%, 분류 정밀도 95%를 기록했다고 한 Fortify식 스캔·분류·수정 루프가 여기에 해당한다. /swarm에서는 Carbon에 아키텍트, 조정자, 적대적 검증자 역할을 맡기고 가벼운 모델에는 병렬 워크스페이스를 돌리는 방식이 좋다. Carbon 실행에서 내부 오류가 반복되면 thinking 레벨을 올리기 전에 새 세션에서 재시도하자. 출시 첫날 스레드에도 원인이 불분명한 오류 제보가 있다.
12월 1일 이후 Carbon 예산 잡는 법
12월 1일 API 정가가 두 배로 오르면, 리포지터리·도면·도구 출력을 재사용하기 위한 적극적인 입력 캐싱(정가의 95% 할인)이 가장 중요한 절감 수단이 된다.
정가만 보고 예산을 계산하면 안 된다. Carbon은 측정된 작업당 출력 토큰을 더 많이 생성한다. 따라서 월간 입력 5,000만 토큰과 출력 500만 토큰을 쓴다면, 어느 모델이든 Carbon의 추가 thinking을 제외하고 정가 기준 도입 기간 $150에서 도입 기간 이후 $300으로 두 배가 된다. 그럼에도 Artificial Analysis에서 Carbon의 완료된 가중 Intelligence Index 작업당 비용이 더 낮은 이유는 재시도가 줄고 지속 처리량이 빨라져 토큰량을 상쇄하기 때문이다. 기준은 간단하다. Carbon이 8~13포인트 앞서는 익스플로잇 체인과 터미널 과학에는 High thinking을 쓰고, 격차가 1~3포인트인 문서와 UI 마무리에는 Medium 또는 Low를 쓴다.
더 자세한 항목별 계산은 사이트의 Gemini 4 Carbon API 가격 리뷰를 참고하면 된다.
Gemini 4 Carbon FAQ
Google AI Pro에도 Carbon이 제공될까?
연결된 자료에는 Pro 제공 날짜가 없다. Argon을 계속 쓰고, Ultra는 단기 Carbon 테스트 좌석으로 보는 편이 좋다.
비용을 좌우하는 thinking 레벨은 무엇인가?
Medium은 프롬프트 검증용이고, High는 8포인트 이상 차이가 나는 익스플로잇 체인과 터미널 과학에 쓴다.
Carbon과 Argon은 할당량을 공유하나?
공유 할당량을 명시한 확정 문서는 없다. 서비스별로 실시간 계정 한도를 확인해야 한다. 100만이라는 숫자는 사용량 할당량이 아니라 컨텍스트 용량이다.
한 표로 정리한 선택 기준
| 작업 유형 | 선택 | 이유 |
|---|---|---|
| 이번 주 배포해야 하는 일상 코드와 문서 | Argon Medium | 1~3포인트 차이, 더 빠른 첫 토큰, 낮은 소비량 |
| 여러 날 걸리는 마이그레이션, 10만 토큰 이상 리포지터리+도면 | Carbon, 안정화되면 Medium으로 낮추기 | 터미널·롱 컨텍스트에서 +8~12포인트 |
| 오픈소스 취약점 스캔, 분류, 패치 | Fairwind/API를 통한 Carbon | 모델 카드 기준 ExploitGym +12.8포인트, 보안 코드 비율은 Argon의 2배 이상 |
| 차트가 포함된 금융·법률 문서 에이전트 | Argon부터, 이견이 있는 수치에만 Carbon | 출시 안내 기준 Carbon은 Multimodal Knowledge Agent 2위이며 선두보다 작업 비용이 6배 낮지만, AutomationBench에서는 Argon과 차이가 작음 |
| 주간 할당량이 빠듯한 Ultra 구독자 | 일상 작업은 Argon, 어려운 한 번의 실행에 Carbon | 일부 사용자는 몇 번의 프롬프트만으로 Carbon 할당량이 소진된다고 보고 |
Carbon은 기본값으로 돌릴 모델이 아니라, 어려운 작업 단위로 빌려 쓰는 전문 모델이다. 일상 대기열은 Argon에 맡기고, 검증 루프와 익스플로잇부터 패치까지의 깊이가 결과를 좌우할 때만 Carbon이 12월 정가의 값을 한다.