 AIREITER
원본 facebookresearch/demucs 저장소는 2025년 1월 1일부터 읽기 전용으로 전환됐습니다. 그래도 Demucs는 여전히 자신의 컴퓨터에서 돌릴 수 있는 무료 음원 분리 도구 가운데 가장 강력한 선택지 중 하나입니다. 다만 v4.1.0이 올라온 포크에서 설치해야 하고, 기타와 피아노에서는 가장 먼저 한계를 드러낸다는 점은 감안해야 합니다.
보관된 저장소가 아니라 유지보수 중인 Demucs 저장소에서 시작하기
GitHub에는 같은 README를 공유하는 Demucs 저장소가 두 곳 있지만, 지금도 수정 사항이 반영되는 곳은 하나뿐입니다. facebookresearch/demucs는 보관 처리된 읽기 전용 저장소이며, README에서도 다른 저장소를 안내합니다. 현재 공식 유지보수 저장소는 adefossez/demucs입니다. 개발자 Alexandre Défossez는 이곳을 “Meta를 떠나 Kyutai에 합류한 지금, 공식적으로 유지보수되는 Demucs”라고 설명하면서도 “답변이 느리고 당분간 새 기능은 없을 것”이라고 덧붙였습니다.
이 차이는 저장소 URL만 바꾸면 끝나는 문제가 아닙니다. 설치 명령 자체가 달라집니다.
v4.1.0에서 달라진 점
11/07/2026 날짜의 릴리스 노트에는 Demucs v4.1.0의 변경점으로 “패키징 현대화, 더 가벼워진 추론 의존성, 다양한 버그 수정, Hugging Face에 호스팅되는 사전 학습 모델”이 적혀 있습니다. 실제 사용에서 달라지는 부분은 다음과 같습니다.
| 항목 | 보관된 저장소 | 유지보수 저장소 (v4.1.0) |
|---|---|---|
| 최소 Python 버전 | 3.8 | 3.10 |
| 가장 빠른 실행 방법 | pip install -U demucs | uvx demucs MY_TRACK.mp3 (설치 과정 없음) |
| 영구 설치 | pip install -U demucs | uv tool install demucs (pip도 여전히 사용 가능) |
| ffmpeg | 필수 | 선택 사항. FLAC 출력과 sphn이 디코딩하지 못하는 형식에 필요 |
| 양자화 모델 | 포함 | 추가 옵션 필요: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| 가중치 호스팅 | dl.fbaipublicfiles.com | Hugging Face |
버그를 신고하기 전에 알아둘 함정도 있습니다. PyTorch는 2.2 이후 Intel Mac 지원을 중단했기 때문에 Python 3.12에서 멈추게 됩니다. 따라서 Intel Mac 사용자는 uvx --python 3.12 demucs를 실행해야 합니다.
모델 선택 가이드: htdemucs, htdemucs_ft, htdemucs_6s, mdx
-n 플래그로 모델을 고를 수 있지만, 기본값이 항상 최선은 아닙니다. Demucs에는 드럼·베이스·기타·보컬을 나누는 4분리 모델, 6분리를 시도하는 모델, 그리고 이전 세대 MDX 챌린지 모델이 함께 들어 있습니다.
| 모델 | 분리 소스 | 속도 | 공식 주의사항 | 추천 상황 |
|---|---|---|---|---|
htdemucs | 4 | 기준 속도 (기본값) | 별도 언급 없음 | 첫 시도, 대량 작업, 처리량이 중요한 경우 |
htdemucs_ft | 4 | 약 4배 느림 | “조금 더 나을 수도 있음” | 중요하게 생각하는 곡의 최종 결과물 |
htdemucs_6s | 6 | 두 모델의 중간 | 기타는 “괜찮은” 수준, 피아노는 “잘 작동하지 않으며” “많은 누음과 아티팩트”가 발생 | 기타 스템이 꼭 필요하고 어느 정도의 지저분한 결과를 감수할 수 있을 때 |
hdemucs_mmi | 4 | 기준 속도 | v3 아키텍처를 재학습 | v4가 특정 믹스에서 이상하게 들릴 때 A/B 테스트 |
mdx / mdx_extra | 4 | 기준 속도 | mdx_extra는 MUSDB 테스트 세트를 포함한 데이터로 학습 | 오래된 음원이나 v4의 아티팩트가 거슬릴 때 |
mdx_q / mdx_extra_q | 4 | 가장 빠르고 용량이 작음 | “품질이 약간 떨어질 수 있음” | 저장 공간이 부족한 컴퓨터, 빠른 프리뷰 |
htdemucs_ft에 붙은 표현을 눈여겨볼 필요가 있습니다. 계산량은 4배로 늘어나지만, 개발자 본인도 품질 향상을 “가능하다”는 정도로만 설명합니다. CPU에서는 이 차이가 상당히 크게 느껴지고, 실제 사용자들도 그렇게 말합니다.
9.00과 9.20 dB SDR 수치가 실제로 의미하는 것
두 수치는 같은 README 문단에 등장하지만 서로 바꿔 쓸 수 있는 값이 아닙니다. Hybrid Transformer Demucs는 MUSDB HQ 테스트 세트에서 9.00 dB SDR을 기록합니다. 더 높은 수치인 9.20 dB를 얻으려면 희소 어텐션 커널과 소스별 파인튜닝이 필요합니다. 게다가 이 희소 모델은 “아직 공개할 준비가 되지 않은 커스텀 CUDA 코드가 필요하기 때문에 제공되지 않습니다.”
즉, 다운로드해서 사용할 수 있는 모델 중 9.20 dB를 재현하는 모델은 없습니다. README의 비교표에서도 배포된 파인튜닝 v4 모델은 전체 SDR 9.0을 기록해, 1.7k개 믹스로 학습한 Band-Split RNN과 같은 수준에 머뭅니다.
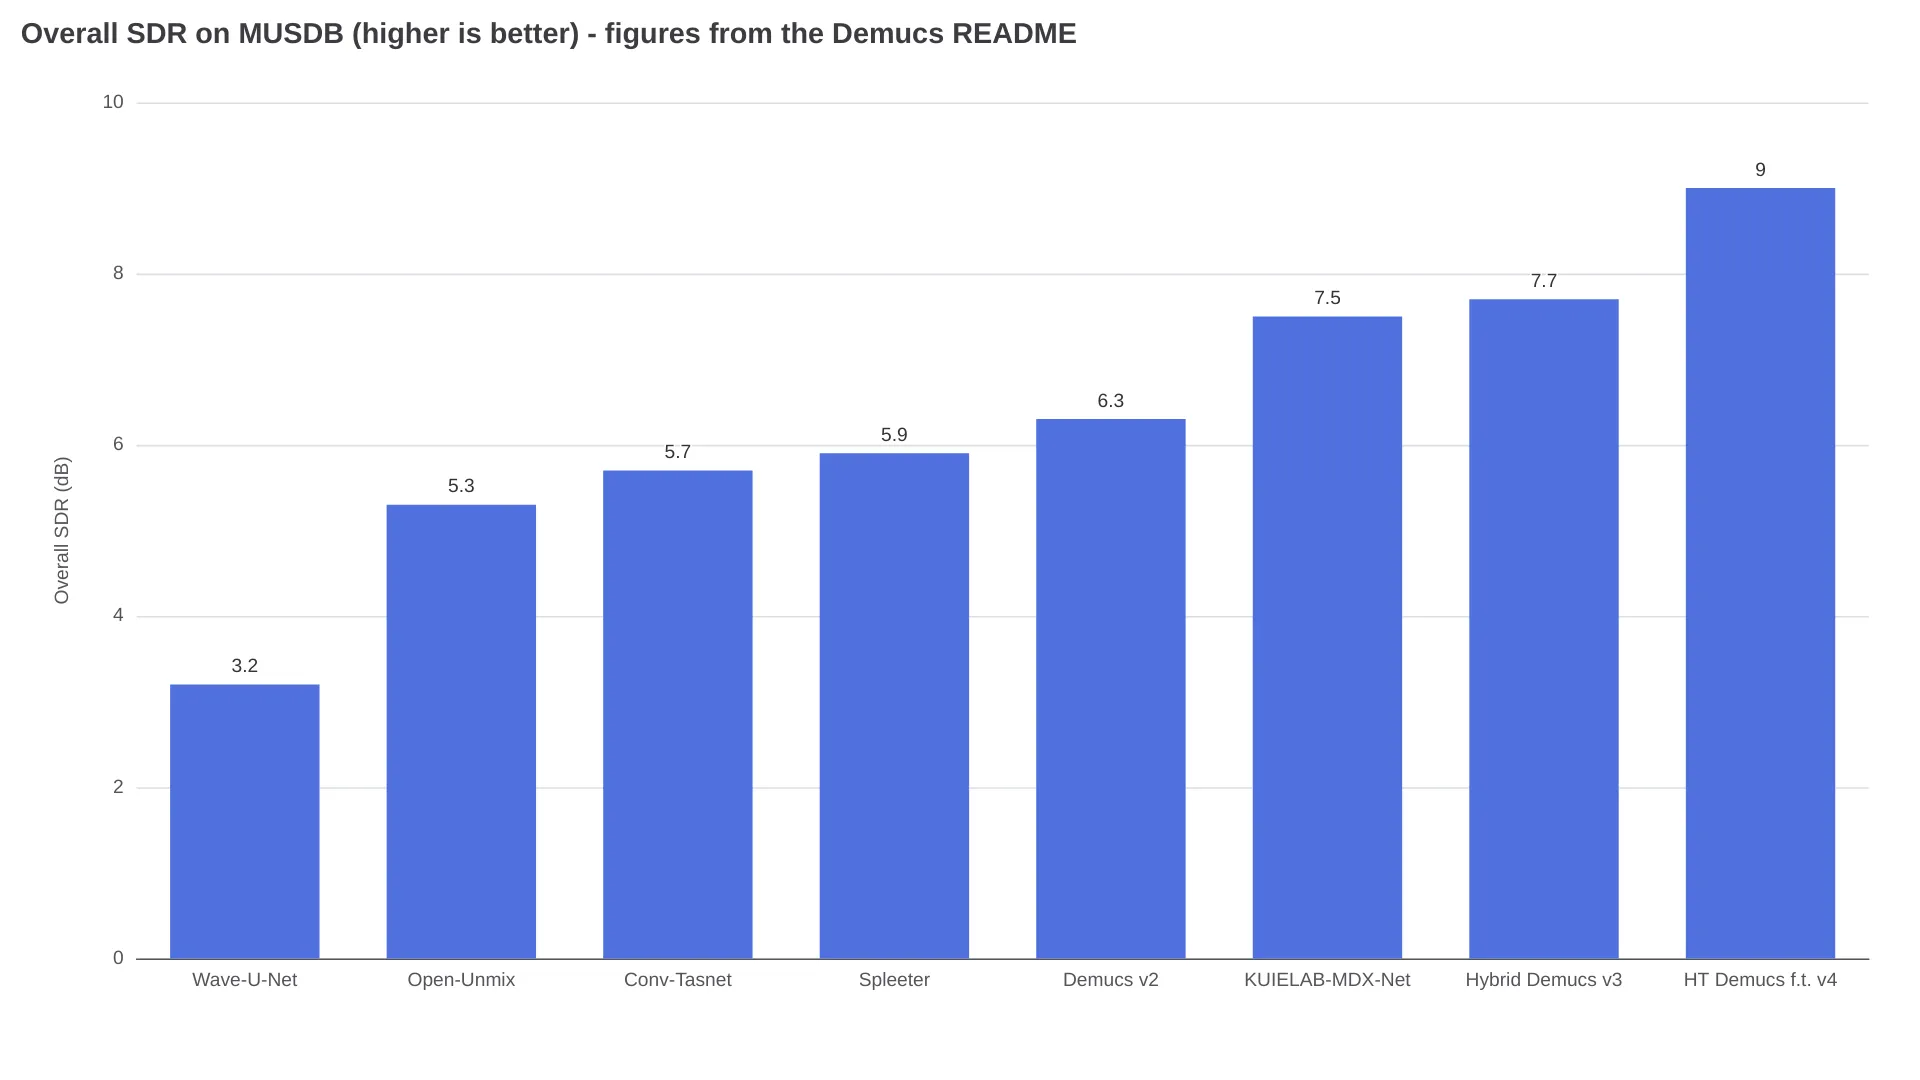
같은 표에서 Spleeter는 25k곡으로 학습했음에도 5.9 dB에 그칩니다. 파인튜닝 v4와 비교하면 약 3 dB 차이입니다.
출력 결과를 바꾸는 주요 플래그
Demucs를 실행할 때 대부분의 사용자가 결정해야 하는 것은 세 가지입니다. 몇 개의 스템으로 나눌지, 계산량을 얼마나 쓸지, 어떤 형식으로 저장할지입니다.
--two-stems=vocals는 노래방용 모드입니다.vocals.wav와no_vocals.wav를 생성합니다. 먼저 전체 믹스를 분리한 뒤 다시 믹스다운하는 방식이므로 일반 실행보다 빠르거나 메모리를 덜 사용하는 것은 아닙니다.--shifts=N은 입력을 무작위로 이동해 N번 예측한 결과를 평균냅니다. 예측 시간이 N배로 늘어나며, README의 조언은 “GPU가 없다면 사용하지 말라”는 것입니다. 논문에서는 shifts 10을 사용했고, Replicate 호스팅 버전의 기본값은 1입니다.--overlap의 기본값은 0.25입니다. 0.1로 낮추면 속도를 조금 높일 수 있습니다.--segment N은 메모리 부족을 피할 때 조절하는 옵션입니다. 여기서 복사한 명령어가 조용히 문제를 일으키는 지점이 있습니다. Hybrid Transformer 모델의 최대 세그먼트 길이는 7.8초입니다. 따라서 긴--segment값을 지정해도 HT가 아닌 모델에서만 효과가 있습니다.- 출력 플래그에는
--mp3(기본 320 kbps),--flac(ffmpeg 필요),--int24,--float32가 있습니다. 기본 출력은 44.1 kHz의 int16 WAV이며,separated/MODEL_NAME/TRACK_NAME경로에 저장됩니다. --clip-mode도 생각보다 중요합니다. Demucs는 기본적으로 클리핑을 피하기 위해 스템의 크기를 다시 조절하는데, 이 과정에서 스템 간 상대적인 음량이 달라질 수 있습니다. 반면clamp는 하드 리미트를 적용합니다.
같은 문서에서 안내하는 하드웨어 요구사항은 다음과 같습니다. GPU 메모리는 최소 3 GB가 필요하고, 기본 인자에서는 약 7 GB가 필요합니다. GPU 메모리가 3 GB 이하라면 --segment 8과 PYTORCH_NO_CUDA_MEMORY_CACHING=1을 함께 사용합니다. CPU에서는 “처리 시간이 트랙 길이의 약 1.5배가 될 것”이라는 설명이 있습니다. 다만 이는 htdemucs_ft를 사용했을 때 사용자들이 보고하는 실제 체감 속도에 비하면 낙관적인 수치입니다.
Demucs에서 누음이 생기는 지점과 사용자들이 쓰는 2단계 작업
Demucs 관련 불만에서 반복해서 등장하는 단어는 누음입니다. 특히 보컬과 리드 악기가 비슷한 음역대를 공유할 때 문제가 두드러집니다. Ryan Herr(@rrherr)는 한 추출 결과를 두고 이렇게 요약했습니다.
Demucs를 쓰니 색소폰 소리가 'vocals' 트랙에 많이 새어 들어왔다.
숙련된 사용자들이 찾은 해결책은 플래그 하나를 추가하는 것이 아닙니다. 두 번째 모델을 이어서 사용하는 방식입니다. 일본 프로듀서 夜凪P(@yonagip, 좋아요 145개)는 먼저 UVR5에서 MelBand Roformer로 보컬과 반주를 나눈 다음, 반주만 htdemucs_ft에 넣어 드럼·베이스·기타를 분리한다고 설명합니다.
Demucs単体だとVoが他に漏れるんだけど (Demucs만 쓰면 보컬이 다른 스템으로 새어 들어간다)
다른 사용자들의 보고도 비슷한 방향을 가리킵니다. 한 프로듀서는 htdemucs_ft가 베이스를 더 또렷하게 분리한다고 평가하면서도 CPU 처리 시간이 4배 느리다고 말했고(@hachi_vm), 또 다른 사용자는 기타 추출 비교에서 htdemucs-6s가 BS-RoFormer 모델보다 눈에 띄게 뒤처지는 결과를 공유했습니다(@junon_12). 이는 벤치마크가 아니라 개인적인 사용 보고이지만, 공식 설명과도 일치합니다. Défossez는 2022년 12월 6분리 모델을 발표하면서 “어느 정도의 누음과 아티팩트”를 관찰했다고 밝혔습니다.
실전 기준: 소스에 색소폰, 리드 기타, 또는 멜로디를 연주하는 피아노가 있다면 Demucs 한 번의 결과를 최종본이 아니라 출발점으로 보는 편이 좋습니다. 두 번째 패스가 필요하다면 UVR5 인터페이스에서 Roformer 계열 대안을 사용할 수 있습니다.
설치하지 않고 API로 Demucs 호출하기
Python 환경을 구성하지 않고 스템을 얻고 싶다면, 널리 사용되는 호스팅 버전으로 Replicate의 cjwbw/demucs를 고려할 수 있습니다. Nvidia T4 하드웨어에서 약 150만 회 실행됐고, 페이지 자체의 예상 비용은 실행당 약 $0.020(1달러당 약 50회)입니다. 예측 작업은 일반적으로 90초 안에 끝납니다.
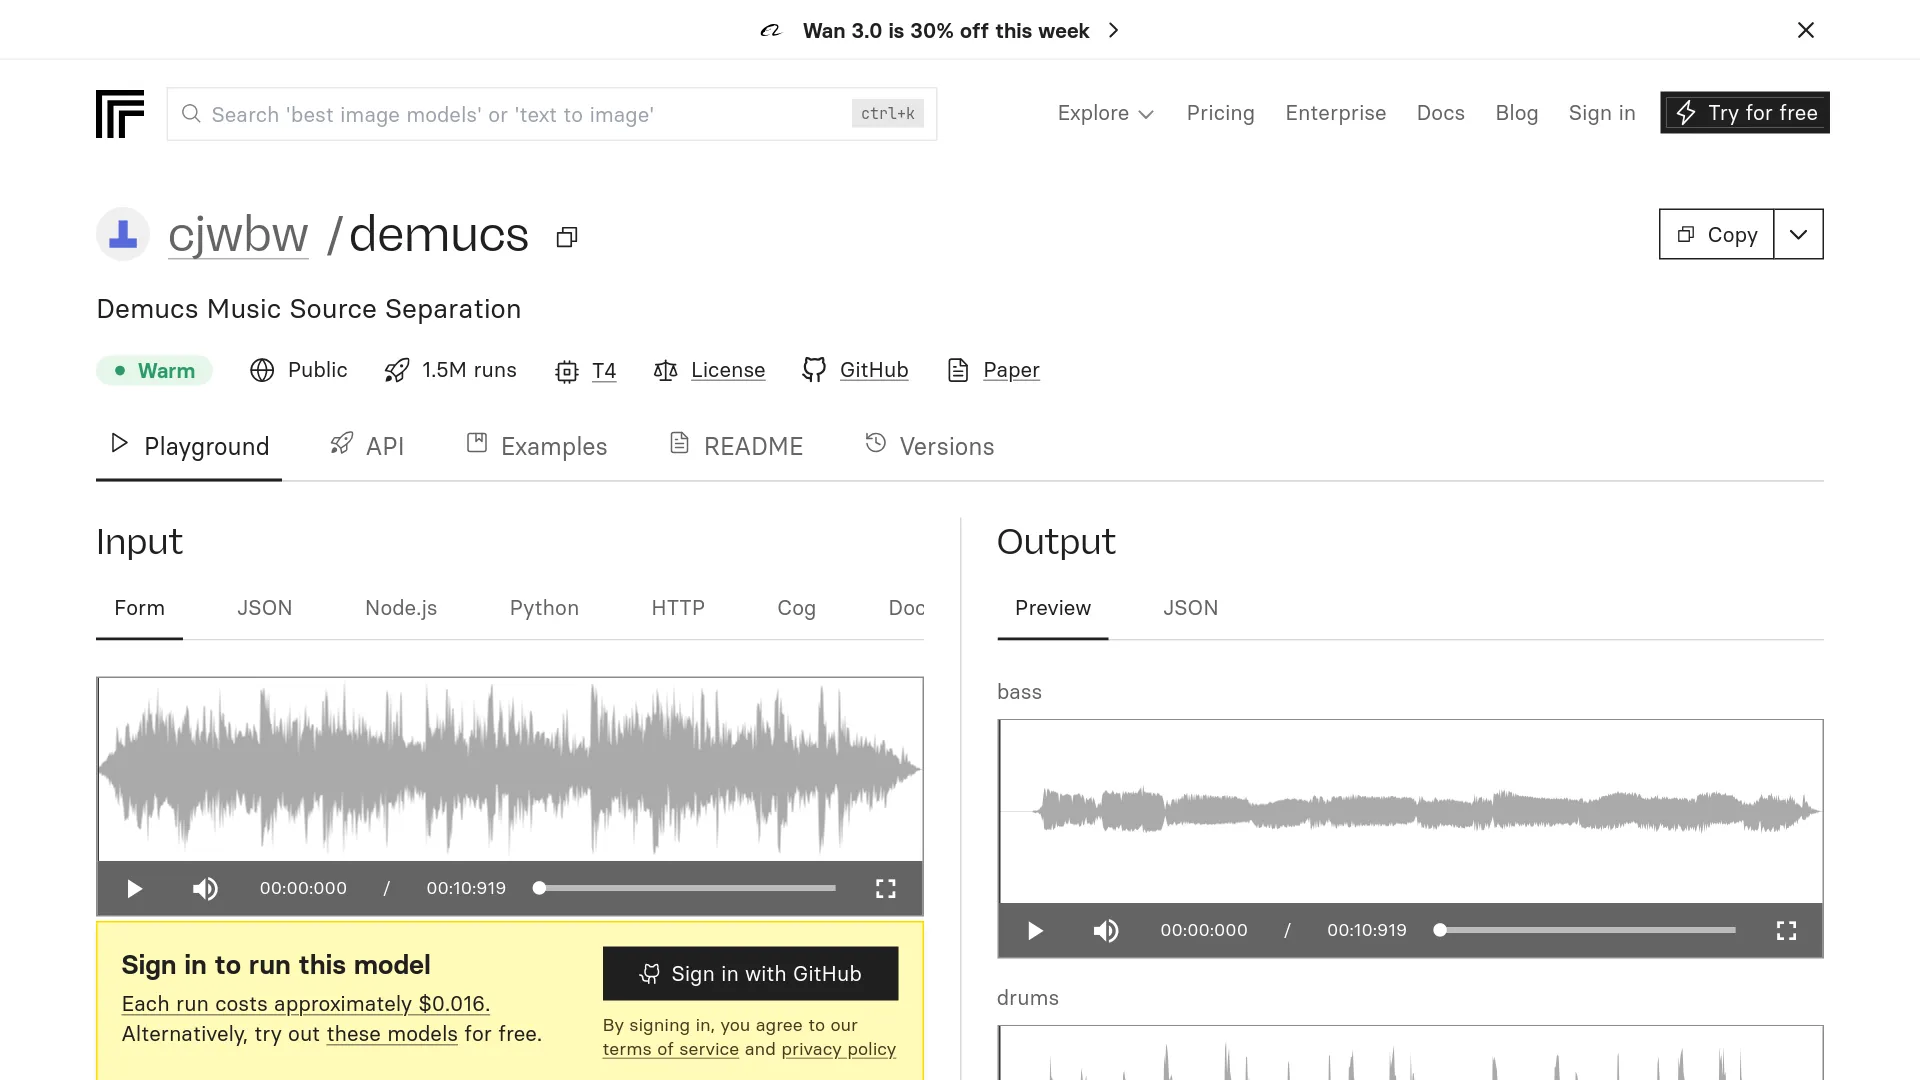
입력 스키마는 CLI와 거의 같습니다. model_name (기본값 htdemucs), stem, shifts (기본값 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32, output_format (mp3)을 사용합니다.
다만 페이지에서 따로 알려주지 않는 주의점이 있습니다. 이 모델의 최신 버전은 약 3년 전으로 거슬러 올라가며, 호스팅 엔드포인트는 특정 스냅샷에 고정돼 있습니다. 따라서 호출하는 것은 2026년 7월에 공개된 v4.1.0의 패키징 및 의존성 개선 버전이 아니라 해당 스냅샷입니다. 실행 시간도 표시된 대표 수치보다 크게 흔들립니다. 같은 모델의 공개 예시 중에는 한 번의 예측에 6분 18초가 걸린 경우도 있습니다.
4분짜리 트랙 하나에 실제로 드는 비용
작업 방식을 결정하는 핵심은 트랙당 비용입니다. 그리고 대부분의 사용자는 결제 후에야 중요한 과금 방식을 알게 됩니다.
LALAL.AI는 사용량을 파일 길이 × 선택한 스템 분리 유형 수로 계산합니다. 따라서 4분짜리 곡을 4개 스템으로 나누면 4분이 아니라 16분이 차감됩니다.
같은 가격 페이지에 따르면 일회성 추가 구매는 2026년 9월 25일 기준으로 Fast Queue 750분에 $50, 3,000분에 $190, 5,000분에 $300입니다. 이 요금으로 4분 곡을 4개 스템으로 분리하면 비용은 $0.96에서 $1.07 사이입니다.
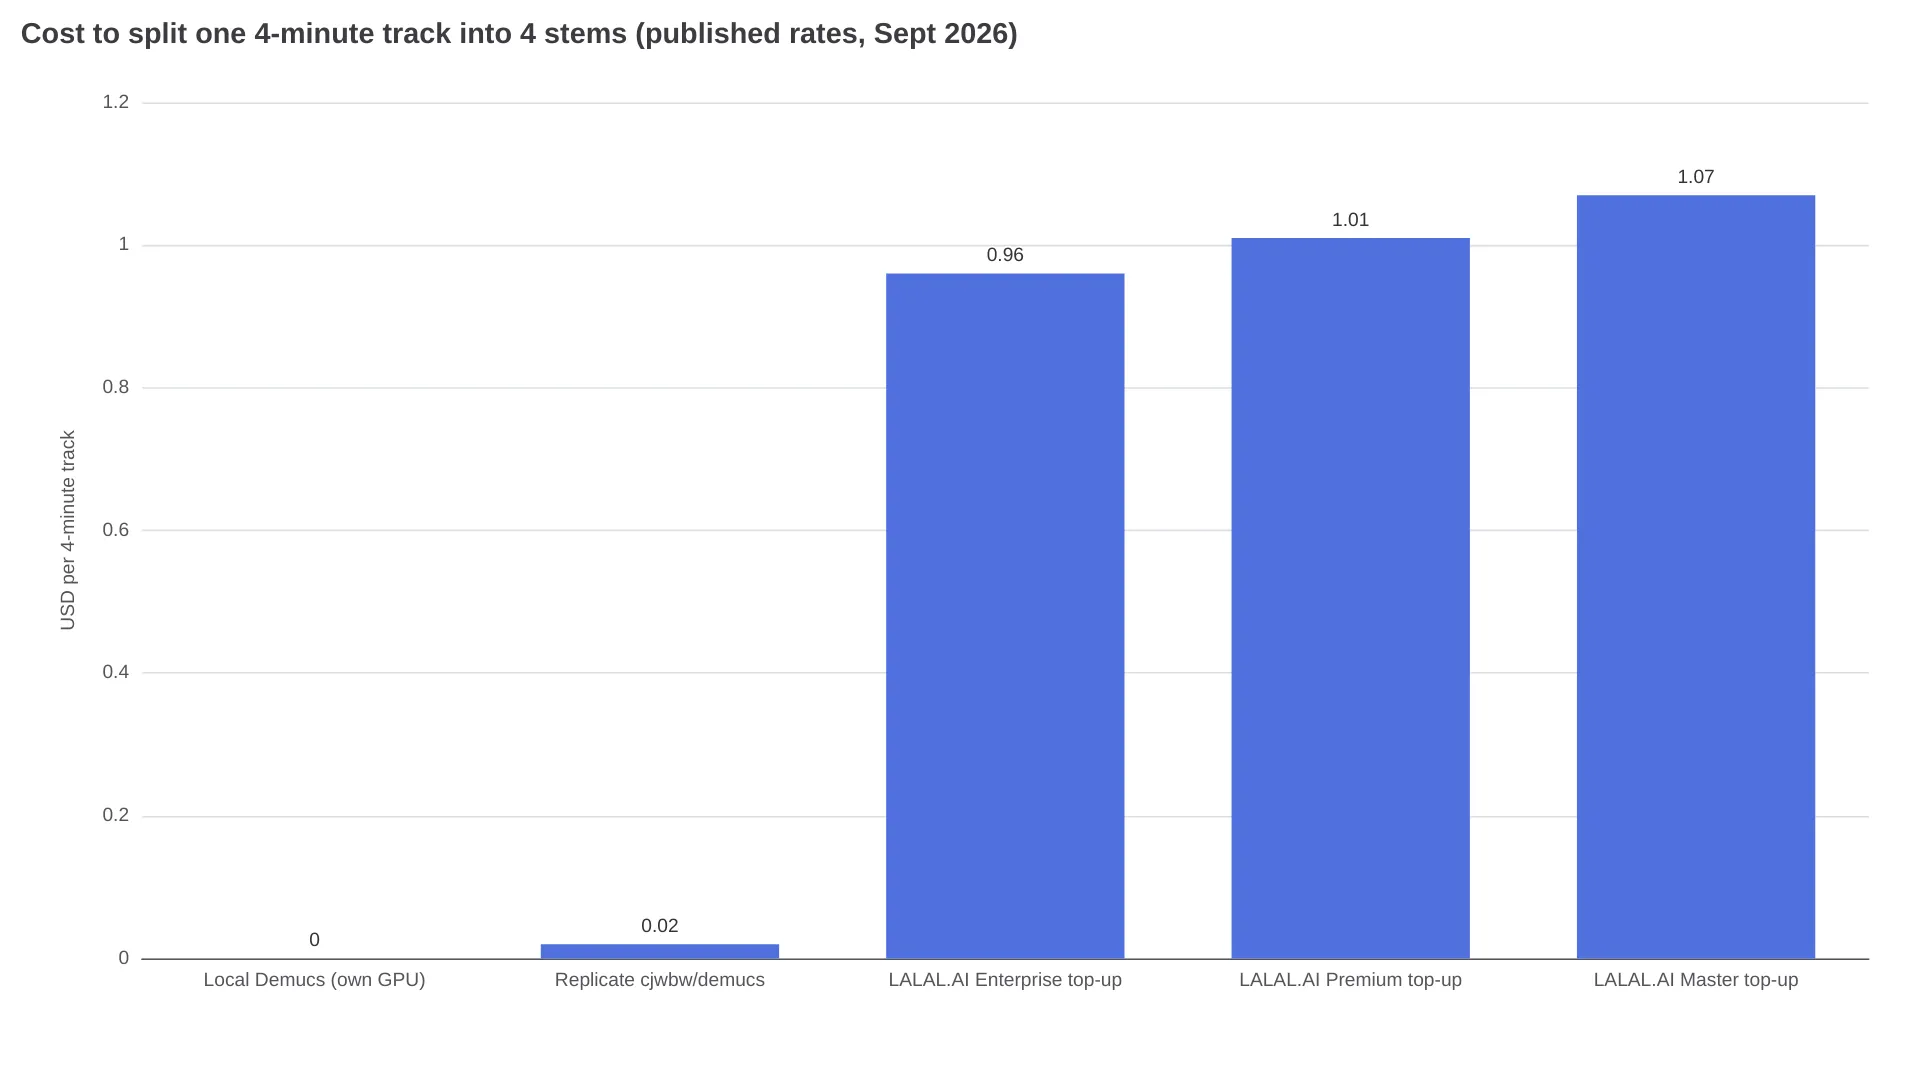
이 그래프를 볼 때 한 가지 정정할 부분이 있습니다. LALAL.AI의 해당 수치는 우선 처리 비용입니다. 유료 요금제에는 Relaxed Queue 무제한 사용이 포함되며, 회사는 두 큐가 “동일한 분리 품질을 제공한다”고 설명합니다. Fast Queue는 대기 시간을 줄여줄 뿐입니다.
| 요금제 | 가격 | 포함 내용 | 주요 제한 |
|---|---|---|---|
| LALAL.AI Starter | 무료 | Relaxed Queue 10분 | 업로드 용량 200 MB |
| LALAL.AI Lite | 월 €6.75, 연간 결제 시 €81 | Relaxed 무제한, Fast 90분 | 배치, VST, API 미지원; 분은 이월되지 않음 |
| LALAL.AI Pro | 월 €13.50, 연간 결제 시 €162 | Relaxed 무제한, Fast 250분 | API, VST 플러그인, 배치 처리를 모두 제공하는 유일한 요금제 |
| Moises | 공개적으로 표시되지 않음 | 월간 업로드가 제한된 무료 요금제 | 가격표는 로그인 후 표시되며, 27가지 스템 유형을 제공한다고 안내 |
Replicate cjwbw/demucs | 실행당 약 $0.020 | T4, 일반적으로 90초 이내 | 약 3년 전 버전에 고정 |
| Local Demucs | 무료 (MIT 라이선스) | 무제한, 오프라인 | GPU 사용 시간과 초기 설정 작업은 직접 부담 |
Lite 요금제의 Fast Queue 90분으로는 Relaxed Queue로 넘어가기 전까지 한 달에 4분짜리 4스템 트랙을 약 5곡 처리할 수 있습니다. 일주일에 몇 곡 이상 작업한다면 분 단위 과금은 빠르게 불리해집니다. 바로 그 정도의 작업량부터는 Demucs 설치에 들인 반나절이 충분히 값어치를 하기 시작합니다.
작업에 따라 달라지는 최적의 선택
| 상황 | 추천 경로 | 이유 |
|---|---|---|
| 가끔 분리하고 GPU와 터미널은 없음 | LALAL.AI Starter, 이후 Lite | 무료 10분으로 결제 전에 품질을 확인할 수 있음 |
| 곡 카피와 모바일 중심 연습 | Moises | 27가지 스템 유형과 템포·코드 기능 제공; 로그인 후 가격 확인 필요 |
| 대량 작업, 개인 GPU 보유 | htdemucs를 사용하는 uvx demucs | 추가 실행 비용이 없고 무제한으로 사용할 수 있으며 파일이 컴퓨터 밖으로 나가지 않음 |
| 중요한 최종 결과물 하나 | GPU에서 htdemucs_ft, --shifts 2 | 4배의 계산량으로 마지막 품질 향상을 노릴 수 있음 |
| 기타 스템이 필요함 | 먼저 htdemucs_6s를 사용한 뒤 UVR5에서 Roformer 계열 모델과 비교 | 공식 문서에서도 6분리 모델의 누음을 인정함 |
| 미공개 음원 또는 NDA 자료 | Local Demucs만 사용 | 업로드하지 않고 MIT 라이선스로 오프라인 처리 가능 |
| 앱 백엔드, 운영 예산 없음 | Replicate cjwbw/demucs | 실행당 약 $0.020이며 GPU 인프라를 직접 관리할 필요가 없음 |
Demucs 스템 분리 FAQ
보컬 분리에 가장 좋은 Demucs 모델은 무엇인가요?
htdemucs_ft가 배포된 4분리 모델 중 보컬 분리 성능이 가장 강력한 편입니다. 대신 htdemucs보다 처리 시간이 대략 4배 깁니다. 까다로운 믹스라면 사용자는 2단계 구성을 더 나은 방법으로 보고합니다. 먼저 Roformer 계열 모델로 보컬을 분리한 다음, Demucs로 반주를 다시 나누는 방식입니다.
Demucs로 기타와 피아노를 분리할 수 있나요?
htdemucs_6s를 사용해야 합니다. 공식 README는 빠른 테스트에서 기타 품질을 “괜찮은” 수준으로 평가하지만, 피아노 소스는 “잘 작동하지 않으며” “많은 누음과 아티팩트”가 발생한다고 설명합니다.
Demucs를 실행하려면 NVIDIA GPU가 필요한가요?
아닙니다. -d cpu로 CPU에서 실행할 수 있으며, 문서에서는 처리 시간이 트랙 길이의 약 1.5배라고 안내합니다. Apple Silicon 사용자는 -d mps를 지정할 수 있습니다. GPU 가속에는 최소 3 GB VRAM이 필요하고, 기본 인자에서는 약 7 GB가 필요합니다.
분리한 스템을 다시 합쳤는데 원본 믹스와 같지 않은 이유는 무엇인가요?
Demucs는 분리 과정에서 생기는 아티팩트로 인한 클리핑을 막기 위해 각 스템의 크기를 다시 조절합니다. 이 때문에 스템 간 상대 음량이 달라질 수 있습니다. 대신 --clip-mode clamp를 사용해 하드 클리핑을 적용하거나, 처리 전에 입력 믹스의 볼륨을 낮춰보세요.
Demucs는 스템을 어디에 저장하나요?
separated/MODEL_NAME/TRACK_NAME/ 경로에 저장합니다. 기본 출력은 44.1 kHz 스테레오 int16 WAV이며, drums.wav, bass.wav, other.wav, vocals.wav 파일이 생성됩니다. 단, MP3, FLAC, int24, float32 출력을 요청한 경우는 예외입니다.
CUDA out-of-memory 오류는 어떻게 해결하나요?
--segment 값을 낮추세요. 3 GB 그래픽 카드에서는 문서에 안내된 최저값이 8입니다. PYTORCH_NO_CUDA_MEMORY_CACHING=1을 설정하거나 -d cpu로 전환하는 방법도 있습니다. Hybrid Transformer 모델의 세그먼트 길이는 7.8초로 제한되므로, 그보다 높은 값을 지정해도 HT 모델에서는 효과가 없다는 점을 기억하세요.