 AIREITER
브랜드 톤이 중요한 번역에는 Claude Sonnet 5, 대량 처리에는 작업 1,000건당 약 $0.10 수준의 DeepSeek V4 Flash, 속도까지 고르게 챙기려면 GPT-5.6 Terra가 가장 나았다. 2026년 7월 17일, 6개 모델을 직접 테스트한 결론이다.
각 모델 API에 똑같은 번역 프롬프트 세 개를 넣고 원본 출력을 비교했다. 품질 자체는 예상보다 큰 변수가 아니었다. 6개 모델 모두 독일어 기술 문서를 정확히 옮겼고, 일본어 대화에서 흔히 생략되는 주어도 6개 중 5개가 오류 없이 처리했다. 진짜 놀라웠던 건 비용이다. 겉으로는 저렴해 보이는 두 모델이 요청마다 추론 토큰을 지나치게 많이 소모하면서, 번역 1건당 비용이 Claude보다 8~10배 높아졌다. DeepL의 문자당 요금과도 큰 차이가 나지 않는 수준이다.
2026년에 번역용 LLM을 고른다면 이제 핵심은 “번역을 할 수 있느냐”가 아니다. 모두 번역은 한다. 콘텐츠 유형과 물량에 맞으면서도 눈에 띄지 않게 비용을 과다 청구하지 않는 모델을 찾는 일이 더 중요하다.
번역 업무별 추천 모델
| 업무 유형 | 추천 | 이유 | 측정된 작업 1,000건당 비용 |
|---|---|---|---|
| 마케팅 카피, 브랜드 보이스 | Claude Sonnet 5 | 번역문이 아니라 처음부터 목표 언어로 쓴 글처럼 읽힌다 | ~$1.06 |
| 대량 처리: 상품 피드, 문서, 자막 | DeepSeek V4 Flash | 세 테스트 모두 정확했고, 압도적으로 저렴하다 | ~$0.10 |
| 혼합 워크로드, 최저 지연 시간 | GPT-5.6 Terra | 응답 3.0~4.3초, 서식 처리도 가장 깔끔했다 | ~$0.88 |
| 용어집 강제 적용, CAT 툴 워크플로 | DeepL | LLM API에는 없는 용어 데이터베이스와 통합 기능을 제공한다 | 문자 100만 개당 $27.50 |
비용은 세 가지 테스트 작업의 평균이다. 출력 토큰에 2026년 7월 공식 요금을 적용한 뒤 짧은 번역 1,000건 기준으로 환산했다. 전체 측정 표는 아래에 있다. 테스트 외 범주도 하나 있다. 실시간 음성 대화용으로 Google은 Gemini 3.5 Live Translate 전용 모델을 판매하며 가격은 토큰 100만 개당 $3.50/$21이다. 이번 테스트에서는 참고만 했고 직접 검증하지는 않았다.
테스트 방식
2026년 7월 17일에 프롬프트 세 개를 동일한 문구로 각 모델에 한 번씩 실행했다. 과제는 영어→일본어 마케팅 카피(톤 테스트), 영어→독일어 API 문서(용어 테스트), 일본어→영어 일상 대화(주어 생략과 문맥 테스트)였다. 마지막 항목은 CJK 언어쌍에서 대표적으로 문제가 되는 부분이다. CJK는 중국어, 일본어, 한국어를 가리키며, 기계번역 품질 불만이 집중되는 세 언어다.
테스트 모델은 GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2, Kimi K2.6다. 모든 호출은 기본 설정의 동일한 게이트웨이 계정으로 보냈다. 따라서 지연 시간은 모델끼리 비교할 수 있지만, 실제 수치는 지역과 제공사 부하에 따라 달라질 수 있다.
재현 테스트에 쓸 수 있도록 세 원문을 그대로 남긴다.
EN→JA (마케팅): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (기술 문서): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (대화): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
모델과 작업별 전체 측정값이다. 지연 시간은 실제 경과 시간(초), 토큰은 usage 객체의 출력 토큰 수다.
| 모델 | EN→JA | EN→DE | JA→EN | 작업당 평균 비용 |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0초 / 46 | 4.3초 / 67 | 3.2초 / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5초 / 60 | 4.0초 / 146 | 3.5초 / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2초 / 421 | 4.3초 / 371 | 4.7초 / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5초 / 769 | 18.0초 / 989 | 19.6초 / 946 | $0.00078 |
| GLM-5.2 | 30.8초 / 1,906 | 29.0초 / 1,590 | 35.2초 / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6초 / 2,849 | 48.5초 / 2,235 | 23.6초 / 2,413 | $0.01000 |
작업당 비용은 출력 토큰 수에 제공사의 공식 출력 단가를 곱해 계산했다. 입력은 작업당 60~110토큰이었고, GPT-5.6 Terra 요금을 적용해도 $0.0003 미만만 추가된다. 아래 문자 100만 개당 비용 차트에는 이 입력 비용도 포함했다. 모든 가격은 계정에 실제 청구된 할인 가격이 아닌 2026년 7월 17일 기준 공식 정가다.
작업 세 개만으로 100개 언어쌍 전체에서 모델 순위를 매길 수는 없으며, 그렇게 주장하지도 않는다. 다만 적은 표본에서도 드러나는 차이는 확인할 수 있다. 그리고 이번 차이는 상당히 컸다.
테스트 1: 영어→일본어 마케팅 카피
프롬프트는 SaaS 랜딩 페이지 문구인 “Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters.”를 자연스럽고 공손한 일본어로 옮기도록 요청했다.
Claude Sonnet 5의 카피는 다음과 같았다.
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
일본인 카피라이터가 쓸 법한 어조다. ‘형태’를 뜻하는 カタチ를 가타카나로 스타일링한 표현과 쉼표로 끊는 리듬은 교과서 문법이 아니라 랜딩 페이지 카피의 관습에 가깝다. GPT-5.6 Terra와 DeepSeek V4 Pro도 「アイデアを、より迅速に形に。」처럼 깔끔하고 비즈니스다운 표현으로 바짝 뒤따랐다.
DeepSeek V4 Flash는 6개 모델 중 가장 직역에 가까웠다. 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」는 문법적으로 문제없지만 번역문처럼 읽힌다. 제품 페이지라면 사람의 손질을 한 번 더 거치는 편이 좋다. 반면 지원 문서나 내부 문서에는 충분히 쓸 만하다.
차이는 분명하지만 크지는 않았다. 6개 모델 모두 실사용 가능한 일본어를 만들었다. Claude에 작업 1,000건당 약 $1를 더 지불할 가치가 가장 뚜렷하게 나타난 곳은 브랜드 보이스 작업이었고, 다른 테스트에서는 이 정도로 중요하지 않았다.
테스트 2: 영어→독일어 기술 문서
레이트 리밋, HTTP 429, 지수 백오프, 멱등성 키가 포함된 API 문서 두 문장을 번역했다. 6개 모델 모두 기술 용어를 정확히 처리했고, 독일어 문서에서 자연스러운 표현인 Ratenlimit, Statuscode 429, exponentielles Backoff, Idempotenzschlüssel를 사용했다.
눈에 띄는 차이는 하나뿐이었다. GPT-5.6 Terra는 실제 독일어 API 문서처럼 헤더 이름 Retry-After에 코드 서식을 적용했다. 품질 격차라기보다 기분 좋은 디테일이다.
리소스가 풍부한 유럽 언어 사이의 일반적인 문서 번역에서는 표본의 어떤 모델도 오류를 내지 않았다. 이 세대의 모델에서는 품질 차이가 관찰하기 어려울 만큼 작았다. 업무 대부분이 이런 문서라면 품질보다 가격과 속도로 고르면 된다. 토큰 100만 개당 입력 $0.14, 출력 $0.28인 DeepSeek V4 Flash가 기본 선택지가 되는 이유다.
테스트 3: 주어가 생략된 일본어→영어 대화
일본어는 문장에서 주어를 자주 생략하기 때문에, 번역기는 누가 무엇을 하는지 문맥으로 추론해야 한다. 테스트 대화에는 정식 의사결정 전에 조용히 합의를 다지는 일을 뜻하는 문화 의존적 표현 根回し(nemawashi)도 들어갔다. 영어에 정확히 일대일로 대응하는 단어는 없다.
6개 모델 중 5개는 모든 요소를 잘 처리했다. 주어를 올바르게 배정했고, nemawashi도 “lay the groundwork”, “sound him out beforehand”, “give him a heads-up” 등 모두 타당한 표현으로 번역했다. Claude의 결과는 가장 원어민 대화처럼 읽혔다. 예를 들면 “he's probably gonna chew me out” 같은 표현이다.
18개 출력 중 유일한 실제 오류는 DeepSeek V4 Pro에서 나왔다. 다음에 무엇을 해야 하는지 조언하는 「先に根回ししといたほうがいい」를, 이미 기회를 놓친 일에 대한 과거형 후회인 “You should've laid the groundwork first”로 번역했다. 작은 단어 차이지만 뜻은 반대다. 동료가 한 말을 전자로 듣느냐 후자로 듣느냐에 따라 행동도 달라진다.
한 번의 실행에서 나온 시제 오류 하나는 데이터 포인트일 뿐, 모델 전체에 대한 판정은 아니다. 두 DeepSeek 티어의 차이는 DeepSeek V4 Flash vs Pro 비교에서 더 자세히 다뤘다. 다만 유창함과 충실성은 다른 속성이라는 점은 분명히 보여준다. 문장은 완벽하게 자연스러워도 의미는 틀릴 수 있다. 시제 하나를 잘못 읽는 비용이 큰 계약서, 의료 콘텐츠 등에서는 어떤 모델을 쓰든 사람 검수를 예산에 넣어야 한다.
토큰 소모의 함정: 단가표만 보면 안 되는 이유
구매 판단을 바꾸는 핵심 결과가 여기 있다. 출력 토큰 100만 개 기준 GLM-5.2는 $4.40, Kimi K2.6은 $4.00으로 Claude Sonnet 5의 $10보다 절반 이하 가격이다. 하지만 실제 번역 1건 기준으로는 8~10배 더 비쌌다.
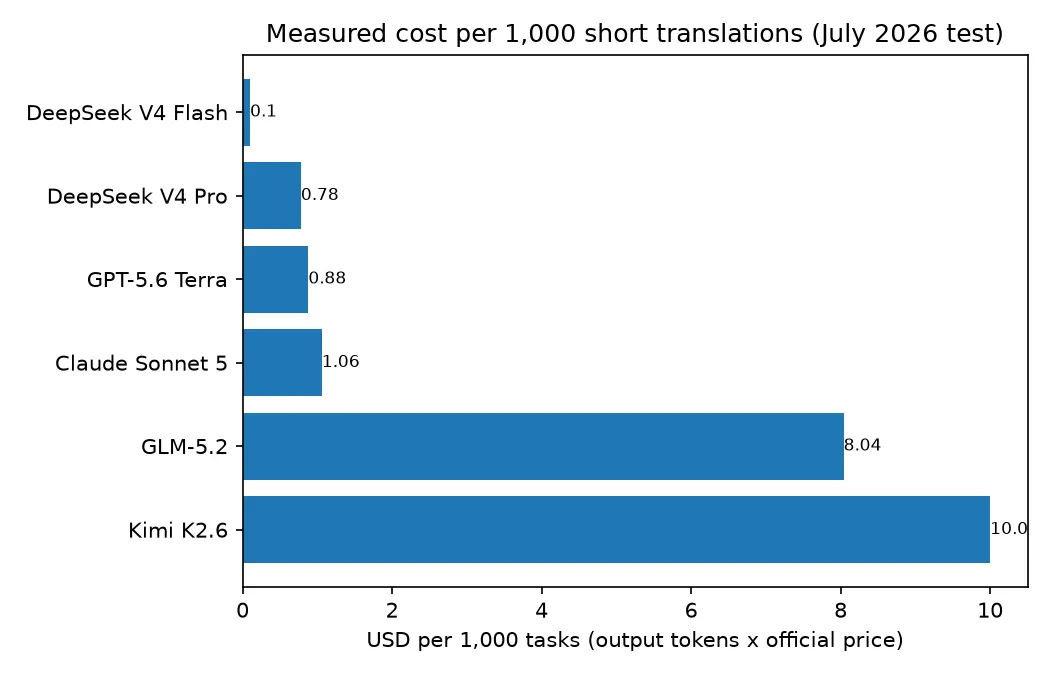
원인은 두 모델 모두 답변 전에 눈에 보이는 추론 체인을 실행하고, 이 추론 토큰도 출력 토큰으로 과금된다는 점이다. Kimi K2.6은 마케팅 문장 하나를 번역하면서 40~60토큰짜리 결과를 위해 출력 토큰 2,849개를 생성했다. GLM-5.2는 1,906개였다. 같은 작업에서 Claude Sonnet 5는 60토큰, GPT-5.6 Terra는 46토큰을 썼다.
지연 시간도 같은 패턴을 보였다. GPT-5.6 Terra와 Claude Sonnet 5는 세 작업 모두 3~4초 안에 응답했다. DeepSeek V4 Flash는 4~5초, DeepSeek V4 Pro는 16~20초였고, GLM-5.2와 Kimi K2.6은 요청당 20~48초가 걸렸다.
여기서 실무 원칙 두 가지가 나온다. 첫째, 번역처럼 짧고 물량이 많은 작업에서는 정가가 아니라 실제 작업당 측정 비용으로 모델을 비교해야 한다. 요청 20개를 보내고 usage 필드를 확인하면 된다. 둘째, 번역에서는 추론을 끄거나 낮춰야 한다. DeepSeek는 thinking과 non-thinking 엔드포인트를 구분하고, GLM과 Kimi는 요청 본문에서 thinking 파라미터를 제공한다. 이번 세 작업에서는 추론 체인이 출력 품질에 감지할 수 있는 이점을 더하지 못했다.
대량 번역 시 실제 비용
측정된 토큰 소모를 영어 원문 문자 100만 개, 즉 대략 250,000토큰으로 확대하면 격차는 훨씬 커진다.
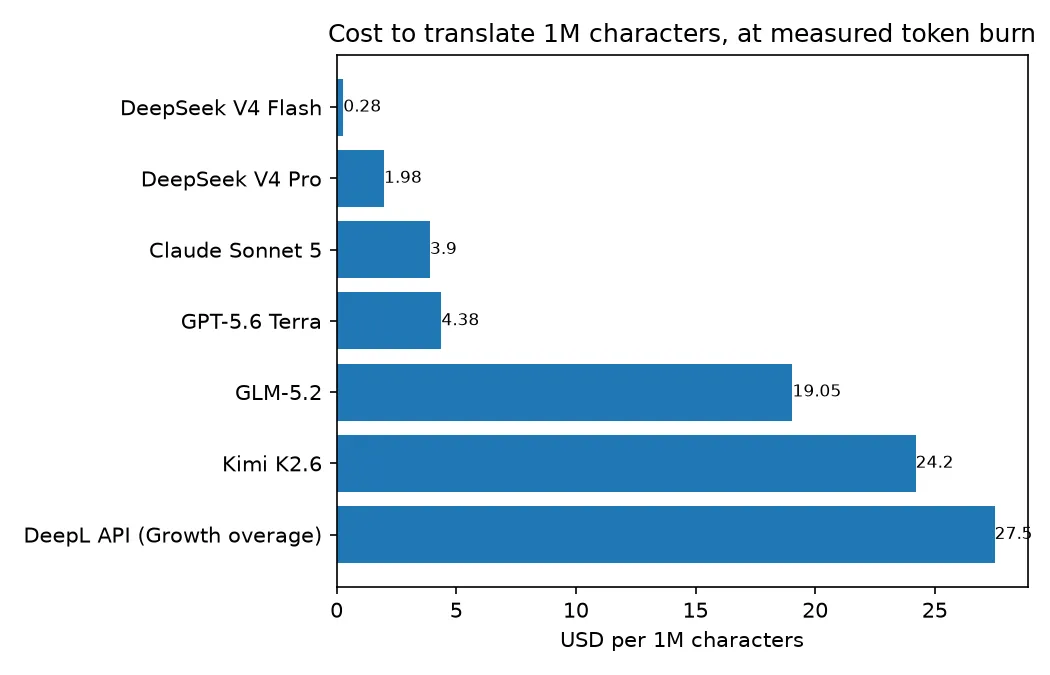
DeepSeek V4 Flash는 소설 한 권 분량의 텍스트를 약 $0.28에 번역한다. 같은 물량을 DeepL API로 처리하면 Growth 플랜 초과 사용 요금 기준 $27.50으로, 98배 차이다. 이는 "LLMs are 800x cheaper for translation than DeepL"라는 제목으로 널리 공유된 r/LocalLLaMA 분석의 방향성과도 일치한다. 해당 분석의 배수가 더 컸던 것은 더 작은 자체 호스팅 모델을 사용했기 때문이다.
차트 상단도 주목할 만하다. 실제 토큰 소모를 반영하면 추론 비중이 높은 오픈 웨이트 모델은 DeepL과의 비용 격차를 거의 좁혀 버린다. 토큰 사용량을 측정하지 않은 단가는 비용 추정치가 아니다.
도입 전에 알아둘 가격 정보 세 가지다. 모두 2026년 7월 17일에 확인했다.
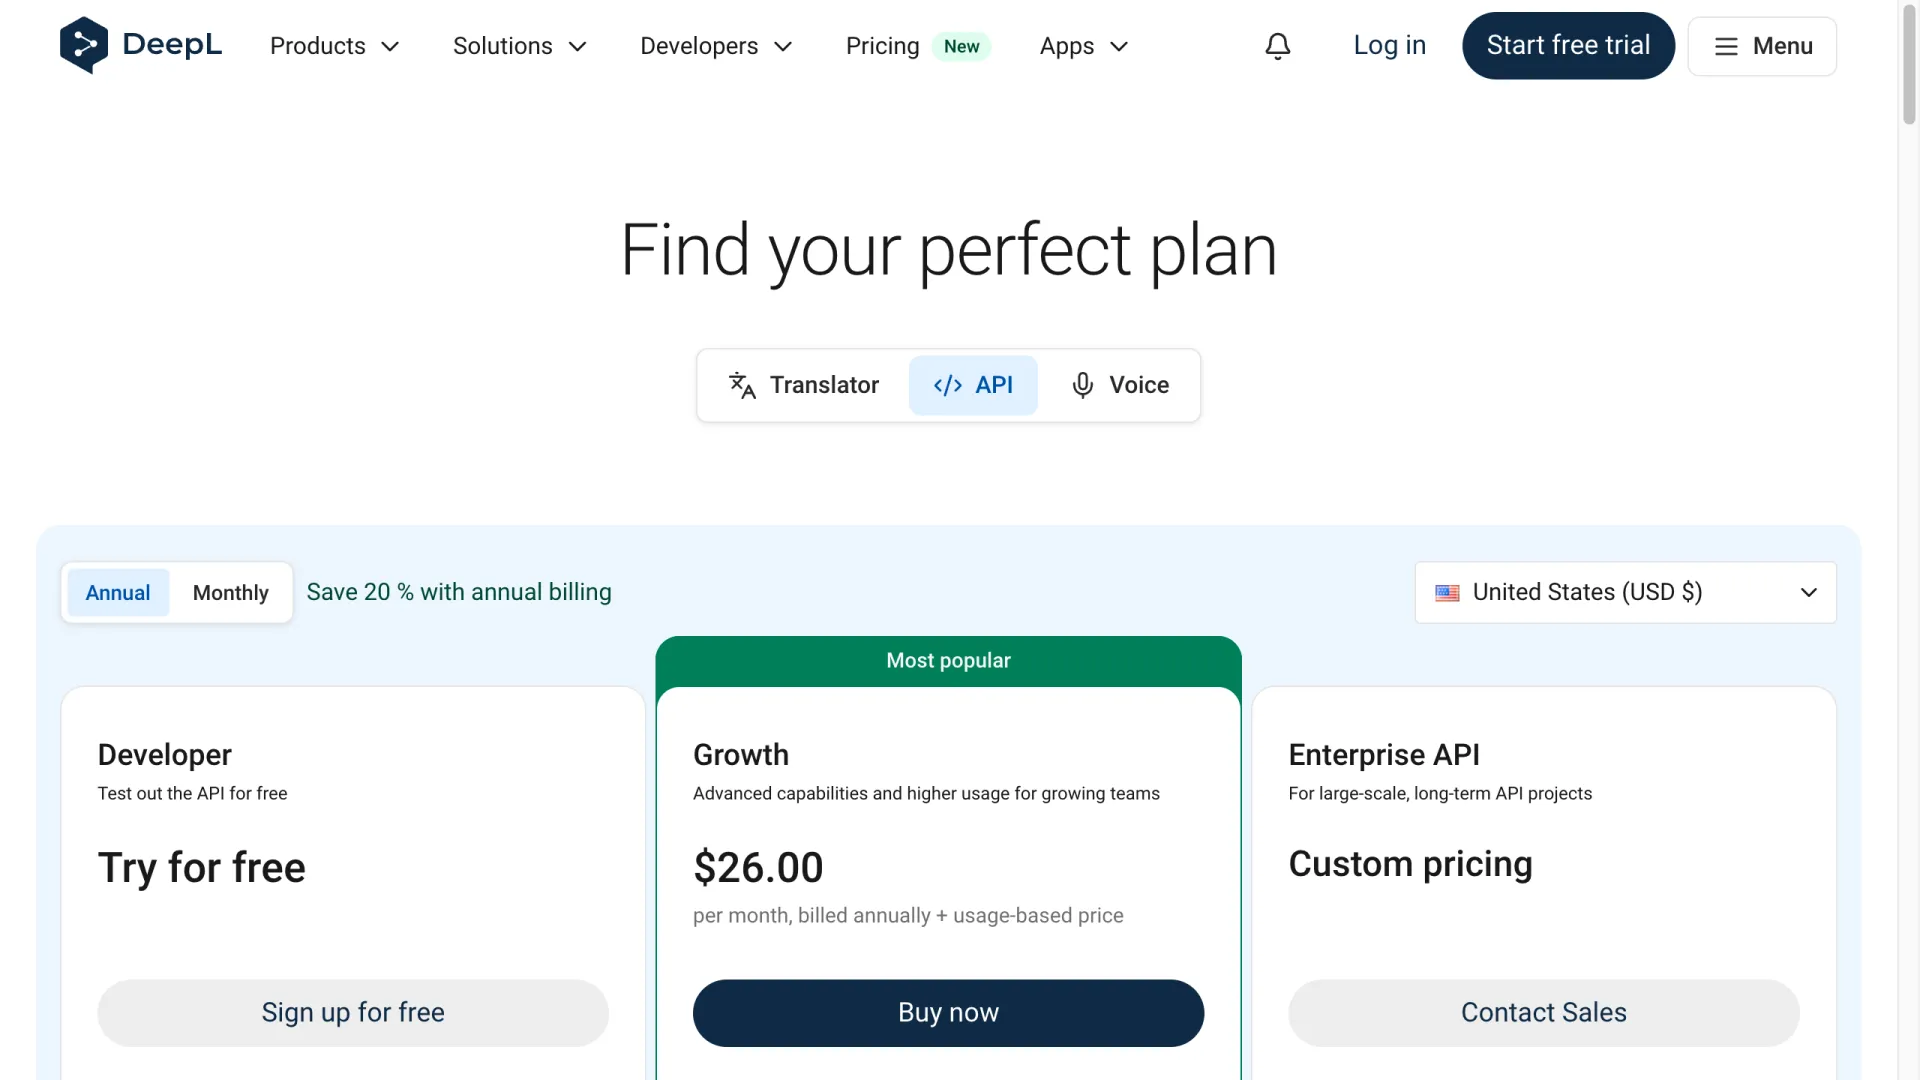
- DeepL 무료 티어가 바뀌었다. API Developer 플랜은 이제 월 500,000문자가 아니라 일회성 1,000,000문자 크레딧을 제공한다. 이전 문서나 포럼 답변에는 여전히 월 500,000문자로 적혀 있을 수 있다. Growth는 월 $26(연간 청구)이며 연 1,200만 문자가 포함되고, 이후 문자 100만 개당 $27.50이 추가된다.
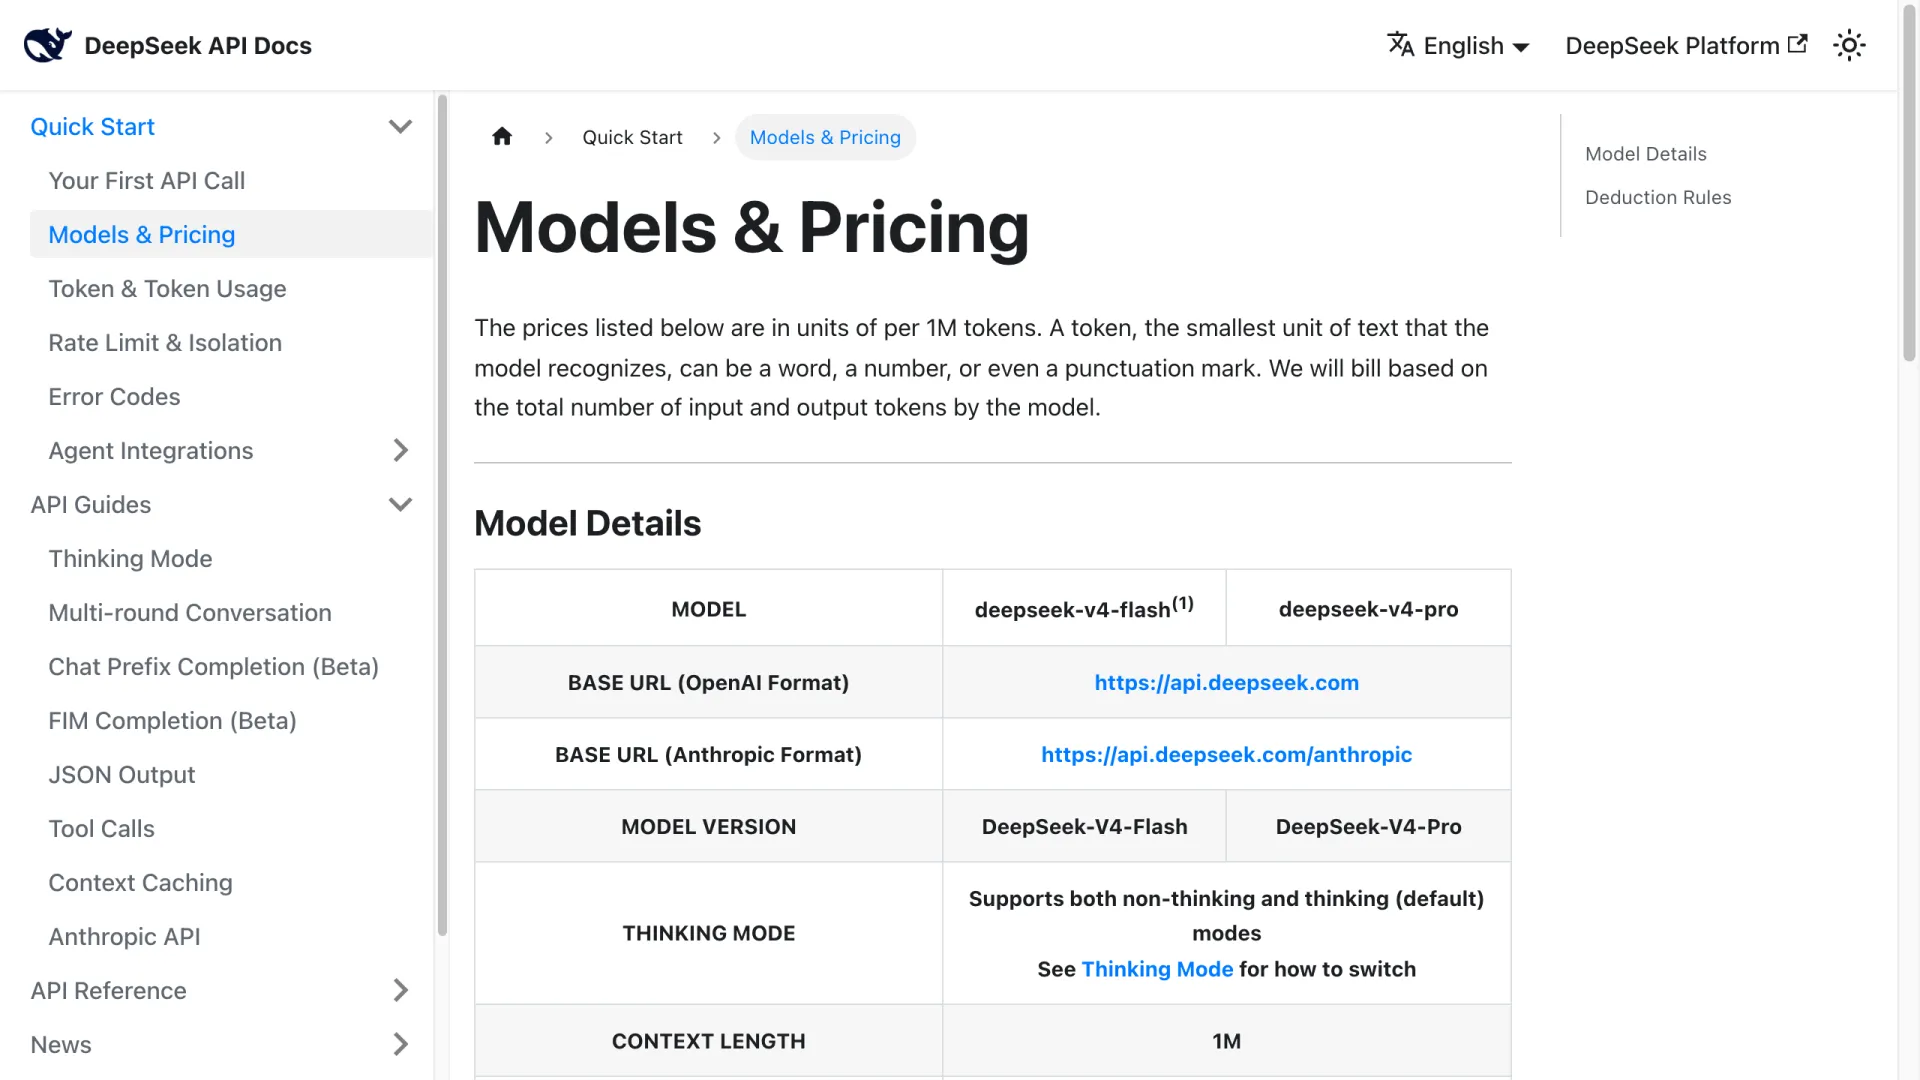
- DeepSeek의 과금은 다른 서비스의 일부 수준이다. V4 Flash는 토큰 100만 개당 입력 $0.14, 출력 $0.28이며 캐시 히트 입력은 $0.0028까지 내려간다. 기존 deepseek-chat 모델명은 2026년 7월 24일 종료된다.
- Claude Sonnet 5는 도입 가격이 적용 중이다. 2026년 8월 31일까지 토큰 100만 개당 $2/$10이며, 이후 $3/$15가 된다. 새 토크나이저는 같은 텍스트에서 약 30% 더 많은 토큰을 생성하며, 이번 비용 계산에도 이를 반영했다. 9월 이후까지 계획한다면 두 요소를 모두 예산에 넣어야 한다.
- Batch API는 비용을 절반으로 줄인다. OpenAI, Anthropic, Google은 모두 비동기 배치 처리에 약 50% 할인을 제공한다. 번역은 대개 지연 시간에 민감하지 않은 워크로드이므로 사실상 공짜 절감이다. 배치 요금을 적용하면 GPT-5.6 Terra는 문자 100만 개당 약 $2.19, Claude Sonnet 5는 약 $1.95가 된다.
DeepL이나 Google Translate가 여전히 나은 경우
문자당 비용만 보면 LLM이 유리하지만, 아래 세 가지 요구사항에서는 전통적인 번역 서비스가 더 적합하다.
- 용어 일관성 강제. DeepL은 특정 용어를 언제나 같은 방식으로 번역하도록 보장하는 글로서리와 용어 데이터베이스를 제공한다. LLM에서는 프롬프트로 지시하고 결과를 검증해야 하며, 이는 강제가 아니라 확률적 동작이다.
- CAT 툴과 번역 파이프라인 연동. 번역 메모리가 CAT(computer-assisted translation) 툴에 있다면 DeepL 커넥터를 바로 연결할 수 있다.
- 대규모 환경에서 1초 미만 지연 시간. 기존 신경망 기계번역 엔진은 일반 LLM보다 보통 더 빠르게 응답한다. UI 안에서 즉시 번역해야 한다면 이 차이가 중요하다.
실시간 음성에는 기존 NMT도 채팅 LLM도 적합한 형태가 아니다. Google은 전용 Gemini 3.5 Live Translate 모델을 토큰 100만 개당 $3.50/$21과 분당 오디오 요금으로 책정하고 있다. 자세한 내용은 Gemini 3.5 Live Translate 분석에서 다뤘다.
희소 언어와 저자원 언어에서는 품질 순위보다 지원 범위가 먼저다. 무엇과 비교하기 전에 해당 언어쌍을 지원하는지부터 확인해야 한다. DeepL은 약 30개 언어를 지원하는 반면, 대형 LLM은 100개 이상의 언어를 다루지만 지원 범위의 끝으로 갈수록 품질은 떨어진다.
오픈소스와 로컬 실행 옵션
GLM-5.2와 Kimi K 시리즈는 모두 오픈 웨이트를 공개한다. 따라서 자체 호스팅한다면 앞서 언급한 토큰 소모 문제는 해결할 수 있다. 샘플링 설정을 직접 제어하고 추론 체인을 완전히 억제할 수 있기 때문이다.
단일 GPU에서 로컬 번역을 돌릴 모델로는 Qwen3-30B-A3B가 유럽 언어→영어 번역에서 계속 추천된다. 로컬 번역 모델을 다루는 r/LocalLLaMA 스레드에서는 언어쌍이 더 특수해질수록 더 큰 모델을 권한다. 선택 이유는 대개 품질보다 개인정보 보호(계약서, 미공개 제품)나 한계비용 0에 있다. 같은 스레드에서도 호스팅형 프런티어 모델의 번역 품질이 더 낫다는 평가는 여전하다.
지켜볼 모델도 있다. Kimi K3는 이번 주 오픈 웨이트와 함께 출시됐고, 호스팅 가격은 토큰 100만 개당 $3/$15다. K3 API 접근은 아직 순차적으로 열리는 중이어서 K2.6을 테스트했다. K3가 K 시리즈의 높은 토큰 사용 성향을 물려받았다면, 실제 측정 비용에 대한 동일한 주의가 필요하다.
직접 비교하는 방법
위 비교는 API 호출 약 20번이면 재현할 수 있다. 자체 콘텐츠에서 문장 두 개를 고르고, 후보 모델마다 전송한 뒤 각 응답의 usage 객체에서 실제 토큰 수를 확인하면 된다. 이번 18회 요청 테스트의 총비용은 $0.15 미만이었다.
번거로운 부분은 5개 제공사의 API 키 6개를 관리해야 한다는 점이다. 우리는 하나의 AIReiter 계정으로 6개 모델을 모두 실행했다. 이 서비스는 단일 Anthropic 호환 엔드포인트 뒤에서 주요 모델 API 접근을 재판매하며, Claude 계열 키는 정가의 약 5분의 1 수준이다. 즉 키 하나로 위 모든 모델에 같은 와이어 포맷을 쓸 수 있다.
번역 물량이 실제로 크다면, 자체 콘텐츠로 한 시간 정도 표본 검증하는 편이 이 글을 포함한 어떤 순위표보다 낫다. 모델 간 품질은 충분히 비슷하므로, 결국 언어쌍과 톤 요구사항, 토큰 측정값이 답을 정해야 한다.
FAQ
번역에는 ChatGPT와 Gemini 중 무엇이 더 좋은가?
이번 테스트에서 GPT-5.6 Terra는 세 과제 모두 빠르고 정확했으며 서식 처리도 깔끔했다. Gemini는 게이트웨이에 없어서 정면 비교하지 못했지만, 공개 가격은 경쟁력 있다. 3.5 Flash 기준 토큰 100만 개당 $1.50/$9이며, 전용 실시간 음성 번역 모델을 제공하는 유일한 사업자이기도 하다.
현재 가장 정확한 AI 번역기는 무엇인가?
리소스가 풍부한 언어쌍에서는 프런티어 모델 간 정확도 차이가 작다. 테스트한 6개 모델은 모두 독일어 기술 문서를 오류 없이 번역했다. 차이는 톤에서 더 두드러졌다. 일본어 마케팅 카피에서는 Claude가 앞섰고, 생략된 주어와 시제 같은 엣지 케이스에서는 DeepSeek V4 Pro가 표본 내 유일한 실제 오류를 냈다.
번역에 가장 좋은 오픈소스 LLM은 무엇인가?
GLM-5.2와 Kimi K2.6은 모두 웨이트를 공개하며, 이번 테스트에서도 정확하게 번역했다. 자체 호스팅하면 작업당 API 비용을 높이는 추론 체인을 끌 수 있다. 소비자용 하드웨어에서는 Qwen3-30B-A3B가 커뮤니티에서 흔히 추천되는 모델이다.
LLM이 사람 번역가를 대체할 수 있는가?
내부 문서, 지원 콘텐츠, 대량 상품 텍스트는 대체로 가능하다. 모델에 따라 DeepL 문자당 비용의 1~16% 수준이다. DeepSeek V4 Flash는 약 1%, Claude Sonnet 5는 약 14%, GPT-5.6 Terra는 약 16%다. 다만 계약서, 의료 텍스트, 브랜드 캠페인에서는 테스트 3의 시제 오류가 경고 사례다. 유창한 결과도 의미를 반대로 만들 수 있으므로, 오해 비용이 큰 분야에서는 사람 검수를 유지해야 한다.
2026년에도 DeepL을 쓸 가치가 있는가?
그렇다. 용어집 강제 적용, CAT 툴 통합, 1초 미만 지연 시간이 필요한 세 경우에는 여전히 가치가 있다. 이 밖의 경우 문자당 비용은 정당화하기 어렵다. 또한 무료 티어는 더 이상 월 단위가 아니라 일회성 100만 문자 크레딧이라는 점도 알아둘 필요가 있다.