 AIREITER
Modalのマルチノードジョブは、クラスタのサブスクリプション料金ではなく、確保したリソース全体に対して課金されます。Modal Clustersは一般提供されていますが、請求額を決めるのは、各コンテナが実際に使ったGPU、CPU、メモリ、ストレージ、ネットワークです。
Modal Clustersの料金を1分で把握する
公式のModal料金ページと一般提供開始の発表では、利用量に応じた課金体系と、複数のコンテナをまとめて起動する@modal.clusteredエントリーポイントが説明されています。RDMAを有効にしても、変わるのは通信経路であり、基本的な料金計算式そのものではありません。
GPU数 × GPU利用秒数 × GPU単価 + CPU利用秒数 + メモリのGiB秒 + ストレージ + 対象となるエグレス
この計算式が重要なのは、クラスタではノード全体のリソース割り当てがそのまま積み上がるからです。1ノードあたりH100を8基搭載したノードを4台リクエストすれば、課金対象はH100が32基です。「コーディネーター1台と無料のワーカー」という扱いにはなりません。
Modal Clustersで料金表に加わるもの
Modalが2026年10月1日に発表したGAリリースでは、マルチノード実行がマネージドなプリミティブとして提供されます。sizeでコンテナ数を指定し、対応環境ではrdma=Trueによって高速な通信経路を有効にできます(Modalの発表)。
ドキュメントでは、ギャングスケジューリングについても説明されています。処理を進められない中途半端なジョブを起動するのではなく、リクエストされたグループをまとめて配置することをModalが試みます。分散学習、ファインチューニング、モデル並列推論、同期したGPU通信が必要なprefill/decode構成などが、対応する代表的なワークロードです。
クラスタのドキュメントには、実運用上の制約も記載されています。GPUはノード単位で割り当てられ、CPUのみのクラスタには対応していません。また、コンテナが失敗またはプリエンプトされると、クラスタ化された呼び出し全体が失敗する可能性があります。返される出力はrank 0のものだけなので、長時間のジョブではコンテナ外へのチェックポイント保存が必要です。
Modal Clustersの請求額を左右するGPU単価
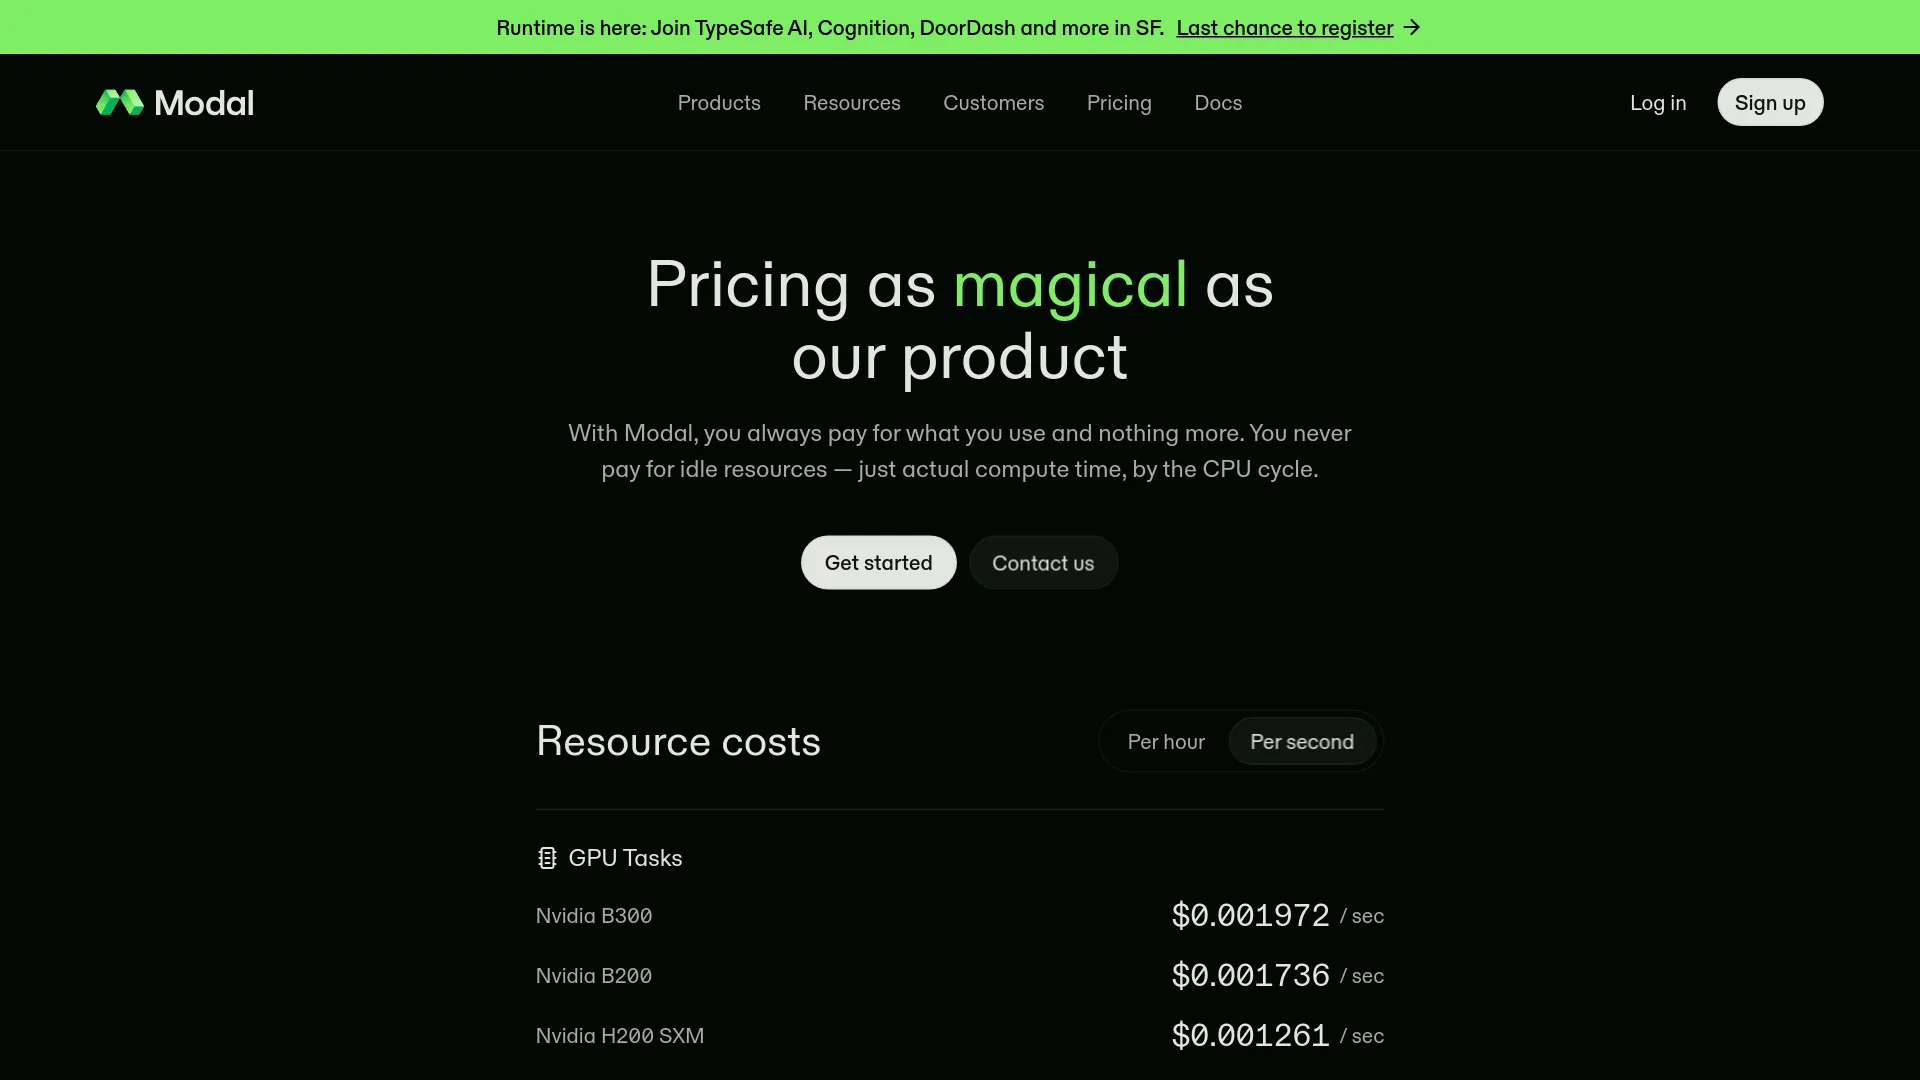
見積もりの出発点として使いやすいのが、以下の公開料金です。1時間あたりの金額は秒単価から算出したもので、CPU、メモリ、ストレージ、地域による追加倍率は含みません。
| GPU | 1秒あたり | GPU 1時間あたりの概算 |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modalでは、CPUは物理コア秒あたり$0.0000131、メモリはGiB秒あたり$0.00000222と記載されています。ボリュームは1GiBあたり月額$0.09で、最初の1TiBは無料です。ネットワークエグレスは、無料枠を超えた分に対して1GiBあたり$0.04です。大規模なジョブを起動する前に、公式の料金表で最新の金額を確認してください。
計算例:H100を8基搭載したノードを4台使う場合
分散学習ジョブで、size=4を指定し、各ノードにH100:8を割り当てるとします。
- 4ノード × GPU 8基 = H100が32基。
- 32 × 1時間あたり$3.95 = GPU料金は1時間あたり約$126.40。
- $126.40はGPUだけで計算した最低ラインです。CPU、メモリ、ストレージ、エグレスは別途かかります。
専有環境やリザーブドキャパシティと比較するときは、この金額を基準にします。サーバーレスのメリットは、バースト処理が終わればクラスタを縮小できることです。ノードをフル稼働させるジョブ自体が安くなるわけではありません。
料金表より先にプランの上限が問題になることもある
一般提供された機能だからといって、容量が無制限とは限りません。Modalの公開ワークスペースプランには、料金以前に大規模クラスタの実行を止める可能性がある同時実行数やプラットフォーム上の制約があります。
| プラン | プラットフォーム料金 | 含まれるコンピュートクレジット | 公開されているGPU同時実行数 |
|---|---|---|---|
| Starter | $0/月 | $30/月 | GPU 10基 |
| Team | $250/月 | $100/月 | GPU 50基 |
| Enterprise | カスタム | カスタム | カスタム / より高い上限 |
H100を32基使う実験では、すでにGPUを32基消費します。そのため、同時実行数がGPU 10基のStarterでは、上の計算例を実行できません。TeamならGPU数の条件上は収まりますが、実際のスケジューリングには、空き状況、リージョンの選択、リクエストしたハードウェアも影響します。
Starterの$30クレジットを、GPUを30時間無料で使えるという意味に受け取らないでください。記載されているH100単価で計算すると、他のリソースを含める前の時点で、およそH100 GPU 7.6時間分に相当します。
Modal Clustersがコスト面で有利になるケース
Modal Clustersが力を発揮するのは、規模が大きく、断続的に実行され、常設環境の運用が重いジョブです。数時間だけ動いて消えるトレーニングバーストなら、数週間連続で稼働するクラスタよりも、使わないときにゼロまで縮小できるメリットを活かしやすくなります。
次のような用途に向いています。
- 全ノードを同時に起動する必要がある分散ファインチューニング。
- 高価なGPUキャパシティを使う短時間のトレーニングバースト。
- RDMAやモデル並列を必要とするマルチノード推論。
- Kubernetes、SLURM、手動のRDMA環境を自分たちで運用したくないPythonチーム。
モデルが1台のマシンに収まるなら、単一ノードのModal Functionのほうが適しています。利用率が予測しやすい場合、固定SLAが必要な場合、あるいは継続的なGPU 1時間あたりのコストを最小化したい場合は、専有またはリザーブドのインフラも本格的に比較すべきです。
実ユーザーの議論からも、使い分けの目安が見えてきます。コンピュータビジョンに関するスレッドで、u/Substantial_Camel735は、ベクトル検索はModalのワーカーで実行せず、VPSに置くことを推奨しています(Redditでの議論)。これはあくまで一人の実践者によるアーキテクチャ上の判断であり、プラットフォーム全体のベンチマークではありません。
「私たちはModalから離れようとしていますが、その設計は正しそうです。ただ、検索処理をModalのワーカーで行うことはないでしょう。ベクトルDBに対してVPS上で検索するだけで十分です」— u/Substantial_Camel735、r/computervision
大規模ジョブを起動する前に確認したい運用ポイント
- 割り当てるリソース全体で計算する。まず
size × 1ノードあたりのGPU数を計算し、その合計をワークスペースの同時実行数と比較します。 - 意味のある最小構成から始める。2ノードのテストなら、イメージ、NCCL、rank、ランデブーの問題を、32 GPUの起動で請求額が膨らむ前に見つけられます。
- RDMAとアプリケーションのデバッグを分ける。ワークロードが許すなら、まずRDMAなしで分散ジョブを検証し、その後
rdma=Trueを有効にして通信性能が効く経路を測定します。 - 永続ストレージにチェックポイントを保存する。rankの失敗やプリエンプトによって呼び出し全体が失敗する可能性があります。チェックポイントなしで再試行すると、高額な処理を最初からやり直すことになりかねません。
- CPU、メモリ、エグレスも予算に入れる。特にデータセットや出力がリージョンをまたぐ場合、GPUの計算は請求書の最初の一行にすぎません。
- リージョン固定が必要か判断する。配置先を絞ると、利用できるスケジューリングプールや料金倍率が変わる可能性があります。ローカリティを本当に必要な要件として測定し、最新のリージョン別料金ドキュメントと照合してください。
Modalの公式料金表では、RDMA自体を独立した追加料金としては掲載していません。RDMAの価値は性能にあります。同期が必要な学習や大容量のKVキャッシュ転送では、通常のTCP通信がボトルネックになることがあります。一方で、RDMA対応ハードウェアと配置に限定されるため、利用可能な容量は狭くなる可能性があります。
Modal Clustersに関するFAQ
Modal Clusters APIの専用料金はありますか?
クラスタ専用の追加料金は公開されていません。Modalは各コンテナが使用したGPU、CPU、メモリ、ストレージ、対象となるネットワーク使用量に対して課金します。
クラスタの最大サイズはどれくらいですか?
GA関連資料では、公開クラスタは最大32ノードまたは256 GPUまでと説明されています。それを超える要件についてはModalへの相談が必要です(GA発表)。ワークスペースの同時実行数とキャパシティの制約も適用されます。
Modal Clustersで推論は実行できますか?
できます。ただし、ワークロードがクラスタ実行モデルに適合している必要があります。マルチノード推論やモデル並列推論は、通常のHTTPエンドポイントよりも適した用途です。クラスタ化されたWeb Functionには、トラフィックがrank 0に届けられるなどの制約があります(クラスタのドキュメント)。
実際の選び方
| ワークロード | まず検討したい選択肢 |
|---|---|
| モデルが1基のGPUまたは1ノードに収まる | 通常のModal Function |
| 短時間で同期が必要なマルチノード学習バースト | 小規模テスト後のModal Clusters |
| 長時間にわたって予測可能な高稼働率で実行する | 専有またはリザーブドGPUキャパシティと比較 |
| GPU推論と同じ場所で検索・データベース処理も行う | 測定結果が同居を正当化しない限り、データサービスは分離 |
| 厳格なプライベートネットワーク要件またはセルフホスティング要件がある | 別のデプロイ方式を検討 |
Modal Clustersは、マルチノードGPUのオーケストレーションを始めやすくしますが、必ずしも安くなるわけではありません。サーバーレスの配置やPythonとの親和性によって開発・運用の工数を減らせる一方、継続的な利用率、リージョンの制約、クラスタ全体のリトライが請求額を大きく左右します。まずノード数を含めた全体のリソース量を計算し、そのうえで専有キャパシティに対する利便性の上乗せ分と比較してください。