 AIREITER
FinanceBenchは、SEC提出書類368件、約5万3,900ページ、質問150件で構成されるベンチマークだ。Mistralによれば、新しいAgentic Searchレイヤーは、検索のみのループでワンショットRAGを47〜53ポイント上回り、ナビゲーションまで含む完全なループでは最大59ポイントの回答精度向上を記録した。トークン使用量も最大で約3分の1削減されたという。ただし、精度には待ち時間という代償がある。完全ループのレイテンシはp90で154秒、平均で71秒に達する。
Mistral Agentic Searchは、2026年8月20日に発表された、提出書類、契約書、スキャン済みPDFのような複雑な企業向け文書コーパスのための検索レイヤーだ。Web検索の機能強化ではない。数分単位の処理時間を払ってでも精度を取りに行くための仕組みである。
Mistral Agentic Searchの仕組み
Mistral Agentic Searchは、既存のインデックスを5つのツールによる複数ステップのループで包む検索レイヤーだ。ツールはsearch、open、navigate、read、grepの5種類。2026年8月20日にリリースされ、Mistral Search Toolkitから利用できるほか、StudioとVibeのLibrariesにも組み込まれている。インデックスは自社で保持し、ファインチューニングは不要。通常のチャンク検索だけでは答えにくい質問を、エージェントの探索ループで処理する。
5つのツールで文書を掘り下げる
動作を理解するには、Mistralが示した1953年の米国国防支出の事例が分かりやすい。単発の検索では1〜6月の数値しか見つからず、7〜12月分を取りこぼした。一方、エージェント型の経路では2回の検索を実行し、treasury_bulletin_1954_02.pdfを特定。続いて15ページの表3を読み取り、12か月すべての数値を取得して、年間合計4万4,463百万ドルを返した。
| ツール | 役割 |
|---|---|
search | 候補となる情報源をインデックスから検索する |
open | 見つかった文書を開く |
navigate | 文書内のページ、表、セクションへ移動する |
read | 指定した場所の内容を抽出する |
grep | 特定のトークン、コード、識別子をパターン検索する |
ワンショットRAGは、固定数のチャンクを取得し、一度の処理で回答しなければならない。検索結果が弱くても、追加の文書を要求することはできない。これに対し、このループは情報源を比較し、脚注や表の参照先をたどり、不完全な結果から立て直せる。Mistralの主張は、トレードオフは処理の増加ではなく、無駄な再試行ややり取りの減少だというものだ。
ベンチマーク結果をどう読むべきか
発表には2種類のベンチマークが掲載されている。いずれもMistralによる報告で、チューニングなしのSearch Toolkit標準設定を使用したものだ。Mistral自身は、結果を「上限ではなく下限」と位置付けている。FinanceBench(Islam et al., 2023、GitHubで公開)は、SECの10-K、10-Q、8-K提出書類368件を使う。Mistralの集計では1件あたり約147ページで、質問は150件。Mistralの設定では、人間のラベルに合わせて調整したLLMで回答を判定している。
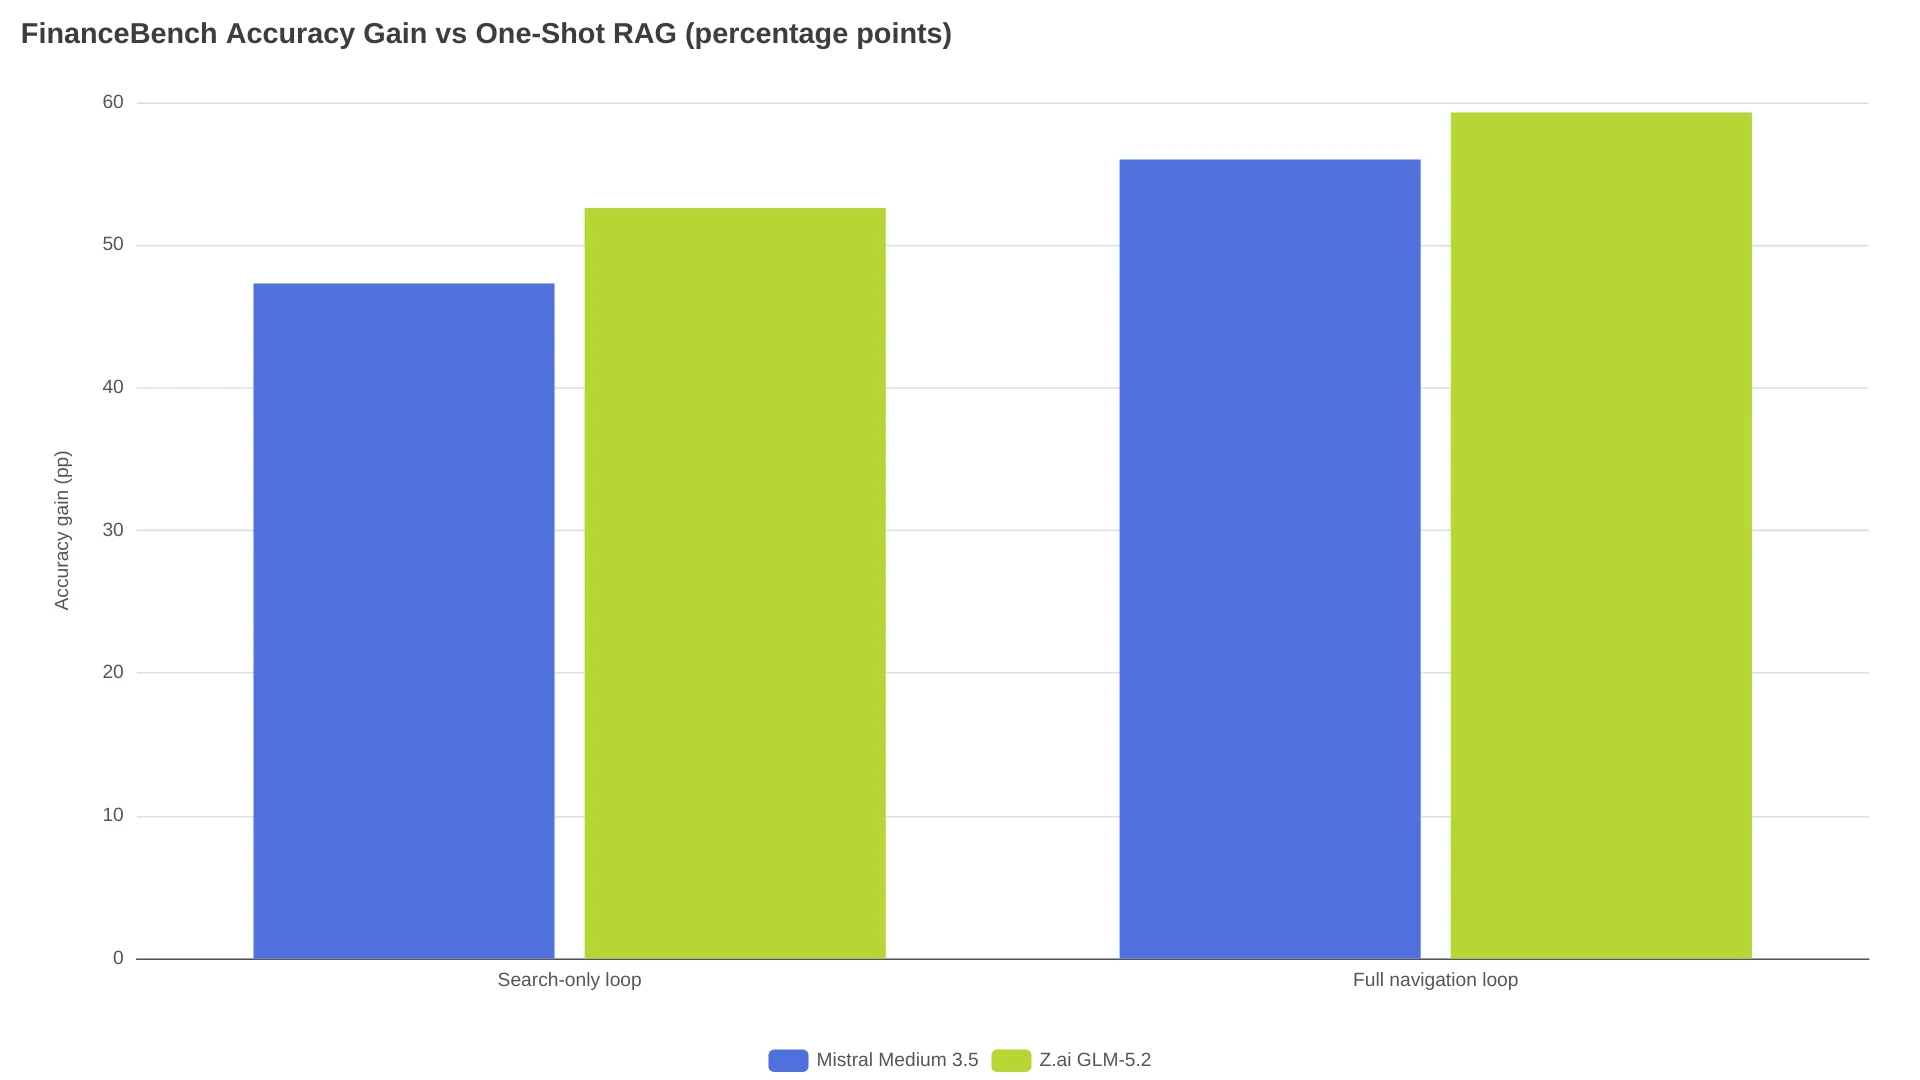
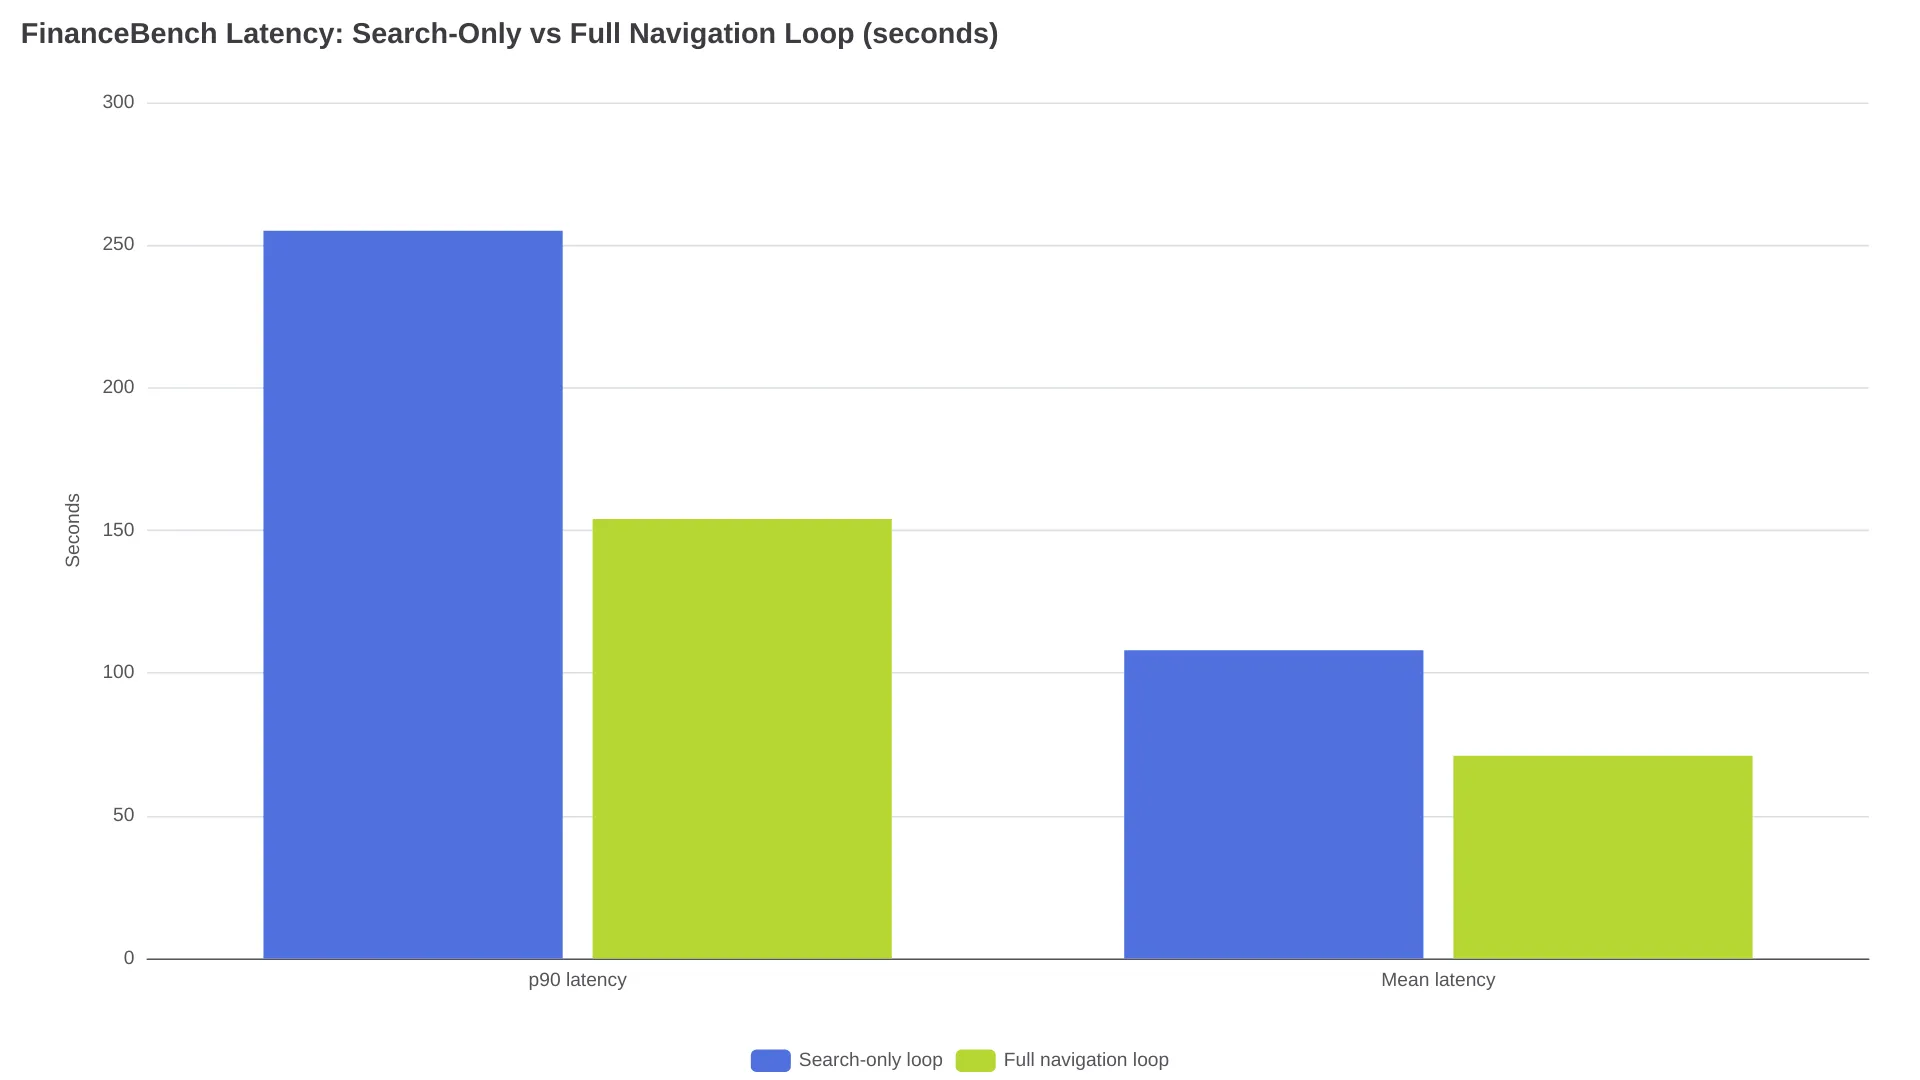
検索のみのループにナビゲーションツール、すなわちopen、navigate、read、grepを加えると、Mistral Medium 3.5ではさらに+8.7ポイント、GLM-5.2では+6.7ポイントを上積みした。完全なナビゲーションループは検索のみのループと比べ、Mistral Medium 3.5で23.9%、GLM-5.2で33.7%少ないトークンで済んだ。レイテンシも同じく改善し、p90は255秒から154秒へ、平均は108秒から71秒へ下がっている。ここで重要なのは比較対象だ。トークン削減率はワンショットRAGではなく、検索のみのエージェント型ループに対する数値である。
より難しいのがOfficeQA Proだ。過去の米国財務省Bulletin 696件、約8万9,000ページに及ぶ、表の多いスキャン済み政府PDFを対象に、133問を出題する。GLM-5.2は完全ループで51.9%の精度に到達し、+45.6ポイント改善した。これはワンショット時のベースラインが6.3%だったことを意味する。Mistral Medium 3.5も+27.1ポイント改善している。ナビゲーションによって、ターン数は最大7.0%削減された。
Mistralは自社のMistral Medium 3.5と、サードパーティのZ.ai GLM-5.2で検証し、どちらも同じ傾向で改善した。発表ではさらに、Kimiの研究として、GLM-5.2がClaude CodeのハーネスではOfficeQA Proで41.4%、Mistralのハーネスでは51.9%だったとも紹介している。ただし、一次情報となるKimiの資料へのリンクはない。そのため、この10.5ポイントのハーネス差はMistral側の説明として受け取るべきだ。Mistralの結論は「検索品質はモデル能力に応じて伸びる」であり、ボトルネックはモデルではなくハーネスにあるという見方だ。
ワンショットRAGを選ぶべきケース
Mistral自身も、インデックス検索が基盤であり、エージェント型ループは初回の検索結果だけでは足りない場合に使うものだとしている。判断基準は主に文書の性質と許容できるレイテンシだ。
| ワークロード | まず選ぶべき方法 |
|---|---|
| 短く整理された文書からの直接参照 | ワンショットRAG |
| 大量のキーワード検索または意味検索 | ワンショットRAG |
| 回答箇所があらかじめ分かっている | ワンショットRAG |
| 表や脚注を含む提出書類、契約書、マニュアル | Agentic Search |
| 表が多いスキャン済みPDF | Agentic Search |
| 複数文書に分散した回答を突き合わせる必要がある | Agentic Search |
| 対話的なレイテンシ要件がある(秒単位) | ワンショットRAG |
p90が154秒ではプロダクト要件を満たせないなら、精度が上がっても解決にはならない。一方、財務諸表をまとめて分析するようなバッチ処理なら、事情は異なる。
Agentic Searchとweb_searchは別物
この製品を検索すると、GoogleではMistralのwebsearch documentationが表示される。しかし、これは別の機能だ。web_searchとweb_search_premiumはAgents APIのツールで、引用付きのライブWeb検索を行う。MistralのAPI料金ページでは、モデルトークン料金に加え、それぞれ1,000コールあたり30ドル、50ドルで課金される。Agentic Searchは逆方向の仕組みであり、自社のインデックス済みコーパスを掘り下げるもので、オープンWebには問い合わせない。用途は異なり、公開価格があるのも片方だけだ。Agentic Searchの料金は、発表内のどこにも記載されていない。
始め方は2通り
- Search Toolkitを使う。取り込み、埋め込み、インデックス作成のためのオープンモジュール群。クラウドまたはオンプレミス環境にデプロイでき、パーサー、チャンク分割、埋め込みモデル、Vespaスキーマ、ランキングプロファイル、ハイブリッド検索を設定できる。
- StudioとVibeのLibrariesを使う。管理された導入経路だ。Search Starter Appなら、デフォルト設定で自社コーパスのローカルインデックスを構築できる。チューニング前にベンチマーク設定を再現するには、最も速い方法である。
どちらを選ぶ場合でも、実際の利用を代表する同じ質問群をワンショットRAGと完全ループの両方に通し、導入を決める前に回答品質、トークン使用量、p90レイテンシを比較したい。
リリース時点で未解決の点
MistralはAgentic Searchの価格を公開しておらず、ベンチマーク結果もベンダー自身による報告だ。リリース時点では、独立した実機検証の再現結果は存在しなかった。初期の公開反応も、まだ第一印象の段階にとどまる。
「mistral just added agentic search to their api is the right move. wrapping perplexity-style search into a native agent tool saves us from writing fragile web-scraping pipelines and managing proxy rotation ourselves.」 — @AbdoKerdawy、AIプロダクト開発者(X)
トークンに関する主張には、Mistralの発表だけでは十分に答えられていない疑問もすでに出ている。
「The Mistral agentic search retrieval tool claims to cut single-pass search failures by over 40%. If it bypasses database lookups, will it reduce the number of tokens you need to spend?」 — @therawlogs、独立系ブロガー(X)
公式の回答は、検索のみのループに対して24〜34%トークンを削減できたというものだ。それがベンチマーク用コーパスの外でも成立するかは、公開されているFinanceBenchセットで第三者が検証すれば明らかになる。
近接する製品も同じ物理的な制約に向き合っている。MixedbreadのToast-1 agentic searchモードは、ループを4ラウンド、並列検索呼び出しを8回に制限している。同社のドキュメントも、単発検索より遅いことを明記している。このカテゴリのベンダーが精度のために支払っているコストは、レイテンシである。
よくある質問
Mistral Agentic SearchはAgents APIから利用できる?
いいえ。Mistral Search Toolkitと、StudioおよびVibeのLibrariesから提供される。Agents APIのweb_searchツールは、別料金のライブWeb検索製品だ。
Agentic Searchは本当にトークン使用量を減らせる?
公式ベンチマークによると、FinanceBenchで完全なナビゲーションループは、検索のみのエージェント型ループより23.9〜33.7%少ないトークンを使用した。独立した再現検証はまだ公開されていない。
Agentic Searchで使えるモデルは?
MistralはMistral Medium 3.5とZ.ai GLM-5.2を検証し、どちらでも一貫した改善を確認した。レイヤーはモデル非依存で、ファインチューニングは不要だとしている。
Mistral Agentic Searchの価格はいくら?
Agentic Search自体の価格は公開されていない。Mistralの料金ページにある1,000コールあたり30ドルという価格は、従来のweb_searchエージェントツールのものだ。
未解決のトレードオフは単純だ。これは数分の処理時間を支払って精度を買う仕組みである。提出書類、契約書、スキャン済み政府記録を対象とするバッチ処理なら、OfficeQA ProとFinanceBenchの完全ループで示された+45〜+59ポイントの精度向上と、より遅いループに対する約3分の1のトークン削減は、合理的な交換条件になり得る。だが、ユーザー向けの用途では、平均71秒のレイテンシは依然として採用を難しくする。Mistral以外の誰かがFinanceBenchを再実行するまでは、このページでもっとも強い数値はベンダー自身の報告にとどまる。
関連記事:Mistralのテストで使われたもう一方のベンチマークモデルについては、GLM-5.2 API guideとGLM-5.2 reviewを参照。