 AIREITER
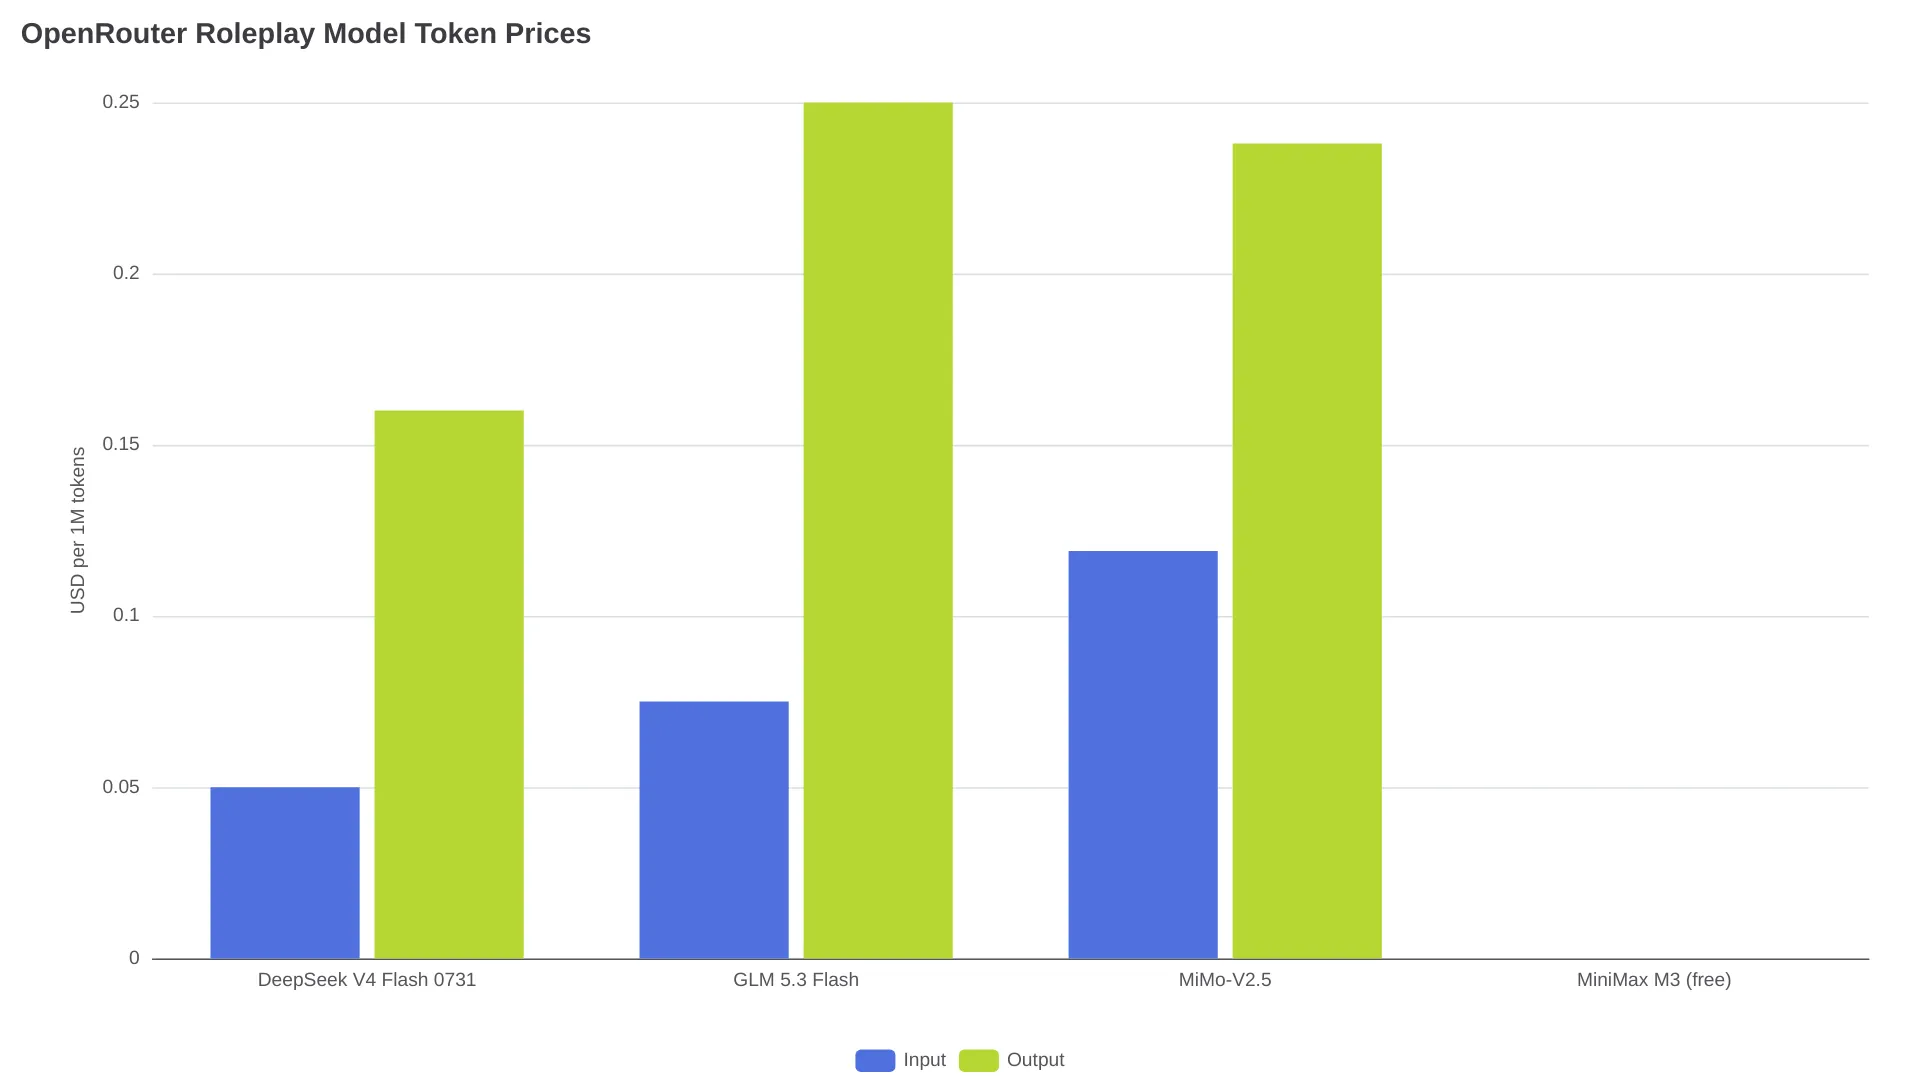
Per il roleplay su OpenRouter non esiste un modello migliore in assoluto: la scelta cambia se contano di più una voce coerente, una finestra di contesto molto ampia o una sessione senza costi. Nello snapshot del 2 settembre 2026, DeepSeek V4 Flash 0731 è il primo riferimento a pagamento da provare per rapporto tra costo e contesto: OpenRouter indica un contesto di classe 1M e prezzi di $0.05 in input / $0.16 in output per milione di token. Le route gratuite sono valide per fare prove, ma capacità e disponibilità possono variare.
Questa guida esamina comportamento tecnico e costi nel roleplay narrativo non esplicito. Non proclama un vincitore universale “uncensored” e non pubblica percentuali di rifiuto senza test controllati e comparabili.
Quale modello OpenRouter usare per il roleplay nel 2026
Conviene fissare un modello a pagamento e preparare un'alternativa gratuita attiva. La classifica per utilizzo è utile per individuare candidati, non è una graduatoria qualitativa.
| Scenario d'uso | Primo modello da valutare | Perché può essere adatto | Limite principale |
|---|---|---|---|
| Riferimento a pagamento per costo e contesto | DeepSeek V4 Flash 0731 | Contesto di classe 1M, $0.05/$0.16 per 1M token e traffico roleplay attuale su OpenRouter | L'utilizzo non equivale a un test RP controllato |
| Prova con priorità al gratuito | MiniMax M3 (free) | Presente nella raccolta live dei modelli gratuiti di OpenRouter, con contesto intorno a 1M | Capacità, limiti e disponibilità del gratuito possono cambiare |
| Confronto economico a pagamento | GLM 5.3 Flash | Contesto di classe 1M, 22 provider elencati e prezzo temporaneo di $0.075/$0.25 | Lo sconto è limitato nel tempo; il modello è posizionato per il lavoro agentico |
| Confronto di fascia intermedia | MiMo-V2.5 nella raccolta roleplay di OpenRouter | $0.119/$0.238 per 1M token e contesto da 1.05M nella scheda live | La pagina citata offre dati di catalogo e utilizzo, non un punteggio RP controllato |
| Fallback gratuito automatico | openrouter/free | Seleziona una route gratuita disponibile senza vincolarsi a uno slug fisso | Il modello effettivo può cambiare da una richiesta all'altra |
Usa DeepSeek come base di confronto a pagamento, verifica l'endpoint gratuito attuale di MiniMax M3 prima di farci affidamento e inserisci GLM 5.3 Flash come secondo controllo a pagamento. La selezione si basa su dati attuali di utilizzo, prezzo, contesto e routing, non su una classifica universale della qualità di scrittura.
Cosa indica davvero la classifica roleplay di OpenRouter
La raccolta Roleplay and Creative Writing di OpenRouter è una pagina di scoperta aggiornata in base all'utilizzo. Nella rilevazione del 2 settembre 2026, DeepSeek V4 Flash occupa il primo posto.
Questa posizione misura l'uso, non l'aderenza alla character card, la conservazione dei nomi, la qualità della prosa o il tasso di rifiuto. Un modello molto usato può essere semplicemente economico, veloce, disponibile presso molti provider o semplice da instradare.
Parti dalla raccolta per creare una rosa di candidati, poi esegui la stessa card sicura e la stessa scena iniziale con due model ID fissati. Il test risponde a una domanda più circoscritta: quale route funziona meglio con il tuo prompt, le tue impostazioni e il tuo budget?
La selezione attuale: contesto, prezzi e disponibilità
I dati riportati qui provengono dalle pagine roleplay, modelli gratuiti e singoli modelli di OpenRouter, controllate il 2 settembre 2026. Prezzi e stato gratuito sono istantanee operative.
| Model ID | Contesto indicato | Prezzo input / output per 1M | Route gratuita rilevata? | Cosa confermano i dati |
|---|---|---|---|---|
deepseek/deepseek-v4-flash-0731 | 1,310,720 | $0.05 / $0.16 | Controllare il catalogo live | Prezzo a pagamento indicato basso, 30 provider e failover automatico |
minimax/minimax-m3 | 1,048,576 | $0.23 / $0.96 a pagamento | Sì, elencato come MiniMax M3 (free) | Contesto ampio e test a costo zero quando l'endpoint gratuito è disponibile |
z-ai/glm-5.3-flash | 1,310,720 | $0.075 / $0.25 promozionale | Controllare il catalogo live | 22 provider e disponibilità al 99.89% su tre giorni nello snapshot |
xiaomi/mimo-v2.5 | 1.05M | $0.119 / $0.238 | Non stabilito dalla pagina citata | Segnale di utilizzo nella raccolta roleplay e prezzo a pagamento moderato |
openrouter/free | Pagina router: 200K | $0 | Router, non modello fisso | Comodo per esperimenti; la selezione casuale riduce la riproducibilità |
DeepSeek V4 Flash 0731: il riferimento per costo e contesto
DeepSeek V4 Flash 0731 offre un contesto di 1,310,720 token, fino a 393,216 token di completamento e prezzi indicati di $0.05 in input / $0.16 in output per milione di token. La pagina OpenRouter elenca 30 provider e descrive le modalità di routing Balanced, Nitro ed Exacto.
Prima di avviare una campagna lunga, provalo con la stessa card: la pagina del modello non pubblica un punteggio misurato di coerenza del personaggio.
MiniMax M3: candidato per una prova gratuita
La raccolta dei modelli gratuiti di OpenRouter riporta MiniMax M3 a $0 sia per input sia per output, con un contesto visualizzato di 1.05M. La pagina a pagamento di MiniMax M3 indica invece 1,048,576 token di contesto, input testuale/immagine/video, output testuale e prezzi a pagamento di $0.23 in input / $0.96 in output per milione di token.
La documentazione sulle Free Variant di OpenRouter spiega che una route :free può avere disponibilità e limiti di frequenza diversi dal modello a pagamento. Quando la riproducibilità è importante, seleziona lo slug gratuito preciso mostrato nel catalogo live; usa openrouter/free soltanto se accetti la selezione automatica.
GLM 5.3 Flash: l'opzione con più diversificazione tra provider
GLM 5.3 Flash ha una finestra di contesto di 1,310,720 token ed è indicato a $0.075 in input / $0.25 in output per milione di token grazie a uno sconto promozionale del 50% via Z.ai, valido fino al 9 settembre 2026 alle 16:00 UTC. La pagina OpenRouter riporta 22 provider e una disponibilità del 99.89% negli ultimi tre giorni.
La scheda presenta GLM 5.3 Flash come modello per coding efficiente e attività agentiche a lungo orizzonte, non in modo specifico per il roleplay. Verifica l'adattamento al RP usando lo stesso prompt, invece di dedurlo dalla descrizione commerciale.
MiMo-V2.5 e gli altri fallback
MiMo-V2.5 compare nella raccolta roleplay di OpenRouter con un contesto da 1.05M e prezzi di $0.119 in input / $0.238 in output. Può fungere da controllo di fascia intermedia, ma la pagina citata non pubblica risultati controllati sul roleplay. Salva un secondo slug esatto prima che una sessione fallisca: un fallback già scelto è più prevedibile di una sostituzione casuale del modello.
Il test dei costi su 1.000 turni: la gestione del contesto fa la differenza
Un turno di roleplay comprende un messaggio dell'utente e una risposta dell'assistente. OpenRouter fattura i token, quindi non esiste un prezzo universale per 1.000 turni: una parte rilevante della spesa dipende da quanta cronologia il frontend reinvia.
Questo modello di pianificazione considera 1.000 turni, 200 nuovi token utente per turno, 500 token di output dell'assistente per turno e un prompt fisso di sistema/personaggio da 2.000 token. Nello scenario con cronologia completa, le 1.000 richieste reinviano una conversazione in crescita, per un totale di circa 351.85M token in input e 0.5M token in output.
| Modello | Scenario con cronologia compatta: 4M input + 0.5M output | Scenario con cronologia completa: 351.85M input + 0.5M output |
|---|---|---|
| DeepSeek V4 Flash 0731 ($0.05/$0.16) | $0.28 | $17.67 |
| GLM 5.3 Flash ($0.075/$0.25) | $0.43 | $26.51 |
| MiMo-V2.5 ($0.119/$0.238) | $0.60 | $41.99 |
| MiniMax M3 a pagamento ($0.23/$0.96) | $1.40 | $81.41 |
| MiniMax M3 free | $0.00, soggetto a limiti | $0.00, soggetto a limiti |
La colonna della cronologia compatta presuppone una media di 4.000 token in input per richiesta. Con la cronologia completa, gli stessi messaggi iniziali vengono reinviati ripetutamente: ecco perché una finestra di contesto ampia non rende economica una campagna da 1.000 turni.
Con queste ipotesi, il prompt finale con cronologia completa raggiunge circa 701,500 token in input, prima di aggiungere formattazione e metadati. Una finestra da 1M può contenere questo esempio, ma risposte più lunghe, card più grandi, lorebook o template nascosti possono superarla. La capacità di contesto non equivale a memoria automatica.
Il prompt caching può ridurre il costo degli input ripetuti quando provider e percorso della richiesta lo supportano. Verifica la pagina Activity di OpenRouter anziché dare per scontato che ogni frontend riceva lo stesso trattamento della cache. La guida ai prezzi di OpenRouter spiega più in generale il modello di fatturazione basato sui token.
Cosa può misurare un test sicuro di coerenza, e cosa no
Un confronto non esplicito può usare un personaggio adulto fittizio, una scena innocua e impostazioni identiche per ciascun modello:
- Inserisci nella character card tre elementi persistenti, ad esempio professione, luogo e obiettivo non sensibile.
- Richiedi la narrazione in terza persona oppure un unico punto di vista chiaramente definito.
- Esegui 20 turni con lo stesso incipit e un limite di output tra 400 e 600 token.
- Ai turni 5, 10 e 20, chiedi al personaggio di agire in base a un fatto precedente senza ripeterlo.
- Annota modifiche dei nomi, fatti contraddittori, cambi indesiderati del punto di vista, ripetizioni, risposte vuote e rifiuti.
Questo confronto riguarda il tuo prompt e la tua route, non la qualità universale dei modelli. Un rifiuto può dipendere dal modello, dal provider, dal classificatore del frontend o dal prompt; per questo la guida non riporta un tasso di rifiuto. Per la velocità, registra la latenza del primo token e i token generati al secondo in tre esecuzioni identiche, annotando modello e route del provider.
Per quanto tempo il piano gratuito di OpenRouter può sostenere il roleplay?
La guida ufficiale di OpenRouter per SillyTavern afferma che gli account con meno di $10 di crediti acquistati ricevono 50 richieste giornaliere ai modelli gratuiti. Dopo aver acquistato almeno $10 di crediti, la guida indica un tetto di 1.000 richieste al giorno. Riporta inoltre un limite di 20 richieste al minuto.
Se una generazione dell'assistente corrisponde a un turno, si tratta di circa 50 turni al primo tentativo oppure 1.000 turni al primo tentativo al giorno. Anche rigenerazioni, retry, richieste fallite e workflow con più messaggi consumano richieste, quindi le scene completate possono essere meno numerose.
Le due opzioni gratuite si comportano in modo diverso:
model-name:freeblocca la variante gratuita di un modello nominato. Offre maggiore riproducibilità, ma l'endpoint può sparire o subire rate limit.openrouter/freeseleziona automaticamente un modello gratuito idoneo. La documentazione del Free Models Router di OpenRouter afferma che, dopo il filtro per capacità, la selezione è casuale e che la risposta identifica il modello effettivo. È pratico per gli esperimenti, ma la voce del personaggio può cambiare tra richieste diverse.
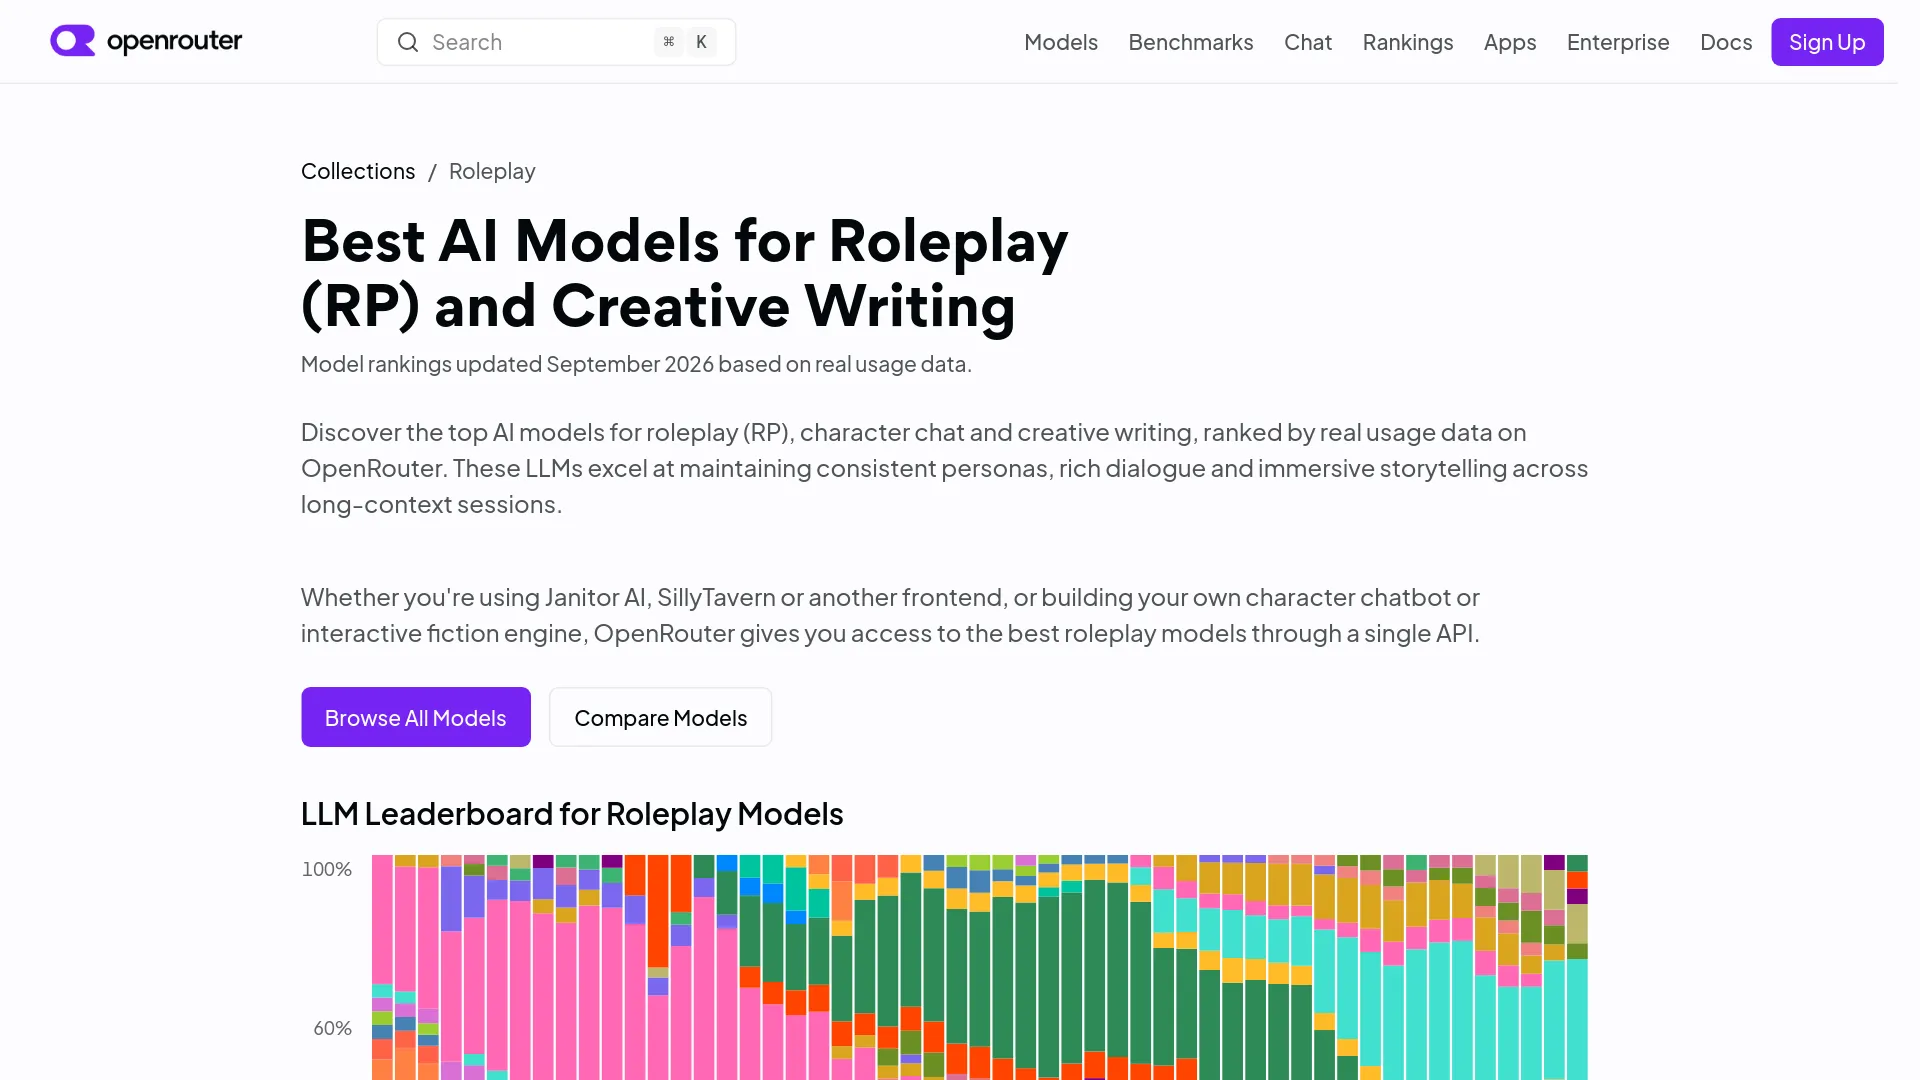
Prima di configurare un frontend, controlla la raccolta live dei modelli gratuiti di OpenRouter. Non costruire una campagna lunga attorno a uno slug gratuito copiato da una guida datata.
Configurare SillyTavern per una sessione OpenRouter stabile
Il flusso ufficiale OpenRouter usa Chat Completion, non Text Completion. Una connessione riuscita con la chiave non garantisce comunque che modello, route del provider o dimensione del contesto selezionati riescano a generare una risposta.
- Apri il pannello API Connections di SillyTavern.
- Seleziona API Type: Chat Completion.
- Seleziona Source: OpenRouter.
- Autorizza attraverso il flusso disponibile oppure incolla una API key creata nelle impostazioni delle chiavi di OpenRouter.
- Fai clic su Connect, scegli lo slug esatto del modello e invia un Test Message.
- Salva un profilo di connessione per il modello a pagamento e uno per il fallback gratuito.
Inizia con una dimensione del contesto supportata dall'endpoint esatto, streaming attivo e un limite di output moderato. Mantieni compatta la character card e riassumi i turni vecchi prima che il prompt si avvicini al limite dell'endpoint. Prova separatamente le impostazioni di sampling, perché possono modificare lunghezza e ritmo dell'output.
Se il menu a discesa è vuoto, riconnetti l'account e aggiorna la lista dei modelli. Se la connessione riesce ma la generazione fallisce, verifica slug, crediti, disponibilità del provider e overflow del contesto prima di riscrivere il prompt.
Configurazione di JanitorAI e correzione degli errori
L'API di OpenRouter è compatibile con OpenAI. L'endpoint standard chat-completions documentato nel Quickstart di OpenRouter è:
https://openrouter.ai/api/v1/chat/completionsL'articolo non si basa su una schermata aggiornata dell'interfaccia di JanitorAI. Usa quindi i passaggi seguenti come schema generico per un'integrazione compatibile con OpenAI e verifica i campi presenti nella schermata attuale di JanitorAI:
- Crea una API key OpenRouter e mantienila privata.
- Scegli l'opzione OpenAI-compatible o custom API attualmente disponibile.
- Inserisci l'URL completo chat-completions se il campo richiede un endpoint di completamento.
- Incolla il model ID OpenRouter esatto e aggiornato, incluso
:freeper una variante gratuita. - Salva, aggiorna JanitorAI e prova con un breve messaggio non esplicito.
| Sintomo | Causa probabile | Primo intervento |
|---|---|---|
| 401 o token non valido | La chiave è errata, scaduta o incollata con caratteri aggiuntivi | Rigenera la chiave e incollala di nuovo; non usare una chiave pubblica condivisa |
| 404 o nessun endpoint | Lo slug del modello o l'URL non sono aggiornati | Copia lo slug corrente da OpenRouter e verifica l'endpoint completo |
| 429 | Limite giornaliero/al minuto dei modelli gratuiti oppure sovraccarico del provider | Attendi, riduci i retry, passa al fallback fissato o usa una route a pagamento |
| Risposta vuota | Route non supportata, limite di output o overflow del contesto | Riduci le impostazioni di contesto/output e prova il modello direttamente in OpenRouter |
| Il bot dimentica l'inizio | Il frontend ha troncato la cronologia precedente | Riduci il prompt, riassumi i turni più vecchi e adegua il contesto a quello dell'endpoint |
| Rifiuto o cambio improvviso di stile | Policy del provider o route di fallback diversa | Controlla modello/provider effettivi e usa un prompt di test neutro; “uncensored” non è una garanzia |
Privacy, routing dei provider e conformità
Le FAQ di OpenRouter indicano che vengono registrati metadati di base delle richieste, come timestamp, modello e conteggi token, mentre prompt e completamenti non sono salvati per impostazione predefinita a meno che l'utente non scelga di aderire. I provider a monte possono applicare politiche proprie di conservazione e training.
Zero Data Retention può limitare il routing ai provider che rispettano il criterio di conservazione selezionato, ma potrebbe rimuovere alcune route gratuite. L'accesso gratuito non garantisce la privacy e “uncensored” non è una proprietà tecnica stabile: i provider possono applicare policy proprie e il routing può cambiare il provider che serve una richiesta.
Usa prompt fittizi non espliciti e non tentare di aggirare le protezioni dei provider.
FAQ
Qual è al momento il miglior modello OpenRouter per il roleplay?
In questo snapshot, DeepSeek V4 Flash 0731 è il riferimento a pagamento da confrontare per costo e contesto. Combina dati di utilizzo roleplay attuali su OpenRouter, un contesto di classe 1M e prezzi di $0.05/$0.16 per milione di token, ma non rappresenta un punteggio universale ottenuto tramite test controllati.
Qual è il miglior modello OpenRouter gratuito per roleplay?
Non esiste un vincitore permanente: MiniMax M3 è il candidato da provare per primo tra i gratuiti nella raccolta live verificata qui, mentre openrouter/free è più pratico ma meno riproducibile.
Quanto costano 1.000 turni di roleplay?
Con le ipotesi di questa guida, l'uso con cronologia compatta costa circa $0.28 su DeepSeek V4 Flash 0731 e $0.43 su GLM 5.3 Flash; l'uso con cronologia completa è stimato rispettivamente in $17.67 e $26.51.
Una finestra di contesto più grande evita che il modello dimentichi?
No. Il contesto è il massimo che l'endpoint può accettare, non una garanzia che ogni dettaglio venga utilizzato correttamente; riassunti e limiti ai turni recenti restano importanti.
Perché il mio modello di roleplay ha rifiutato o cambiato comportamento?
Potrebbero essere cambiati provider, route di fallback, endpoint gratuito o limite pratico del contesto. Verifica quindi model ID e route effettivi prima di considerare un singolo rifiuto una caratteristica generale del modello.
Esegui la stessa card sicura da 20 turni su DeepSeek V4 Flash 0731 e su un endpoint gratuito attuale, poi salva entrambi come profili nominati. La route a pagamento offre prezzi e disponibilità più prevedibili; quella gratuita permette di sperimentare al costo di capacità e identità del modello variabili.