 AIREITER
Muse Glimmer è arrivato il 10 agosto 2026 e la community dell'AI locale ha subito messo alla prova questo modello multimodale dense da 30B: può davvero prendere il posto di Qwen 3.6 27B su hardware consumer? In breve, entra su una singola RTX 3090 mantenendo l'intero contesto da 262K e raggiunge 236 tok/s su RTX 5090 con DFlash. Tuttavia, su TerminalBench 2.1 resta 9 punti sotto Qwen 3.6 27B e tende a rifiutare i compiti di automazione a livello di sistema operativo.
Muse Glimmer 30B: cos'è e a cosa serve
Muse Glimmer è un modello multimodale dense da 30B di parametri, pubblicato da Meta Superintelligence Labs con licenza Apache 2.0. È pensato per workflow agent residenti in locale, non per inseguire la vetta delle classifiche di coding. Abbina un decoder testuale da 27.9B a un encoder visivo ViT da 1.9B e a un proiettore multimodale basato su GELU, offrendo quindi comprensione sia del testo sia delle immagini. I dettagli dell'architettura riportati qui sotto provengono dal post sul supporto Day-0 di SGLang.
Architettura in sintesi
| Specifiche | Dettagli |
|---|---|
| Parametri totali | 30B |
| Decoder testuale | 27.9B dense |
| Encoder visivo | ViT da 1.9B |
| Layer Transformer | 52 |
| Attenzione | Grouped-query (32 query head, 2 KV head - GQA 16:1) |
| Feed-forward | SwiGLU |
| Finestra di contesto | 128K+ (testata fino a 262K) |
| Licenza | Apache 2.0 |
L'architettura adotta un sistema di attenzione ibrido: tre layer di sliding-window attention da 2.048 token, seguiti a ogni quarto passaggio da un layer di attenzione sull'intera sequenza. Il progetto combina RoPE nei layer a finestra locale e NoPE nei layer full-attention, così da estendere il contesto oltre il limite di addestramento. Il rapporto di grouped-query attention 16:1 riduce la cache KV: una misurazione della community indica circa 1.8 GiB per 131K token in F16. Ecco perché il modello riesce a mantenere il contesto completo su una GPU da 24 GB, mentre Qwen 3.6 27B, nella stessa configurazione F16, si ferma a 70K token.
Su quale hardware può girare Muse Glimmer?
Dipende soprattutto dalla quantizzazione scelta. SGLang mette a disposizione checkpoint ufficiali nei formati BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic e MLX 4-bit. Per configurazioni con VRAM estremamente limitata, alcuni test della community hanno anche spinto il modello fino a GGUF a 2 bit.
VRAM richiesta in base alla configurazione
| Configurazione | VRAM approssimativa | Hardware di riferimento |
|---|---|---|
| BF16 | ~60 GB | Singola H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + contesto 262K | ~22-23 GB | RTX 3090 (24 GB) |
| GGUF a 2 bit | ~14 GB | RTX 4060 Ti / fascia inferiore |
| MLX Q4 (Apple Silicon) | Memoria unificata | Mac mini / MacBook Pro |
Un utente Reddit ha dimostrato che Muse Glimmer in Q4_K_XL, con speculative decoding DFlash, file di proiezione multimodale e cache KV F16, entra senza difficoltà in 22-23 GB su una sola RTX 3090, con l'intero contesto da 262.144 token attivo. Al primo tentativo ha recuperato due aghi da un pagliaio di circa 150K token.
Per confronto, sulla stessa RTX 3090 Qwen 3.6 27B arriva soltanto a 70K token con cache KV F16, oppure 125K con cache KV Q8. Gemma 4 31B raggiunge 52K in F16, oppure 81K in Q8. Il principale motivo per cui Muse Glimmer conserva più contesto a parità di hardware è l'efficienza della sua cache KV, dovuta al rapporto GQA 16:1.
Come configurarlo: Su NVIDIA, usa SGLang o llama.cpp con il checkpoint NVFP4 o GGUF e attiva --speculative-algorithm DFLASH. Su Apple Silicon, usa il backend MLX, dove DFlash non è disponibile. Un utente con M3 Max e 96 GB di memoria unificata ha riportato 17 token/s, osservando che Muse Glimmer era più veloce sia di Qwen sia di Gemma su quel sistema.
Prestazioni di Muse Glimmer: quanto è veloce?
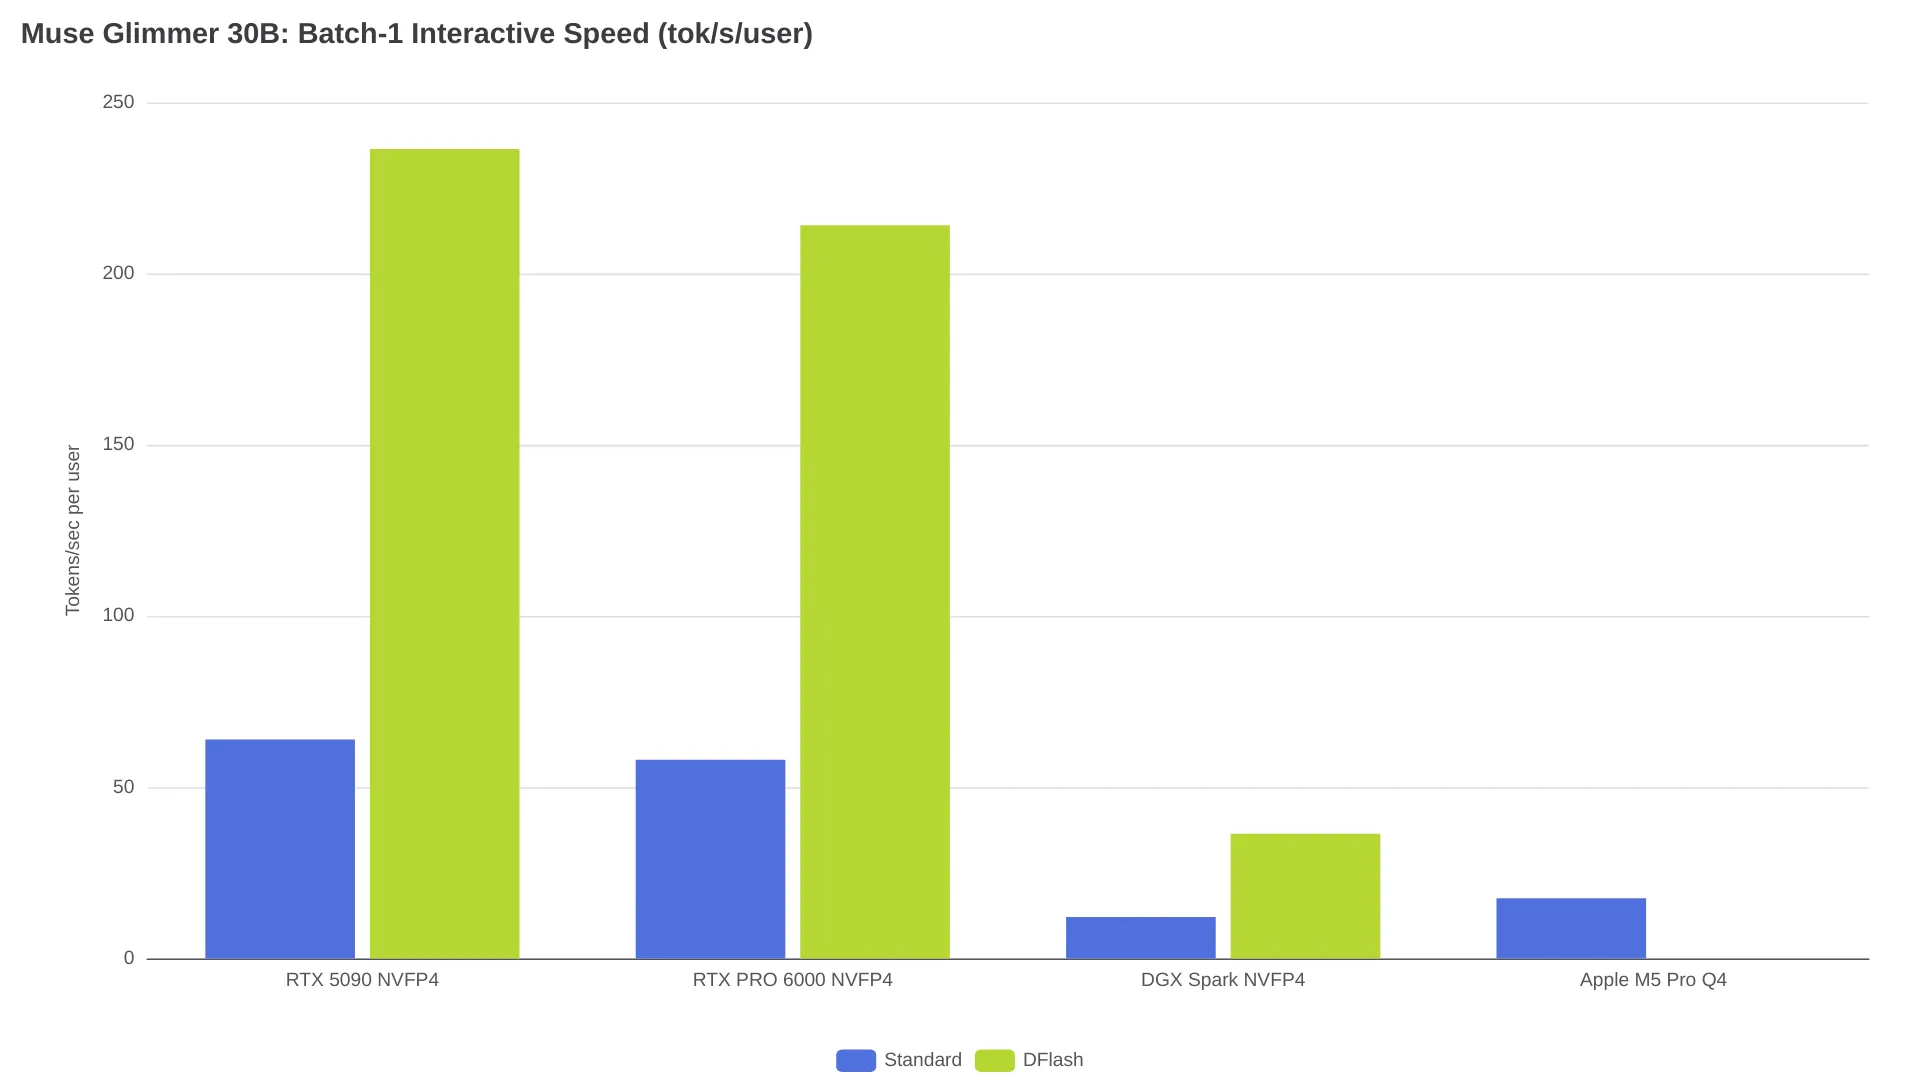
SGLang ha pubblicato una tabella di benchmark su sette configurazioni hardware, con batch size da 1 a 8. Il decoding speculativo DFlash, attivabile con --speculative-algorithm DFLASH, offre sulle piattaforme NVIDIA un incremento da 1.9x a 4.3x del throughput interattivo con batch 1.
I numeri chiave dei benchmark SGLang
| Piattaforma | Precisione | Decoding | tok/s/utente con batch 1 | tok/s con batch 8 |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
I 1,452 token in output al secondo con batch 8 su RTX 5090 rappresentano il throughput aggregato. Per l'inferenza locale di un singolo utente, il dato rilevante è 236 tok/s con DFlash in NVFP4. Senza DFlash, la stessa configurazione scende a 63.9 tok/s. I riscontri della community sono coerenti: un utente con RTX 5090 e quantizzazione Q5_K_M di Unsloth ha riportato 220-253 token/s.
Le prestazioni di DFlash dipendono dal tasso di accettazione delle bozze: utenti con Vulkan/RX 7900 XTX e SYCL/B70 hanno entrambi segnalato una bassa accettazione delle bozze e un throughput complessivo più lento.
Muse Glimmer o Qwen 3.6 27B: quale scegliere?
Punteggi in TerminalBench 2.1
| Modello | TerminalBench 2.1 | Contesto su RTX 3090 (KV F16) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K token |
| Muse Glimmer 30B | 51.7 | ~262K token |
| Gemma 4 31B | 43.4 | ~52K token |
I punteggi di TerminalBench 2.1 sono citati in una discussione della community. I dati sul contesto provengono da test su RTX 3090.
Qwen 3.6 27B guida TerminalBench 2.1 con 9 punti di vantaggio, il benchmark che molti membri della community considerano decisivo per capire se un modello sa eseguire comandi da terminale affidabili lungo task complessi. Anche nei test diretti di coding il divario resta costante: nella suite di valutazione privata di un utente, Qwen ha ottenuto 12/13 contro 11/13 di Glimmer. Qwen ha inoltre generato correttamente al primo tentativo una pagina sul turismo a Tokyo di 953 righe, mentre Glimmer è rimasto sotto le 200 righe (thread completo).
"Nemmeno lontanamente al livello di Qwen 3.6 27B" - utente Reddit BarberIcy366, dopo che Glimmer aveva prodotto soltanto 220 righe di HTML per un gioco di palla 8 consumando 21,000 token (r/LocalLLaMA). Nello stesso thread viene riportato che Qwen 3.6 27B ha completato un'implementazione di Tetris 1.7x più velocemente con MTP attivo.
Glimmer offre però vantaggi concreti in alcuni scenari:
- Capacità di contesto: 262K token su una singola RTX 3090 contro i 70K di Qwen con la stessa impostazione KV F16, un vantaggio di 3.7x per il lavoro su codebase molto grandi.
- Efficienza della cache KV: il rapporto GQA 16:1 rende la cache KV di Glimmer molto più piccola, lasciando più VRAM al contesto.
- Supporto visivo: Glimmer è multimodale fin da subito; Qwen 3.6 27B, nella sua forma base, è solo testuale.
- MCP e Q&A con strumenti: un utente ha riferito che, pur restando dietro Qwen nel coding da terminale, Glimmer mostra potenziale nei workflow di ricerca in codebase e domande-risposte assistiti da MCP.
- Qualità della scrittura: più utenti hanno preferito l'output in linguaggio naturale di Glimmer rispetto a quello di Qwen.
Un commentatore ha sintetizzato il compromesso così: Glimmer è "Qwen 3.6 27B con +5% nello stile di scrittura e -5% nelle capacità agentiche".
In conclusione
Se il tuo carico di lavoro principale è il coding one-shot o l'uso di agent autonomi da terminale, Qwen 3.6 27B resta la scelta più solida: ha ottenuto 9 punti in più su TerminalBench 2.1 e non manifesta i rifiuti di sicurezza che penalizzano Glimmer nell'automazione a livello di sistema operativo. Se invece ti servono recupero su contesti lunghi, input multimodale o workflow assistiti da MCP su una singola GPU consumer, vale la pena provare Muse Glimmer. Per un'automazione da terminale affidabile, meglio attendere i fine-tune della community.
Problemi noti e aspetti da tenere presenti
La trappola di max_tokens
Muse Glimmer utilizza una parte significativa del proprio budget di token per il ragionamento interno prima di produrre l'output. Se max_tokens è impostato troppo in basso, il modello può esaurire il budget a metà ragionamento e restituire una risposta vuota. Un utente aveva inizialmente assegnato a Glimmer 6/13 nella propria suite di valutazione; aumentando il budget di token in output, il punteggio è salito a 11/13 (thread di origine). Imposta max_tokens abbastanza in alto da coprire l'overhead del ragionamento, altrimenti le risposte potrebbero interrompersi a metà.
Rifiuti di sicurezza nell'automazione del sistema operativo
Più utenti segnalano che Muse Glimmer rifiuta task che coinvolgono il controllo del mouse, l'automazione della tastiera o altre chiamate a strumenti a livello di sistema operativo. Il modello li interpreta come potenziali rischi per la sicurezza, anche quando la richiesta riguarda l'uso di normali librerie Python.
"Spostare un mouse via codice può essere usato impropriamente per automazione, clickjacking o per aggirare prompt di sicurezza." - rifiuto di Muse Glimmer riportato dall'utente Reddit Cold_Tree190 (r/LocalLLaMA)
Avviare una nuova sessione fornendo più contesto sull'uso previsto può talvolta risolvere il rifiuto. In una sessione in cui il modello ha già negato la richiesta, però, tende a mantenere la propria posizione.
Tool calling non sempre coerente
Le segnalazioni della community sull'affidabilità del tool calling spaziano da "non ha fallito nemmeno una volta" su una codebase C a loop infiniti e risposte API vuote in altre configurazioni. Le quantizzazioni Unsloth Q4 e Q5 sono state segnalate per loop frequenti durante il tool calling in alcuni setup, mentre i GGUF ufficiali destinati a 24 GB e 32 GB di VRAM potrebbero comportarsi in modo più affidabile (thread di origine).
Limitazioni regionali per il download
La pagina ufficiale su Hugging Face disabilita, secondo le segnalazioni, i download a Hong Kong, Macao e in Cina. Come alternativa restano disponibili le distribuzioni GGUF di terze parti di Unsloth.
Approfondimenti correlati: Guida ai prezzi API di Muse Spark 1.2 | I migliori modelli OpenRouter gratuiti per programmare nel 2026