 AIREITER
Su FinanceBench (368 documenti SEC, circa 53.900 pagine e 150 domande), Mistral sostiene che il nuovo livello Agentic Search aumenti l’accuratezza delle risposte di 47-53 punti percentuali rispetto a un RAG one-shot con ciclo limitato alla ricerca, arrivando fino a +59 punti con il ciclo completo di navigazione. Il consumo di token scende invece fino a un terzo. Il rovescio della medaglia è la latenza: il ciclo completo richiede ancora 154 secondi al p90 e 71 secondi in media.
Mistral Agentic Search, annunciato il 20 agosto 2026, è un livello di recupero pensato per corpus aziendali complessi, come documenti finanziari, contratti e PDF scansionati. Non è un potenziamento della ricerca web: quei minuti di elaborazione sono il prezzo da pagare per ottenere risposte più accurate.
Che cos’è Mistral Agentic Search
Mistral Agentic Search è un livello di recupero rilasciato il 20 agosto 2026, che trasforma un indice esistente in un ciclo multi-step basato su cinque strumenti: search, open, navigate, read e grep. È disponibile tramite il Mistral Search Toolkit ed è integrato nelle Libraries di Studio e Vibe. L’indice resta sotto il tuo controllo e non serve alcun fine-tuning: è il ciclo dell’agente a gestire le domande per cui il semplice recupero di chunk non basta.
Come funziona il ciclo a cinque strumenti
Il modo più semplice per capire il meccanismo è guardare all’esempio proposto da Mistral: la spesa per la difesa nazionale statunitense nell’anno solare 1953. Una singola chiamata di ricerca aveva trovato i dati da gennaio a giugno, ma non quelli da luglio a dicembre. Il percorso agentico ha eseguito invece due ricerche, individuato treasury_bulletin_1954_02.pdf, quindi letto pagina 15 e Tabella 3, restituendo tutti i dodici valori mensili per un totale annuo di 44.463 milioni di dollari.
| Strumento | Funzione |
|---|---|
search | Cerca nell’indice le fonti più probabili |
open | Apre un documento individuato |
navigate | Si sposta tra pagine, tabelle e sezioni del documento |
read | Estrae il contenuto presente in quella posizione |
grep | Trova corrispondenze esatte per token, codici o identificativi |
Con un RAG one-shot si recupera un insieme fisso di chunk e si deve rispondere in un unico passaggio: se i risultati iniziali sono deboli, il sistema non può chiedere un altro documento. Il ciclo agentico, invece, può confrontare più fonti, seguire i riferimenti in note e tabelle e recuperare informazioni mancanti da risultati parziali. Secondo Mistral, il vantaggio consiste nel ridurre tentativi e passaggi sprecati, non nell’aumentarli.
Cosa mostrano davvero i benchmark
L’annuncio presenta due suite di benchmark, entrambe realizzate e riportate da Mistral usando le impostazioni predefinite del Search Toolkit e senza tuning. La stessa azienda precisa che si tratta di «risultati che rappresentano un punto di partenza, non un limite massimo». FinanceBench (Islam et al., 2023; disponibile pubblicamente su GitHub) comprende 368 documenti SEC 10-K, 10-Q e 8-K, circa 147 pagine ciascuno secondo il conteggio di Mistral, e 150 domande valutate nella configurazione Mistral da un LLM calibrato su etichette umane.
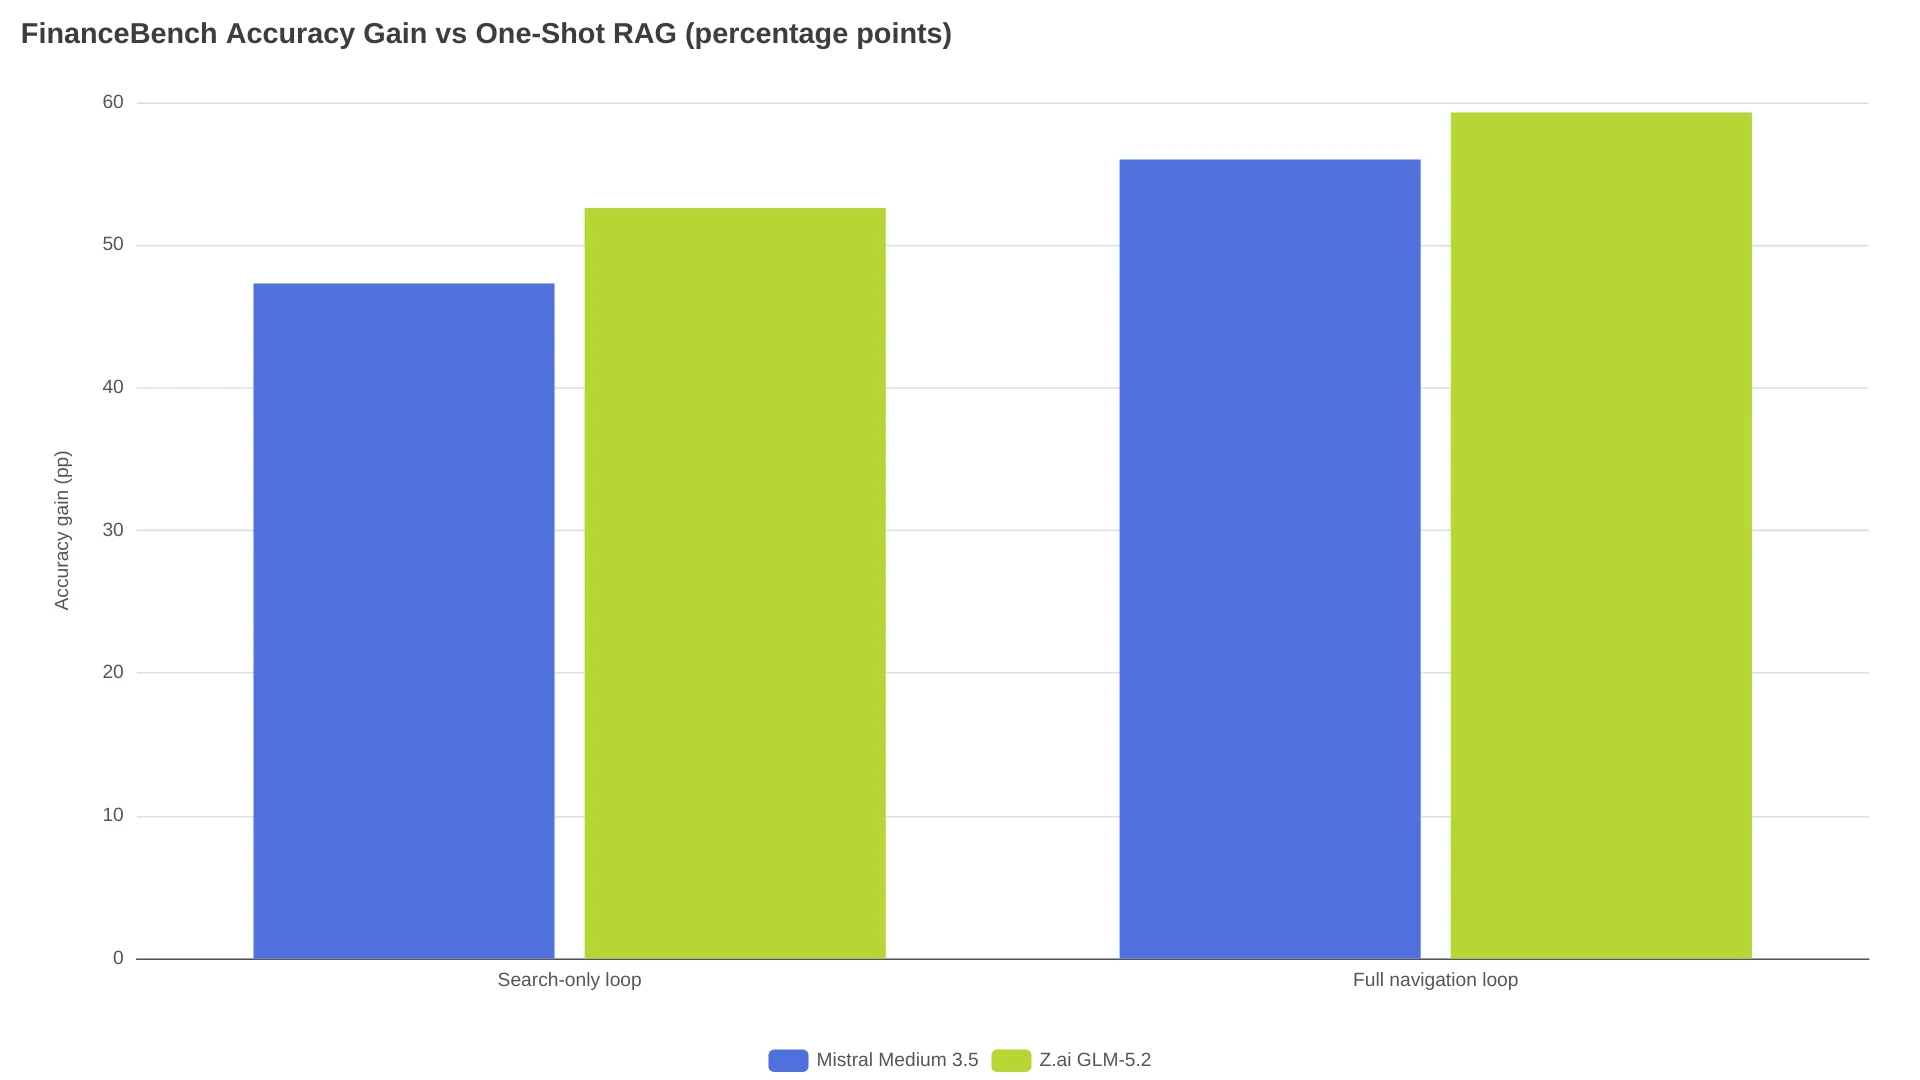
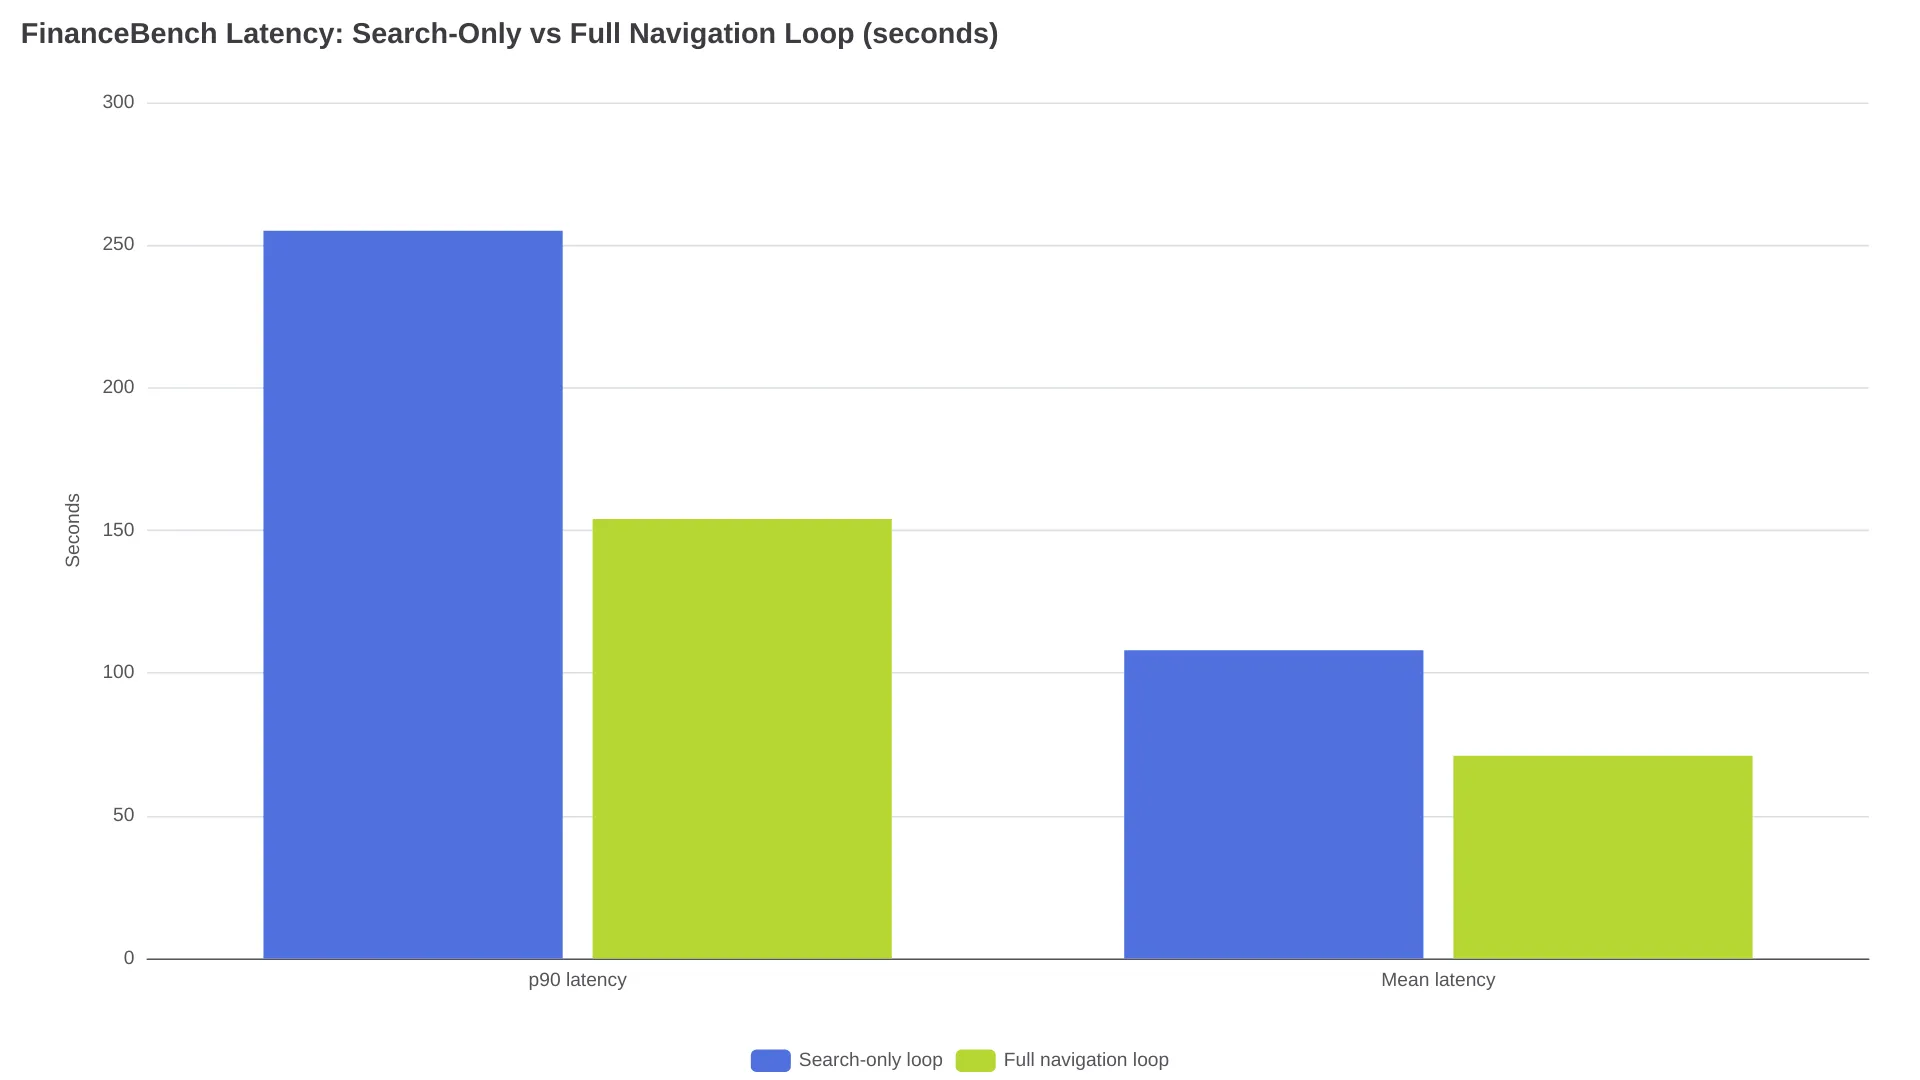
Aggiungere gli strumenti di navigazione (open, navigate, read, grep) al ciclo limitato alla ricerca porta un ulteriore +8,7 punti percentuali con Mistral Medium 3.5 e +6,7 punti con GLM-5.2. Rispetto al ciclo search-only, il percorso completo usa il 23,9% di token in meno con Mistral Medium 3.5 e il 33,7% in meno con GLM-5.2. Anche la latenza migliora: il p90 scende da 255 a 154 secondi, mentre la media passa da 108 a 71 secondi. È importante tenere presente il confronto: la riduzione dei token è misurata rispetto al ciclo agentico limitato alla ricerca, non rispetto al RAG one-shot.
OfficeQA Pro è la suite più impegnativa: 696 bollettini storici del Tesoro statunitense, circa 89.000 pagine di PDF governativi scansionati e ricchi di tabelle, oltre a 133 domande. Con il ciclo completo, GLM-5.2 raggiunge un’accuratezza del 51,9%, con un aumento di +45,6 punti che implica una baseline one-shot del 6,3%; Mistral Medium 3.5 migliora invece di +27,1 punti. La navigazione riduce i passaggi fino al 7,0%.
Mistral ha eseguito i test con il proprio Mistral Medium 3.5 e con il modello di terze parti Z.ai GLM-5.2, ottenendo in entrambi i casi lo stesso tipo di miglioramento. L’annuncio cita anche una ricerca di Kimi, secondo cui GLM-5.2 raggiungerebbe il 41,4% su OfficeQA Pro con un harness Claude Code, contro il 51,9% ottenuto con l’harness di Mistral. Non essendo disponibile alcuna fonte primaria di Kimi, la differenza di 10,5 punti tra gli harness va considerata una caratterizzazione di Mistral. La conclusione dell’azienda — «la qualità del recupero cresce con le capacità del modello» — suggerisce che il collo di bottiglia sia l’harness, non il modello.
Quando il RAG one-shot resta la scelta migliore
La stessa Mistral considera il recupero indicizzato la base del sistema e vede il ciclo agentico come una soluzione per i casi in cui i risultati iniziali non sono sufficienti. La scelta dipende soprattutto dal tipo di documenti e dal budget di latenza:
| Tipo di carico | Punto di partenza consigliato |
|---|---|
| Ricerche dirette in documenti brevi e ordinati | RAG one-shot |
| Recupero semantico o per parole chiave ad alto volume | RAG one-shot |
| Risposte contenute in posizioni note | RAG one-shot |
| Documenti finanziari, contratti e manuali con tabelle e note | Agentic Search |
| PDF scansionati e ricchi di tabelle | Agentic Search |
| Risposte distribuite su più documenti da confrontare | Agentic Search |
| Esigenze di latenza interattiva, nell’ordine dei secondi | RAG one-shot |
Se un p90 di 154 secondi rende il prodotto inutilizzabile, nessun guadagno di accuratezza può compensare il problema. Per l’analisi batch dei bilanci, però, il quadro è diverso.
Agentic Search non è lo strumento web_search
Cercando questo prodotto, Google porta alla documentazione websearch di Mistral: si tratta di un’altra cosa. Gli strumenti web_search e web_search_premium appartengono all’Agents API e recuperano contenuti dal web in tempo reale con citazioni. Il loro costo, indicato nella pagina dei prezzi delle API di Mistral, è rispettivamente di 30 e 50 dollari ogni 1.000 chiamate, a cui si aggiungono i token del modello. Agentic Search va nella direzione opposta: analizza il tuo corpus indicizzato e non interroga il web aperto. I due strumenti risolvono problemi diversi e solo uno dispone di prezzi pubblicati; nell’annuncio non compare alcuna tariffa per Agentic Search.
Due modi per iniziare
- Search Toolkit. Moduli aperti per ingestione, embedding e indicizzazione, distribuibili in cloud o on-premise, con parser, chunking, modelli di embedding, schemi Vespa, profili di ranking e recupero ibrido configurabili.
- Libraries di Studio e Vibe. È il percorso gestito: una Search Starter App può creare un indice locale sul tuo corpus usando la configurazione predefinita. È il modo più rapido per riprodurre l’impostazione del benchmark prima di intervenire con il tuning.
Qualunque strada tu scelga, sottoponi le stesse domande rappresentative al RAG one-shot e al ciclo completo, quindi confronta qualità delle risposte, consumo di token e latenza p90 prima di prendere una decisione.
Cosa non sappiamo ancora al lancio
Mistral non ha pubblicato i prezzi di Agentic Search e i risultati dei benchmark sono riportati dal fornitore; al momento del lancio non era disponibile alcuna replica indipendente. Le prime reazioni pubbliche sono quindi soprattutto impressioni iniziali:
«mistral ha appena aggiunto la ricerca agentica alla sua API: è la direzione giusta. Integrare una ricerca in stile Perplexity in uno strumento nativo per agenti ci evita di scrivere pipeline fragili di web scraping e di gestire direttamente la rotazione dei proxy.» — @AbdoKerdawy, sviluppatore di prodotti AI (X)
Le dichiarazioni sui token hanno già ricevuto alcune obiezioni a cui l’annuncio di Mistral non risponde completamente:
«Lo strumento di recupero agentico di Mistral sostiene di ridurre di oltre il 40% gli errori della ricerca a passaggio singolo. Se evita le interrogazioni al database, ridurrà anche il numero di token da spendere?» — @therawlogs, blogger indipendente (X)
La risposta ufficiale è una riduzione dei token del 24-34% rispetto al ciclo search-only. Resta da verificare se il dato regga al di fuori dei corpus usati nei benchmark: una prova indipendente sul set FinanceBench, disponibile pubblicamente, sarebbe il test decisivo.
I prodotti concorrenti devono fare i conti con la stessa realtà: la modalità di ricerca agentica Toast-1 di Mixedbread limita il ciclo a quattro round e otto chiamate di recupero parallele, e la documentazione ammette chiaramente che è più lenta di una singola ricerca. In questa categoria, la latenza è il prezzo che i fornitori pagano per ottenere maggiore accuratezza.
Risposte rapide
Mistral Agentic Search è disponibile tramite l’Agents API?
No. Arriva tramite Mistral Search Toolkit e le Libraries di Studio e Vibe; lo strumento web_search dell’Agents API è un prodotto separato per la ricerca web in tempo reale, con prezzi distinti.
Agentic Search riduce davvero il consumo di token?
Secondo i benchmark ufficiali, su FinanceBench il ciclo completo di navigazione usa il 23,9-33,7% di token in meno rispetto a un ciclo agentico limitato alla ricerca; non è ancora stata pubblicata alcuna replica indipendente.
Quali modelli funzionano con Agentic Search?
Mistral ha testato Mistral Medium 3.5 e Z.ai GLM-5.2, ottenendo miglioramenti coerenti, e descrive il livello come indipendente dal modello, senza necessità di fine-tuning.
Quanto costa Mistral Agentic Search?
Per Agentic Search non è stato pubblicato alcun prezzo. La cifra di 30 dollari ogni 1.000 chiamate indicata nella pagina dei prezzi di Mistral riguarda il precedente strumento agentico web_search.
Il compromesso ancora da risolvere è semplice: qui l’accuratezza si compra in minuti. Per l’elaborazione batch di documenti finanziari, contratti e archivi governativi scansionati, un aumento di accuratezza di +45-59 punti (risultati del ciclo completo rispettivamente su OfficeQA Pro e FinanceBench) insieme a una riduzione di un terzo dei token può essere uno scambio ragionevole, anche con un ciclo più lento. Per qualsiasi esperienza rivolta direttamente agli utenti, però, 71 secondi di latenza media restano un ostacolo decisivo. E finché qualcuno al di fuori di Mistral non ripeterà FinanceBench, i numeri più forti dell’annuncio resteranno comunque quelli dichiarati dal fornitore.
Per approfondire: la guida all’API di GLM-5.2 e la recensione di GLM-5.2 analizzano il secondo modello usato nei test di Mistral.