 AIREITER
Quando un prompt di Janitor AI «smette di funzionare», spesso non è stato sovrascritto: è semplicemente finito sepolto. Le descrizioni pubblicate dell’ordine di invio della piattaforma collocano la cronologia della chat dopo il blocco del prompt. Ogni nuovo messaggio, quindi, spinge le tue regole più lontano dalla fine dell’input del modello. I blocchi brevi e mirati resistono; i master prompt da 800 parole no.
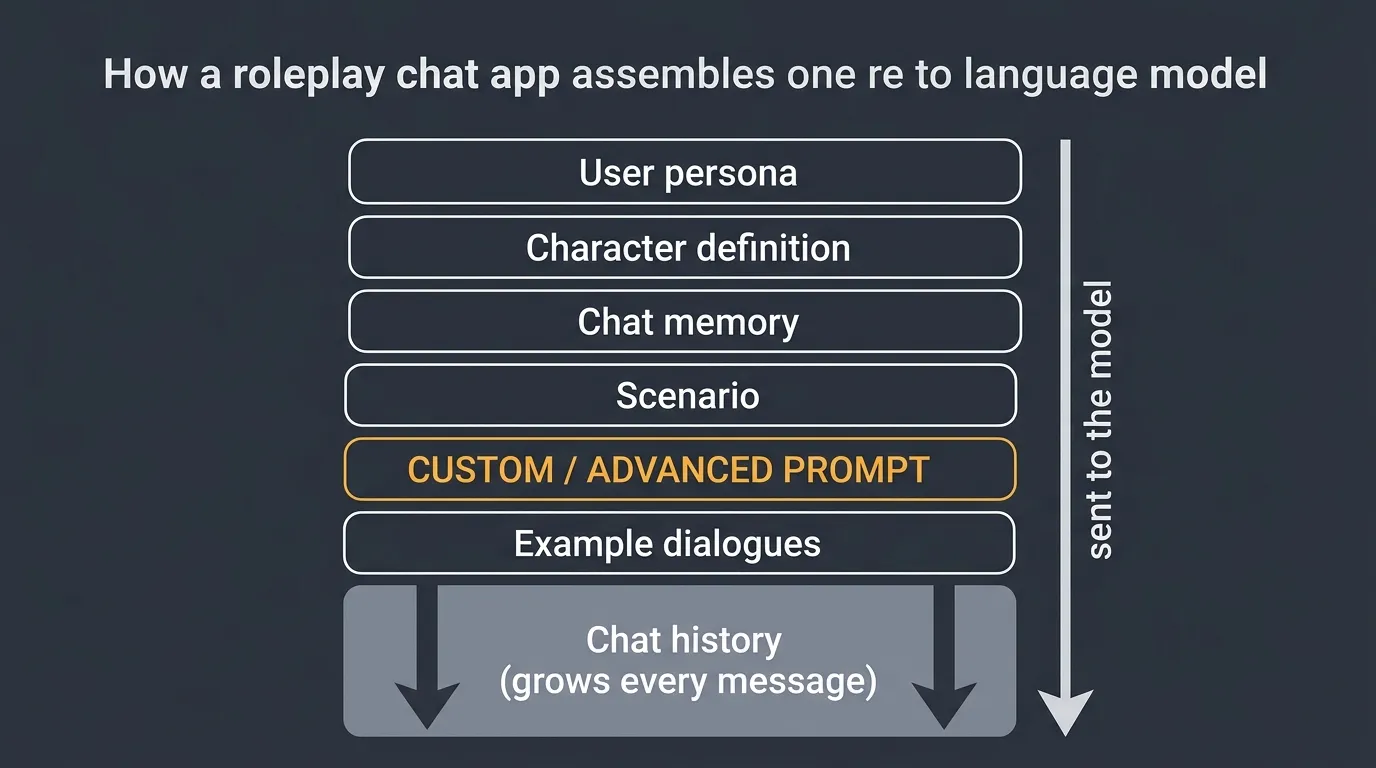
Prima di incollare qualsiasi cosa, abbina il sintomo al campo giusto
Tutte le fonti qui sotto descrivono gli stessi campi principali, inviati al modello come blocchi separati: definizione del personaggio, persona dell’utente, Chat Memory e campo del prompt. Scegliere quello sbagliato è uno dei motivi più comuni per cui un prompt copiato non produce alcun effetto. Trova la riga che descrive ciò che stai vedendo e modifica una sola cosa.
| Cosa succede | Causa più probabile | Correzione minima |
|---|---|---|
| Il bot scrive le battute del tuo personaggio | Il primo messaggio o gli esempi di dialogo parlano già al posto tuo | Correggi il testo all’origine, poi aggiungi il blocco sull’autonomia qui sotto |
| Le regole funzionano per 20 turni, poi svaniscono | Il prompt è finito sepolto sotto la cronologia accumulata | Ripeti la regola fondamentale in Chat Memory |
| Le risposte diventano saggi interminabili | Non c’è alcuna regola sulla lunghezza, oppure quella nella scheda contraddice il prompt | Una sola regola sul numero di paragrafi, dichiarata una volta |
| Il bot ripete il tuo messaggio | I turni recenti hanno modellato questo schema | Elimina o modifica le risposte incriminate, poi aggiungi la riga che vieta di ripetere il testo |
| Il prompt sembra completamente ignorato | Il contenuto permanente ha superato il budget di contesto ed è stato tagliato | Accorcia il prompt, non la storia |
| Lo stesso prompt si comporta diversamente dopo il cambio di modello | Il prompt era dimensionato per il contesto di un proxy, ma ora gira su JLLM | Ridimensionalo in base alla tabella più avanti |
Due abitudini valgono più di qualsiasi template: cambia una sola variabile per test e conserva la versione precedente, così puoi tornare indietro.
Dove finisce il prompt e cosa resta al turno 80
Janitor AI assembla una richiesta diversa a ogni turno usando blocchi separati, e il campo che modifichi non è l’ultima cosa letta dal modello. Le descrizioni pubbliche dell’ordine cambiano nei dettagli, ma il punto su cui concordano è quello che conta davvero.
| Fonte | Posizione del campo del prompt | Cosa viene dopo |
|---|---|---|
| Guida della community ai chatbot (personalità, chat memory, scenario, prompt avanzato, messaggi recenti) | 4° blocco su 5 | I messaggi recenti |
| rshtola/jai-info, osservato sul percorso proxy nell’aprile 2026 | 2°, subito dopo il prompt globale | Persona del personaggio, scenario, persona dell’utente, dialoghi di esempio, riepilogo, lorebook |
| Guide alla risoluzione dei problemi del percorso JLLM | 5° blocco su 6 | L’intera conversazione |
Tutti e tre aggiungono la conversazione dopo il blocco assemblato. Questo singolo fatto spiega un problema segnalato in molte discussioni della community: la regola viene ancora inviata, ma deve competere con diverse migliaia di token di testo più recente. Spiega anche un comportamento che molti notano senza riuscire a motivare: una riga OOC inserita nel messaggio continua a guidare la risposta anche quando il prompt permanente sembra ormai ignorato. La riga OOC arriva alla fine.
Il documento di jai-info aggiunge un dettaglio utile se usi un proxy. I campi vuoti vengono eliminati invece di essere inviati come sezioni vuote, e il prompt personalizzato è uno dei pochi blocchi che Janitor non racchiude in tag come <Scenario> o <UserPersona>. Il tuo testo resta senza etichetta: se vuoi che il modello lo interpreti come un insieme di regole, dagli una riga d’intestazione.
La conseguenza pratica è semplice: ciò che deve restare valido al turno 80 non può stare soltanto nel campo del prompt. Usa Chat Memory per un breve riepilogo che aggiorni quando cambiano i fatti e lascia al campo del prompt le regole generali sul comportamento delle risposte. Verifica il risultato al turno 80, invece di dare per scontato che la separazione funzioni sempre.
Cinque blocchi di prompt, un problema alla volta
I primi quattro vanno nel campo Advanced Prompt o Custom Prompt; il quinto va in Chat Memory. Incollane uno, esegui sei turni e tienilo solo se riesci a descrivere la differenza. Attivarli tutti insieme è il modo più rapido per ritrovarti con un prompt impossibile da analizzare.
Impedisci al bot di parlare al posto del tuo personaggio
È una lamentela ricorrente su r/JanitorAI_Official e il caso in cui la formulazione conta di più. Specifica cosa il bot deve scrivere, invece di limitarti a elencare ciò che non deve fare.
Scrivi solo {{char}}, il mondo e i personaggi secondari.
I dialoghi, le azioni, i pensieri e le decisioni di {{user}} appartengono esclusivamente a {{user}}.
Quando {{char}} avrebbe bisogno della risposta di {{user}}, interrompi la risposta sull'azione o sulla domanda che invita {{user}} a reagire.
Considera l'ultimo messaggio di {{user}} come la verità corrente della scena.
Una discussione della community sulla risoluzione del problema, citata spesso, abbina questo blocco a una definizione esplicita delle macro nella persona: scrivi {{user}} = Name e specifica che {{user}} non è {{char}}. Le aspettative devono restare realistiche. In una lunga discussione sui bot che prendono il controllo del personaggio dell’utente, un commentatore ha valutato la correzione standard così:
«Funziona all’80%» — u/NextCompetition6019, r/JanitorAI_Official
Limita la lunghezza delle risposte senza sacrificare la descrizione
Imposta come predefinito 2–3 paragrafi. Espandi solo quando {{user}} chiede più dettagli.
Dai priorità a ciò che {{char}} fa e dice nel momento presente.
Apri ogni risposta con materiale nuovo, senza ripetere il messaggio di {{user}}.
La parte sulla ripetizione conta più del numero di paragrafi: quando il bot riecheggia il tuo input, metà della risposta se ne va prima che la storia possa avanzare.
Blocca punto di vista e tempo verbale
Narra {{char}} in terza persona ravvicinata e al presente.
Racchiudi i dialoghi tra virgolette e lascia le azioni in prosa normale.
Mantieni il registro della scrittura di {{user}} invece di renderlo più enfatico.
La riga sul registro è quella che molti saltano. Aiuta a contenere la deriva verso la prosa ampollosa e, nei percorsi che tendono a imitare il tuo modo di scrivere, offre al modello qualcosa di concreto da riprodurre.
Fai avanzare la scena
Fai avanzare un passaggio significativo per ogni risposta.
Lascia che {{char}} agisca secondo le proprie motivazioni invece di aspettare istruzioni.
Lascia almeno un filo narrativo irrisolto alla fine di ogni risposta.
Usa questo blocco solo con i bot passivi. In combinazione con il limite di lunghezza può produrre scene affrettate, quindi prova i due blocchi insieme prima di conservarli entrambi.
Un blocco di riepilogo per Chat Memory
Questo blocco non va inserito affatto nel campo del prompt.
Luogo: [dove si svolge la scena]
Obiettivo: [cosa vuole {{char}} in questo momento]
Fatto: [un elemento confermato sul rapporto]
Filo aperto: [ciò che è ancora irrisolto]
Correzione: [l’ultima cosa corretta da {{user}}]
L’articolo di assistenza Advanced Prompting 101 di Janitor AI viene citato nelle guide della community come fonte del consiglio di usare un breve riepilogo, invece di aggiungere altre istruzioni quando una chat lunga inizia a dimenticare i dettagli. Riscrivere cinque righe occupa meno contesto di un altro paragrafo di regole.
Scrivi regole che il modello possa applicare
Lo stesso articolo di assistenza sconsiglia di costruire le regole attorno a «no», «non», «mai» e «smetti», perché nominare un comportamento significa lasciarlo comunque nell’input: «niente sangue» contiene ancora la parola sangue. L’altra frase citata spesso è ripetizione = rumore. Esprimere la stessa regola in cinque modi diversi aggiunge token, non precisione.
La soluzione è una clausola di instradamento. Riscrivi ogni regola negativa indicando l’azione sostitutiva.
| Invece di | Scrivi |
|---|---|
| «Non parlare mai al posto di {{user}}» | «Scrivi solo i dialoghi, i pensieri e le azioni di {{char}}» |
| «Non chiedermi cosa voglio fare dopo» | «Quando {{char}} chiederebbe indicazioni, fai compiere a {{char}} una sola azione autonoma» |
| «Non essere ripetitivo» | «Apri ogni risposta con un evento che non è ancora accaduto» |
| «Evita le risposte brevi» | «Dai a ogni risposta due paragrafi: uno per l’azione e uno per una battuta di dialogo» |
«Evita» e «astieniti da» non sono scappatoie: anche queste formule portano nel prompt il comportamento indesiderato. Inoltre, se la scheda del personaggio o gli esempi di dialogo mostrano proprio ciò che stai cercando di vietare, di solito è la scheda ad avere la meglio. Correggi la fonte prima di aggiungere un’altra regola.
Dimensiona il prompt in base al modello che stai usando
Un prompt scritto per un contesto proxy da 32k token e incollato in una sessione JLLM gratuita è la causa silenziosa di molti messaggi del tipo «questo preset è rotto». Advanced Prompting 101 viene citato per la cifra che qui interessa: su JLLM il contesto operativo è di circa 8.000–9.000 token, condivisi tra persona, definizione del personaggio, memoria, scenario, prompt e intera conversazione.
| Configurazione | Contesto operativo (come riportato nelle guide alle configurazioni proxy) | Dimensione sensata del prompt |
|---|---|---|
| JLLM (integrato, gratuito) | ~8k–9k token | 3–5 regole brevi; i preset lunghi comprimono la storia |
| DeepSeek tramite proxy | configurato comunemente a 16k–32k | Regole più 2–3 scambi di esempio |
| GLM tramite proxy | simile a DeepSeek | Lo stesso; riprova le regole di formattazione dopo il cambio |
Una regola pratica utile per fare i conti: circa 1.000 token corrispondono a 750 parole. Le stesse guide alla risoluzione dei problemi che collocano il prompt al quinto posto su sei fissano a 2.000 token il limite per tutto il contenuto permanente, cioè persona, scheda, memoria e prompt combinati. La guida della community ai chatbot abbassa ancora l’asticella e avverte che un prompt avanzato oltre poche centinaia di token inizia a sottrarre spazio alla definizione del personaggio che dovrebbe soltanto perfezionare.
JLLM e un modello esterno possono spingere lo stesso bot in direzioni diverse, quindi considera il cambio di percorso prima di tutto come una decisione di configurazione proxy e riprovare il prompt, invece di dare per scontato che venga trasferito senza modifiche.
Comandi tra parentesi come <JAILBREAK=ON> o <AUTOPLOT=ON> circolano anche come se fossero impostazioni di Janitor AI. Le liste che li pubblicano li descrivono come comandi utilizzabili con determinati proxy, insieme a funzioni esclusive dei proxy come i codici lorebook e il cambio del modello per singola richiesta; la documentazione ufficiale di Janitor AI, invece, non li definisce. Su un percorso privo del relativo parser non verranno interpretati, quindi occuperanno spazio nel prompt come semplice testo.
Vale davvero la pena tenere un prompt personalizzato?
Qui esiste una spaccatura reale, che non coincide con quella tra principianti ed esperti. Nel 2023 un head moderator di Janitor AI ha scritto che i prompt personalizzati «possono influenzare molto il comportamento dei bot» e che lasciarli senza prompt «potrebbe migliorare» le prestazioni, per poi ricondurre tutto alla prova sul campo. Le discussioni che sostengono, in una forma o nell’altra, di eliminare l’AP tornano periodicamente, e le risposte si dividono: alcune persone riferiscono un output JLLM più pulito dopo aver svuotato il campo, altre notano un netto miglioramento dopo aver sostituito il prompt con un blocco più lungo.
Entrambi i risultati sono compatibili con l’ordine di invio. Un prompt può dare struttura a una scheda vaga, ma può anche duplicare una buona scheda e competere con esempi, memoria e conversazione recente.
La domanda, quindi, non è «il mio prompt è buono?», ma «questo bot ne ha davvero bisogno?». Esegui gli stessi sei turni iniziali due volte, una con il campo vuoto e una con un singolo blocco, poi valuta ogni prova su quattro aspetti:
- Ha scritto dialoghi o azioni per il tuo personaggio?
- La voce è rimasta coerente in tutte e sei le risposte?
- La scena è avanzata oppure si è bloccata e ha iniziato a ripetersi?
- Ha accettato una correzione a metà scena?
Concedi al blocco due tornate di test prima di trarre conclusioni. Se anche la seconda non mostra differenze, il problema non è la formulazione. È la scheda, il primo messaggio o il percorso del modello; aggiungere un altro paragrafo di regole sottrae soltanto contesto alla storia.
FAQ sui prompt di Janitor AI
Dove incollo un prompt di Janitor AI?
Apri le impostazioni API o di generazione della chat e cerca il campo Advanced Prompt nel percorso JLLM, oppure il campo Custom Prompt quando sei collegato tramite un proxy.
Qual è la differenza tra advanced prompt e custom prompt?
Nell’uso della community, Advanced Prompt indica il campo di JanitorLLM, mentre Custom Prompt è l’equivalente per API esterne e proxy. Entrambi gestiscono il comportamento generale delle risposte, ma finiscono in posizioni diverse nella richiesta assemblata: riprova il blocco dopo aver cambiato percorso.
Perché il mio prompt di Janitor AI ha smesso di funzionare dopo un po’?
La cronologia della chat viene aggiunta dopo il blocco del prompt, quindi a ogni messaggio le tue regole si allontanano sempre più dalla fine dell’input. Accorcia il prompt, sposta in Chat Memory la regola a cui non puoi rinunciare e usa una riga OOC nel messaggio per le correzioni che valgono una sola risposta.
{{char}} e {{user}} funzionano dentro un custom prompt?
Sì, sono le macro standard per il personaggio e la tua persona, e il template osservato nel percorso proxy sostituisce gli stessi placeholder. I creatori dei bot specificano comunque {{user}} = Name nella persona, così da eliminare una variabile dai test.
Quanto deve essere lungo un prompt di Janitor AI?
Da tre a cinque regole su JLLM, qualcosa in più su un contesto proxy da 16k–32k, e meno di 2.000 token per tutto il contenuto permanente combinato. Cinque regole che arrivano integre battono venticinque regole troncate.
Il compromesso alla base di tutto questo resta irrisolto. Un prompt abbastanza breve da conservare la propria influenza al turno 80 è troppo corto per specificare tutto ciò che vorresti, e non ho trovato confronti pubblici controllati tra JLLM e i comuni modelli proxy che permettano di stabilire dove si trovi quella soglia. Finché non ne esisterà uno, la scelta predefinita più difendibile resta un blocco piccolo, una copia salvata della versione che ha funzionato e la disponibilità a svuotare il campo quando un bot ben costruito non ne ha bisogno.
Articoli correlati
- Template per la persona di Janitor AI approfondisce il lato
{{user}}dello stesso stack di contesto - I migliori modelli AI per il roleplay spiega come scegliere il modello che il tuo prompt dovrà riuscire a gestire