 AIREITER
Il repository originale facebookresearch/demucs è in sola lettura dal 1° gennaio 2025. La separazione degli stem con Demucs resta una delle migliori opzioni gratuite da eseguire sul proprio computer, a patto di installarla dal fork che ha pubblicato la v4.1.0 e di mettere in conto che chitarra e pianoforte sono gli strumenti con cui il modello va più facilmente in difficoltà.
Parti dal repository mantenuto di Demucs, non da quello archiviato
Su GitHub ci sono due repository con lo stesso README, ma soltanto uno continua a ricevere correzioni. facebookresearch/demucs è archiviato e in sola lettura, e il suo stesso README rimanda altrove. Il progetto mantenuto si trova invece su adefossez/demucs, dove l’autore Alexandre Défossez spiega che questo è "the officially maintained Demucs now that I have left Meta to join Kyutai", avvertendo però di "expect slow replies and no new feature for now."
La differenza non riguarda soltanto l’URL: cambiano anche i comandi d’installazione.
Cosa cambia con la v4.1.0
La voce delle note di rilascio datata 11/07/2026 presenta Demucs v4.1.0 con "modernized packaging, lighter inference dependencies, numerous fixes, and pretrained models hosted on Hugging Face." In pratica:
| Elemento | Repository archiviato | Repository mantenuto (v4.1.0) |
|---|---|---|
| Versione minima di Python | 3.8 | 3.10 |
| Avvio più rapido | pip install -U demucs | uvx demucs MY_TRACK.mp3 (nessuna installazione) |
| Installazione permanente | pip install -U demucs | uv tool install demucs (pip continua a funzionare) |
| ffmpeg | Obbligatorio | Facoltativo; serve per l’output FLAC e per i formati che sphn non riesce a decodificare |
| Modelli quantizzati | Inclusi | Richiedono l’extra: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Hosting dei pesi | dl.fbaipublicfiles.com | Hugging Face |
C’è anche una trappola da conoscere prima di aprire una segnalazione: PyTorch ha abbandonato il supporto ai Mac Intel dopo la versione 2.2. Gli utenti con Mac Intel sono quindi limitati a Python 3.12 e devono usare uvx --python 3.12 demucs.
Come scegliere il modello: htdemucs, htdemucs_ft, htdemucs_6s, mdx
Il flag -n seleziona il modello, e quello predefinito non è sempre la scelta migliore. Demucs include modelli a quattro sorgenti — batteria, basso, altri strumenti e voce — un esperimento a sei sorgenti e i modelli MDX più vecchi nati per le challenge.
| Modello | Sorgenti | Velocità | Avvertenza ufficiale | Quando sceglierlo |
|---|---|---|---|---|
htdemucs | 4 | Riferimento (predefinito) | Nessuna indicata | Prima elaborazione, lavori in batch e tutti i casi in cui conta la velocità |
htdemucs_ft | 4 | ~4× più lento | "might be a bit better" | Render finali di un brano importante |
htdemucs_6s | 6 | Intermedia tra i due | Chitarra "okay"; pianoforte "not working great", con "a lot of bleeding and artifacts" | Se ti serve proprio uno stem di chitarra e puoi accettare qualche difetto |
hdemucs_mmi | 4 | Riferimento | Architettura v3, riaddestrata | Per un confronto A/B quando la v4 suona male su un mix specifico |
mdx / mdx_extra | 4 | Riferimento | mdx_extra è stato addestrato su dati including the MUSDB test set | Materiale più vecchio o casi in cui gli artefatti della v4 risultano fastidiosi |
mdx_q / mdx_extra_q | 4 | I più veloci e compatti | "quality can be slightly worse" | Computer con poco spazio o anteprime rapide |
Vale la pena soffermarsi sulla cautela usata per htdemucs_ft: richiede quattro volte il calcolo per un miglioramento che lo stesso autore definisce soltanto possibile. Su CPU il prezzo in termini di tempo è pesante, e gli utenti lo confermano senza mezzi termini.
Cosa misurano davvero i valori SDR di 9.00 e 9.20 dB
I due numeri compaiono nello stesso paragrafo del README, ma non sono intercambiabili. Hybrid Transformer Demucs raggiunge 9.00 dB SDR sul test set MUSDB HQ. Il risultato più alto, pari a 9.20 dB, richiede kernel di attenzione sparsa e fine-tuning per sorgente; inoltre il modello sparse "is not provided as it requires custom CUDA code that is not ready for release yet."
Nessun modello scaricabile, quindi, riproduce i 9.20 dB. Nella tabella comparativa dello stesso README, la versione v4 fine-tuned distribuita si ferma a 9.0 di SDR complessivo, a pari merito con Band-Split RNN addestrato su 1.7k mix.
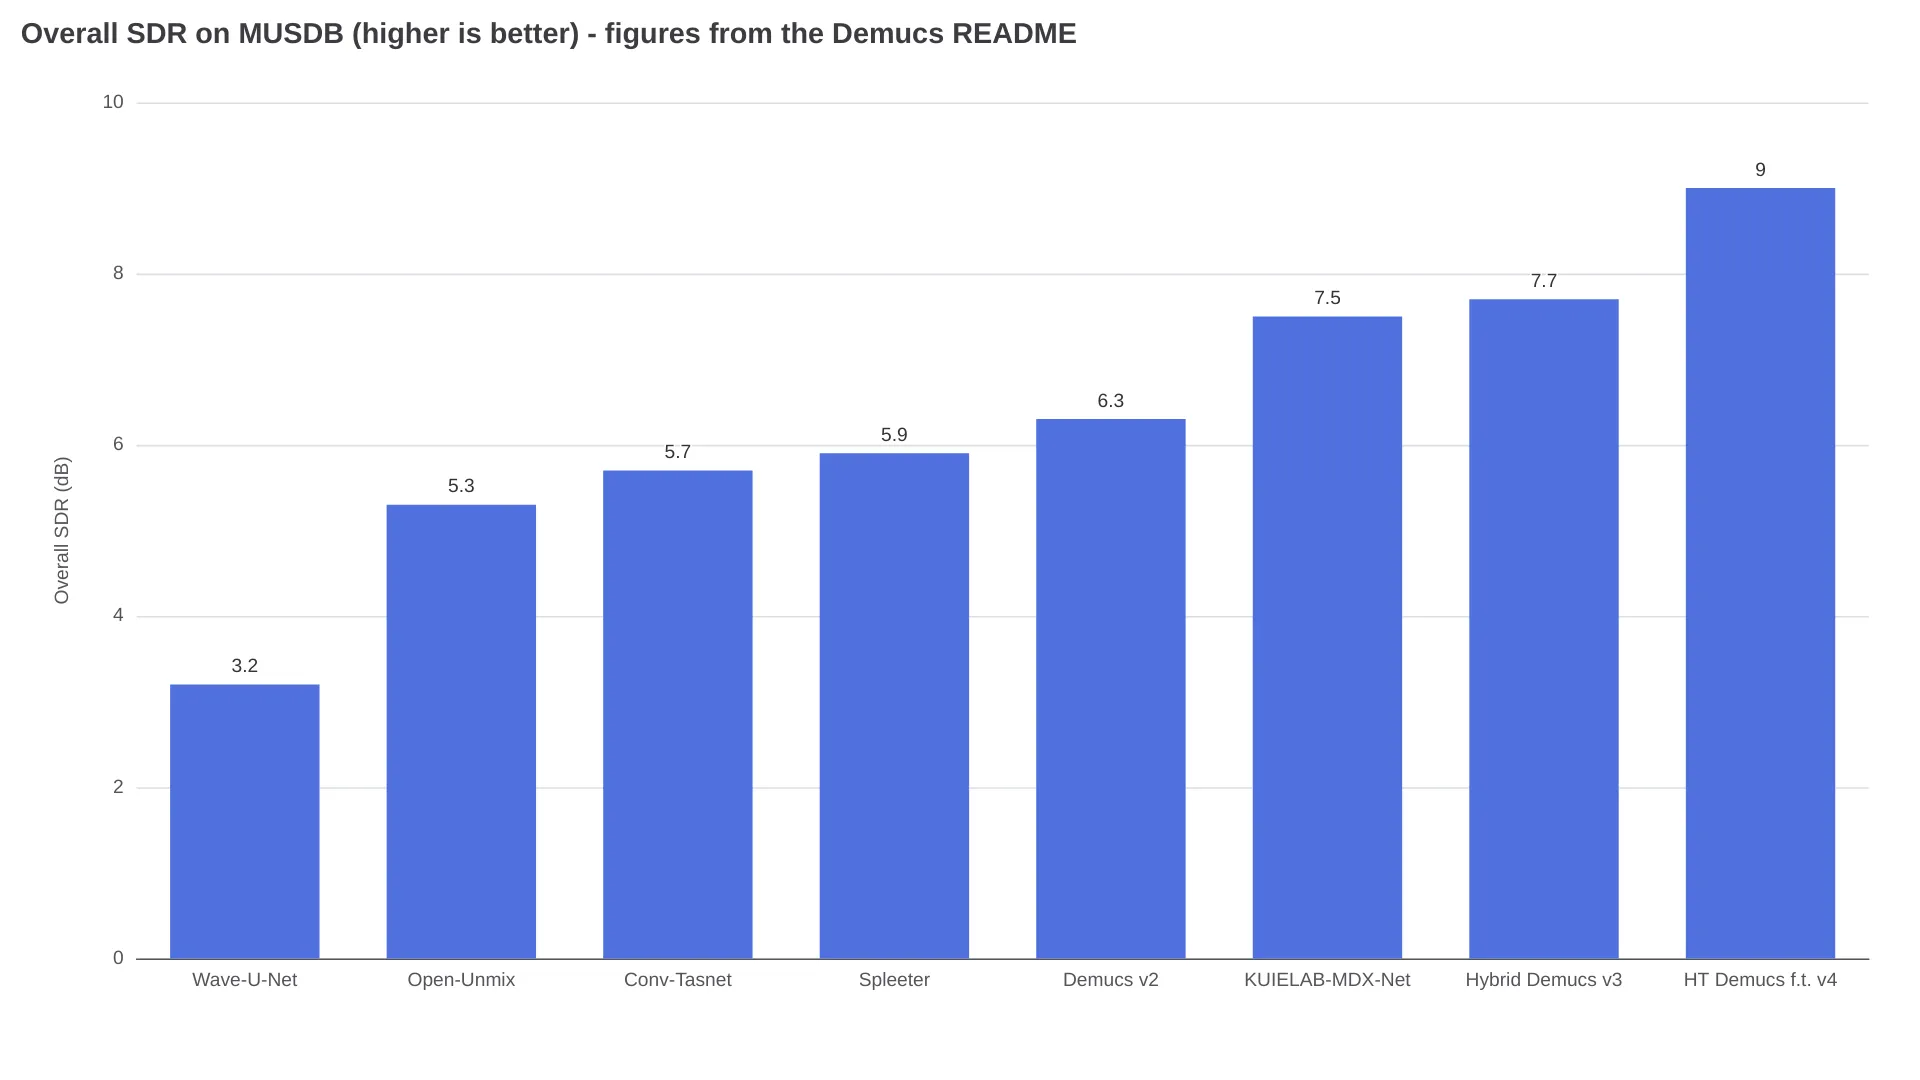
Nella stessa tabella, Spleeter si ferma a 5.9 dB nonostante sia stato addestrato su 25k brani: il divario rispetto alla versione v4 fine-tuned è di circa 3 dB.
I flag che cambiano il risultato
Per la maggior parte delle elaborazioni con Demucs devi decidere tre cose: quanti stem ottenere, quanto calcolo dedicare al lavoro e in quale formato salvare il risultato.
--two-stems=vocalsattiva la modalità karaoke e producevocals.waveno_vocals.wav. Demucs separa prima l’intero mix e poi ricompone il risultato, quindi questa modalità non è né più veloce né meno esigente in termini di memoria rispetto a un’elaborazione normale.--shifts=Ncalcola la media di N previsioni ottenute da input spostati casualmente. Rende l’elaborazione N volte più lenta; il README consiglia di "don't use it unless you have a GPU." Il paper usa 10 shift, mentre il valore predefinito del servizio ospitato di Replicate è 1.--overlapè impostato su 0.25, ma può essere ridotto a 0.1 per ottenere un piccolo guadagno di velocità.--segment Nè il comando da usare quando compare un errore di memoria, ma qui si nasconde un dettaglio che rompe molti comandi copiati online: i modelli Hybrid Transformer supportano una durata massima del segmento di 7.8 secondi. Un valore elevato di--segmentha effetto soltanto sui modelli non HT.- Flag per l’output sono
--mp3(320 kbps predefiniti),--flac(richiede ffmpeg),--int24e--float32. Per impostazione predefinita il risultato è un WAV int16 a 44.1 kHz, salvato inseparated/MODEL_NAME/TRACK_NAME. --clip-modeè più importante di quanto sembri: per impostazione predefinita Demucs ridimensiona gli stem per evitare il clipping, ma così può alterare i volumi relativi tra le tracce. Conclamp, invece, applica un limite rigido.
Le indicazioni hardware dello stesso documento parlano di almeno 3 GB di RAM video, circa 7 GB con i parametri predefiniti e dell’uso di --segment 8 insieme a PYTORCH_NO_CUDA_MEMORY_CACHING=1 quando si dispone di 3 GB o meno. Su CPU, "processing time should be roughly equal to 1.5 times the duration of the track." È una stima ottimistica se confrontata con le esperienze riportate dagli utenti con htdemucs_ft.
Dove Demucs perde colpi e la correzione a due passaggi
Il bleeding è il problema che ricorre più spesso, soprattutto quando la voce condivide il registro con uno strumento solista. Ryan Herr (@rrherr) lo ha riassunto così dopo un tentativo di estrazione:
demucs let a lot of sax bleed into the 'vocals' track.
La soluzione a cui arrivano gli utenti più esperti non è un flag, ma un secondo modello. Il produttore giapponese 夜凪P (@yonagip, 145 like) descrive un primo passaggio con MelBand Roformer in UVR5 per separare voce e parte strumentale, seguito dall’elaborazione della sola parte strumentale con htdemucs_ft per ottenere batteria, basso e altri strumenti:
Demucs単体だとVoが他に漏れるんだけど (with Demucs alone, the vocals leak into the other stems)
Altri due report degli utenti indicano la stessa direzione: un produttore misura una definizione migliore del basso con htdemucs_ft, ma segnala che su CPU l’elaborazione è quattro volte più lenta (@hachi_vm); un altro pubblica un confronto sull’estrazione della chitarra in cui htdemucs-6s perde nettamente contro un modello BS-RoFormer (@junon_12). Sono testimonianze, non benchmark, ma coincidono con quanto riportato ufficialmente: quando Défossez annunciò il modello a sei sorgenti nel dicembre 2022, scrisse di aver osservato "some bleeding + artifacts."
Regola pratica: se la sorgente contiene un sassofono, una chitarra solista o un pianoforte impegnato in una parte melodica, considera la prima elaborazione di Demucs un punto di partenza, non un risultato pronto all’uso. Le alternative basate su Roformer sono accessibili dall’interfaccia di UVR5 se ti serve un secondo passaggio.
Usare Demucs via API invece di installarlo
Se vuoi ottenere gli stem senza configurare un ambiente Python, una versione ospitata molto usata è cjwbw/demucs su Replicate: circa 1,5 milioni di esecuzioni su hardware Nvidia T4, con una stima della pagina di circa $0.020 per esecuzione (~50 esecuzioni per dollaro) e previsioni che in genere terminano entro 90 secondi.
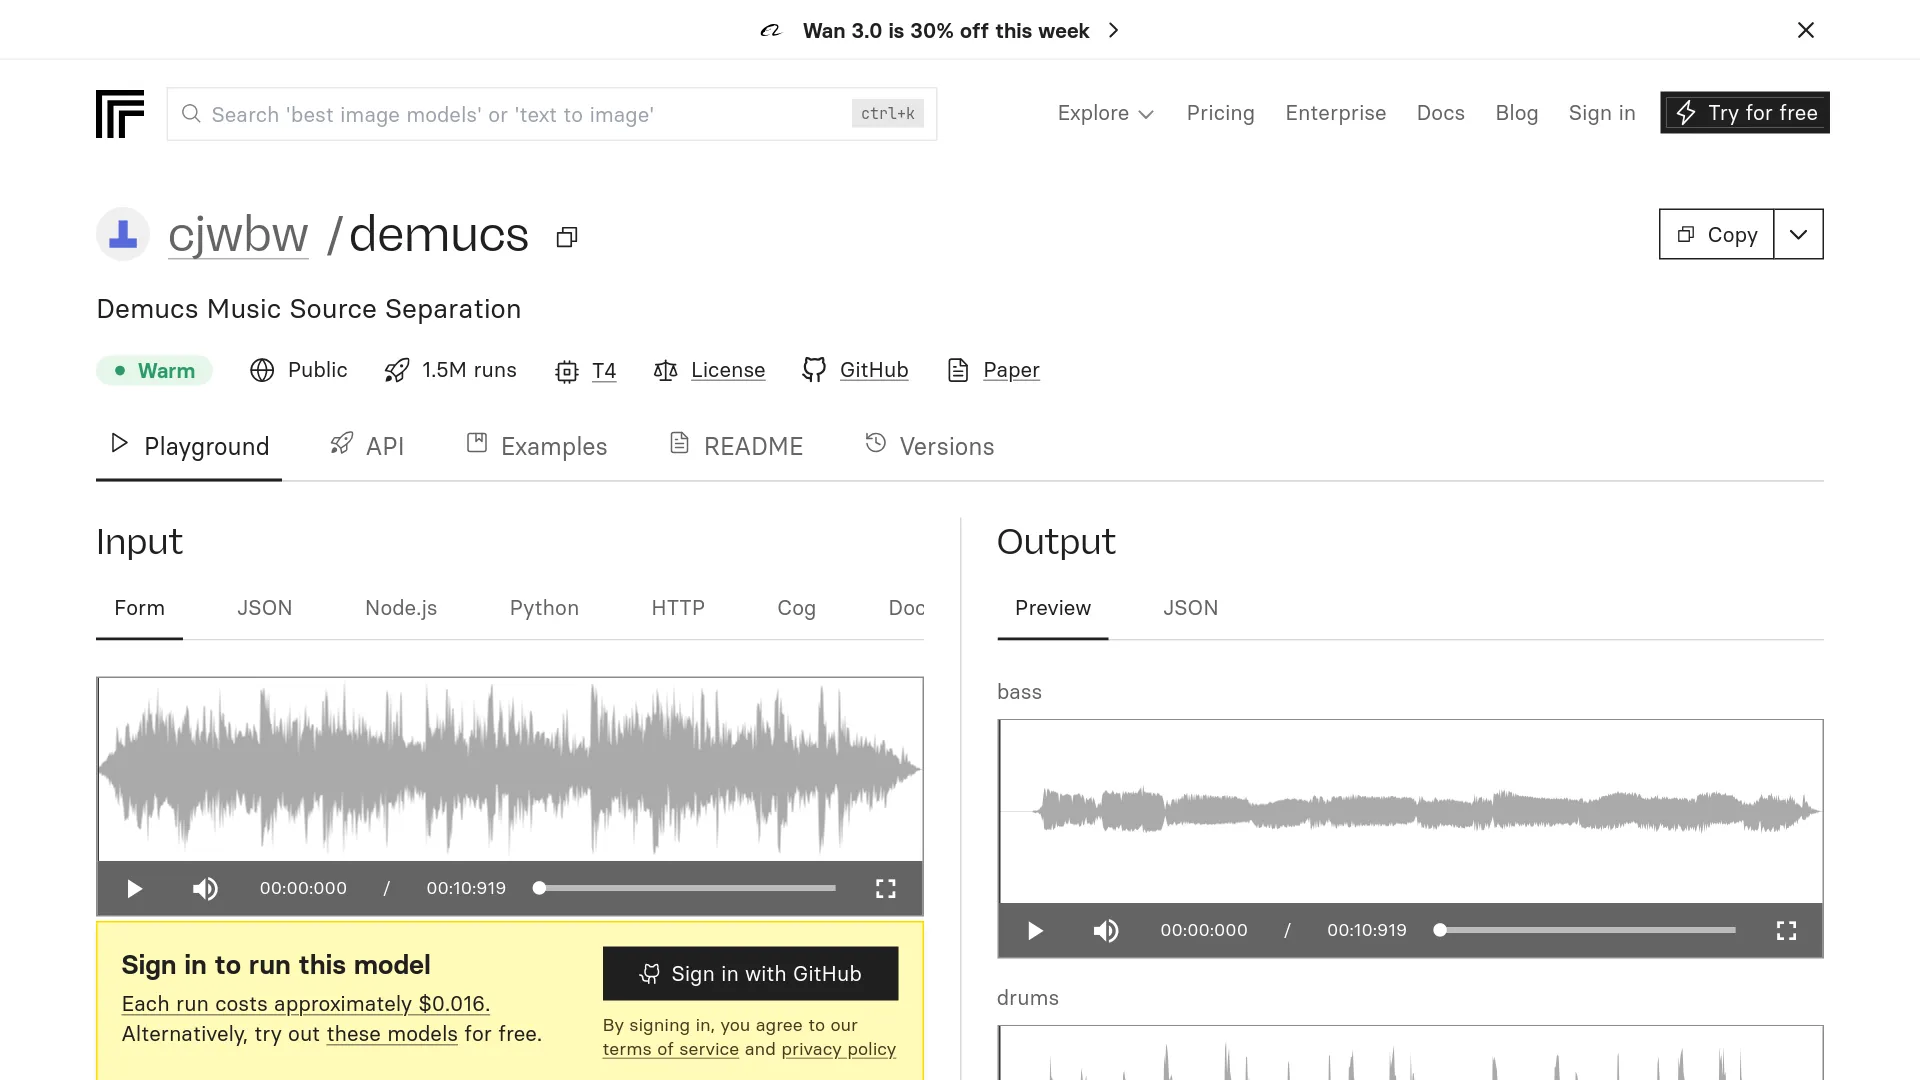
Lo schema degli input ricalca la CLI: model_name (predefinito htdemucs), stem, shifts (predefinito 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32, output_format (mp3).
C’è però un dettaglio che la pagina non evidenzia: la sua versione più recente risale a circa tre anni fa, e un endpoint ospitato blocca una specifica versione del modello. Stai quindi chiamando quella build, non il lavoro su packaging e dipendenze della v4.1.0 pubblicato nel luglio 2026. Anche i tempi reali oscillano più di quanto lasci intendere il dato principale: un esempio pubblico di previsione sullo stesso modello ha richiesto 6 minuti e 18 secondi.
Quanto costa davvero una traccia di 4 minuti
Il dato che determina il flusso di lavoro è il costo per brano, e dipende da un dettaglio della fatturazione che molti scoprono solo dopo essersi abbonati.
LALAL.AI calcola il consumo come durata del file × numero di tipi di separazione selezionati. Separare una canzone di 4 minuti in quattro stem consuma quindi 16 minuti, non 4.
La stessa pagina dei prezzi elenca i pacchetti una tantum (verificati il 25 settembre 2026): $50 per 750 minuti di Fast Queue, $190 per 3.000 e $300 per 5.000. A queste tariffe, separare quattro stem da una canzone di 4 minuti costa tra $0.96 e $1.07.
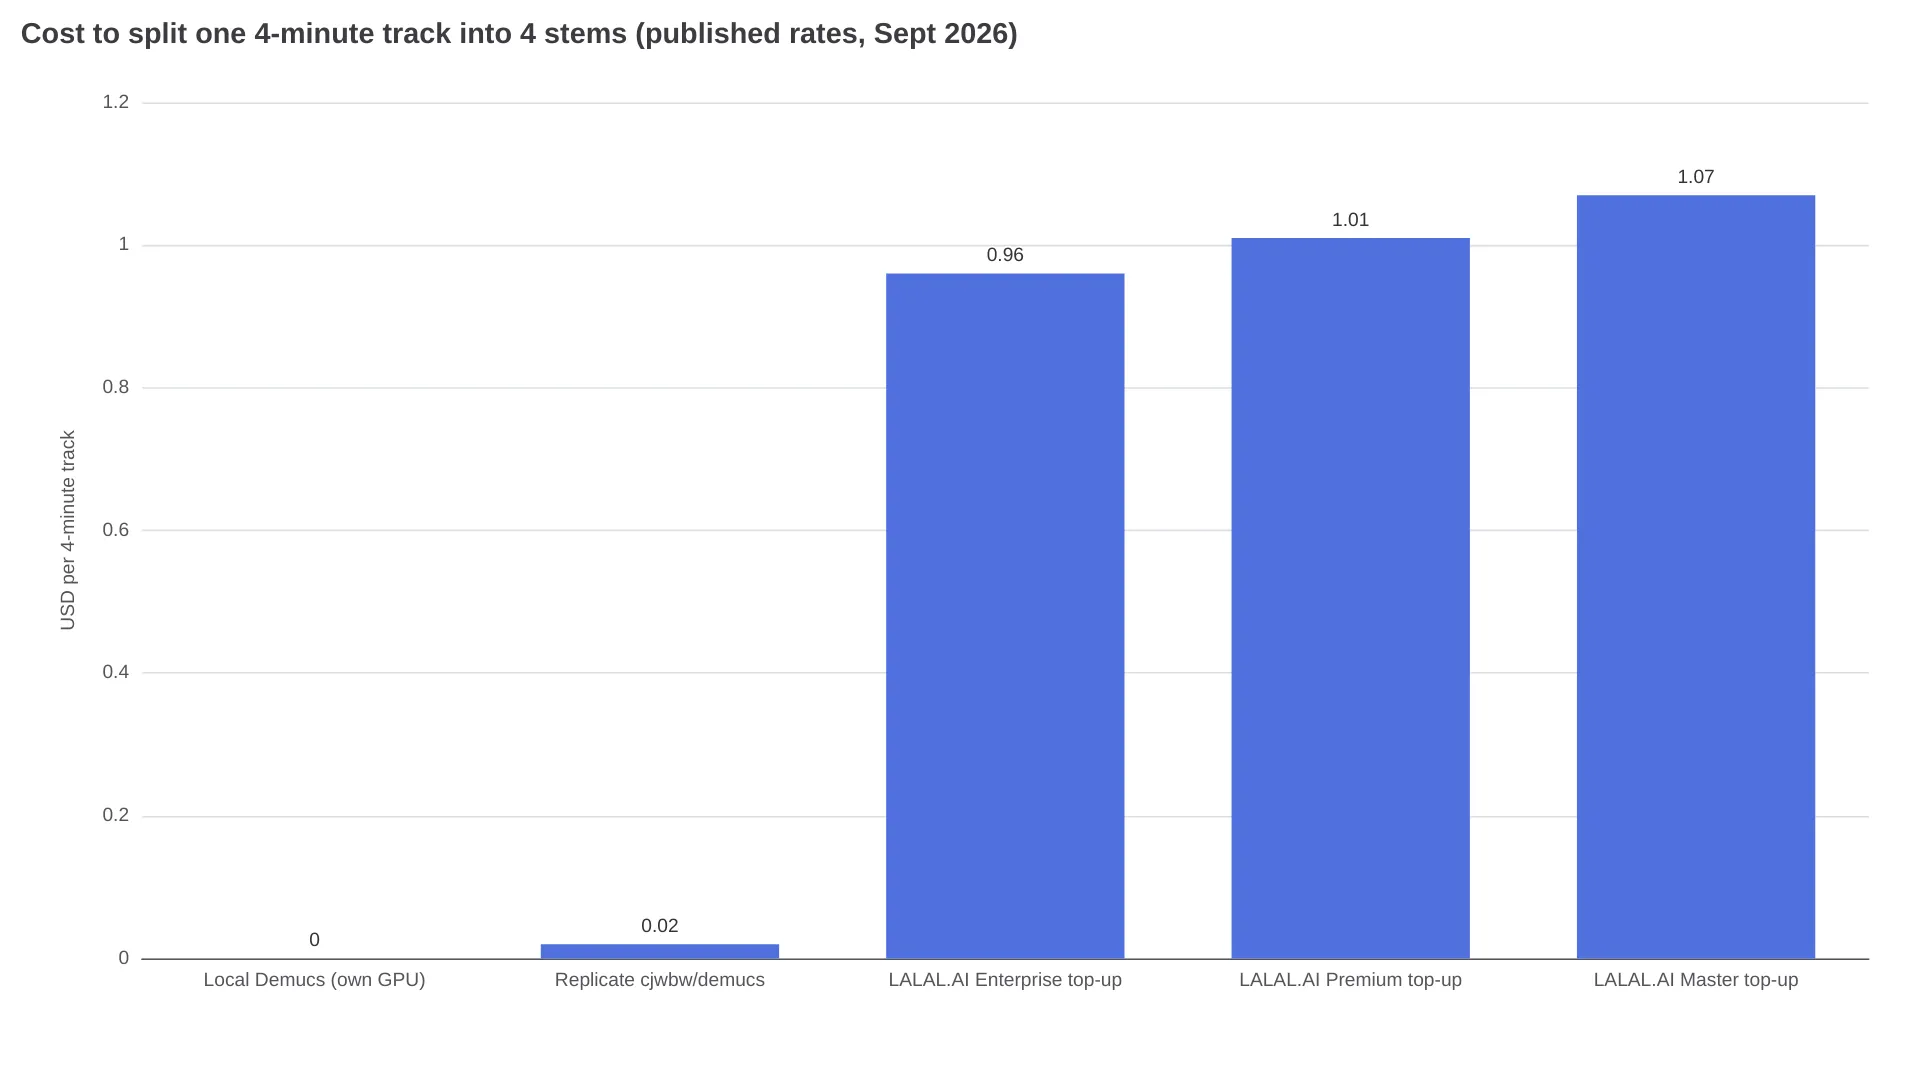
Il grafico va però letto con una precisazione: i valori di LALAL.AI rappresentano il prezzo dell’elaborazione prioritaria. I piani a pagamento includono minuti illimitati nella Relaxed Queue e l’azienda dichiara che entrambe le code "deliver identical separation quality." La Fast Queue serve soltanto ad accorciare l’attesa.
| Piano | Prezzo | Cosa include | Limiti principali |
|---|---|---|---|
| LALAL.AI Starter | Gratis | 10 minuti di Relaxed Queue | Limite di caricamento di 200 MB |
| LALAL.AI Lite | €6.75/mese, €81 con fatturazione annuale | Relaxed illimitata, 90 minuti Fast | Niente batch, VST o API; i minuti non si accumulano |
| LALAL.AI Pro | €13.50/mese, €162 con fatturazione annuale | Relaxed illimitata, 250 minuti Fast | Unico piano con accesso API, plugin VST ed elaborazione batch |
| Moises | Non pubblicato | Piano gratuito con caricamenti mensili limitati | La tabella dei prezzi è visibile dopo il login; dichiara 27 tipi di stem |
Replicate cjwbw/demucs | ~$0.020/esecuzione | T4, di solito in meno di 90 s | Versione bloccata a ~3 anni fa |
| Demucs in locale | Gratis (licenza MIT) | Illimitato, offline | Tempo di calcolo della GPU e configurazione iniziale a tuo carico |
I 90 minuti di Fast Queue del piano Lite coprono circa cinque brani da 4 minuti separati in quattro stem al mese, prima di passare alla coda rilassata. Se elabori più di una manciata di canzoni alla settimana, il calcolo smette rapidamente di favorire la fatturazione al minuto: è esattamente la soglia oltre la quale installare Demucs ripaga il pomeriggio dedicato alla configurazione.
Quale soluzione scegliere in base al lavoro
| Situazione | Soluzione migliore | Perché |
|---|---|---|
| Separazioni occasionali, niente GPU né terminale | LALAL.AI Starter, poi Lite | I 10 minuti gratuiti permettono di testare la qualità prima di spendere |
| Studiare i brani, pratica da mobile | Moises | 27 tipi di stem oltre a strumenti per tempo e accordi; il prezzo va verificato dopo il login |
| Volumi elevati, GPU propria | uvx demucs con htdemucs | Nessun costo marginale, esecuzioni illimitate e i file restano sul computer |
| Un unico render finale importante | htdemucs_ft, --shifts 2 su GPU | Permette di spremere quell’ultima frazione di qualità al costo di 4× calcolo |
| Serve uno stem di chitarra | htdemucs_6s per primo, poi confronto con un modello di classe Roformer in UVR5 | La documentazione ufficiale ammette il bleeding del modello a sei sorgenti |
| Materiale inedito o coperto da NDA | Solo Demucs in locale | Nessun upload, licenza MIT ed elaborazione offline |
| Backend di un’app, nessun budget operativo | Replicate cjwbw/demucs | ~$0.020/esecuzione e nessuna infrastruttura GPU da gestire |
FAQ sulla separazione degli stem con Demucs
Quale modello Demucs offre le voci migliori?
htdemucs_ft è il modello distribuito a quattro sorgenti più efficace sulle voci, con un tempo di elaborazione circa quattro volte superiore a quello di htdemucs. Sui mix più difficili, gli utenti riportano risultati migliori con una catena a due passaggi: prima una separazione della voce con un modello di classe Roformer, poi Demucs per scomporre la parte strumentale.
Demucs riesce a separare chitarra e pianoforte?
Soltanto tramite htdemucs_6s. Nel README ufficiale la qualità della chitarra viene definita "okay" nei test rapidi, mentre la sorgente del pianoforte "not working great", con "a lot of bleeding and artifacts."
Serve una GPU NVIDIA per eseguire Demucs?
No. La CPU funziona con -d cpu e la documentazione stima un tempo di elaborazione pari a circa 1,5 volte la durata del brano. Sui dispositivi Apple Silicon puoi usare -d mps. L’accelerazione GPU richiede almeno 3 GB di VRAM, circa 7 GB con i parametri predefiniti.
Perché gli stem separati non si ricompongono nel mix originale?
Demucs ridimensiona ogni stem per evitare il clipping causato dagli artefatti della separazione, alterando però i volumi relativi tra le tracce. Usa --clip-mode clamp per applicare invece un clipping rigido, oppure abbassa il volume del mix in ingresso prima dell’elaborazione.
Dove salva gli stem Demucs?
In separated/MODEL_NAME/TRACK_NAME/, come file WAV stereo a 44.1 kHz codificati in int16: drums.wav, bass.wav, other.wav e vocals.wav, a meno che tu non richieda un output MP3, FLAC, int24 o float32.
Come posso risolvere un errore CUDA out-of-memory?
Riduci --segment (8 è il valore minimo indicato per le schede da 3 GB), imposta PYTORCH_NO_CUDA_MEMORY_CACHING=1 oppure passa a -d cpu. Ricorda che i modelli Hybrid Transformer limitano la lunghezza del segmento a 7.8 secondi: aumentare il valore oltre questa soglia non produce alcun effetto.