 AIREITER
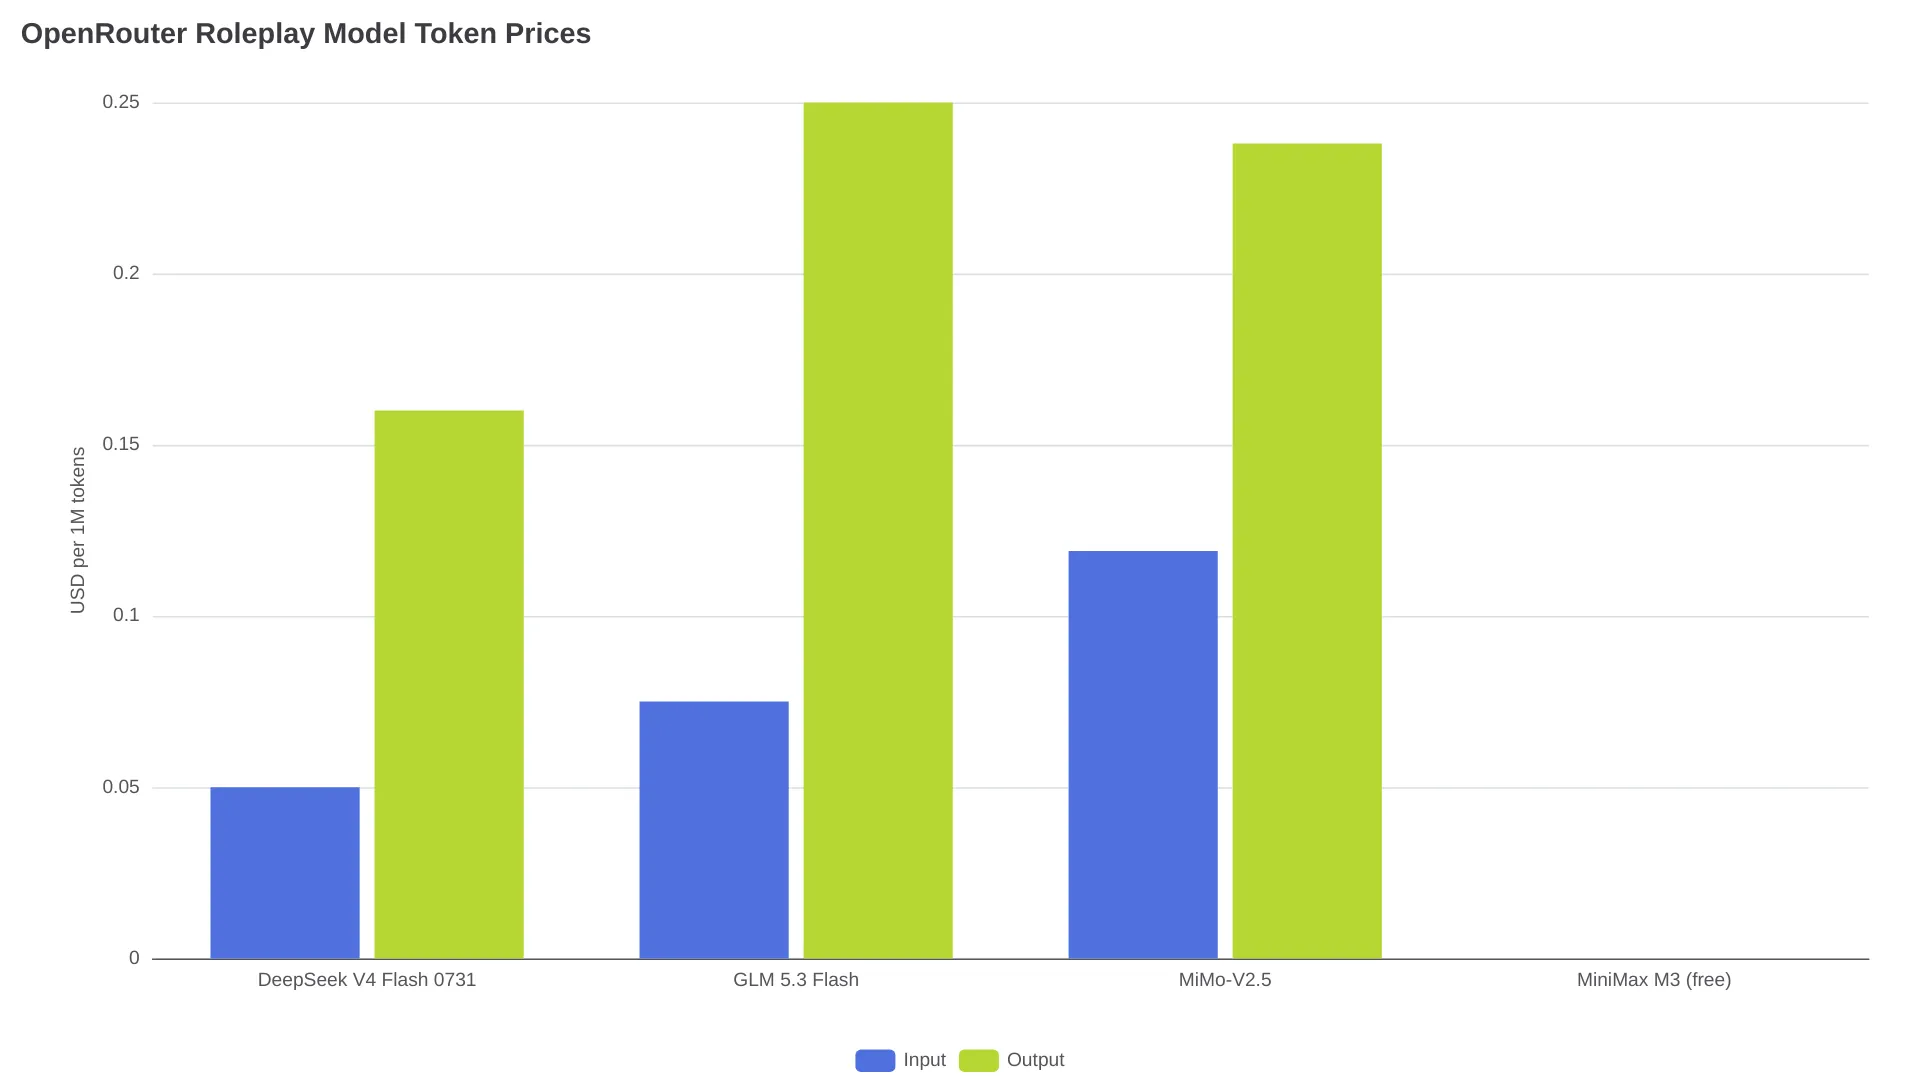
Pour le roleplay sur OpenRouter, le bon modèle dépend surtout de votre priorité : une voix cohérente, un contexte très long ou une session sans dépenser un centime. Dans cet état des lieux du 2 septembre 2026, DeepSeek V4 Flash 0731 est la référence payante à essayer d’abord pour son rapport coût/contexte : OpenRouter lui attribue un contexte de l’ordre de 1M et facture $0.05 en entrée / $0.16 en sortie par million de tokens. Les routes gratuites restent pratiques pour tester, mais leur capacité et leur disponibilité peuvent évoluer.
Ce guide s’intéresse au comportement technique et au coût du roleplay fictif non explicite. Il ne désigne pas un vainqueur universel « uncensored » et ne publie aucun pourcentage de refus sans test contrôlé, réalisé dans des conditions strictement comparables.
Quel modèle OpenRouter choisir pour le roleplay en 2026 ?
Conservez un modèle payant fixe et une solution gratuite de secours active. Le classement d’usage sert à repérer des candidats, pas à mesurer leur qualité.
| Usage | Modèle à vérifier en premier | Pourquoi il convient | Limite principale |
|---|---|---|---|
| Référence payante coût/contexte | DeepSeek V4 Flash 0731 | Contexte de l’ordre de 1M, $0.05/$0.16 par 1M de tokens, et trafic roleplay actuel sur OpenRouter | L’usage ne remplace pas un test RP contrôlé |
| Essai gratuit prioritaire | MiniMax M3 (free) | Présent dans la collection gratuite active d’OpenRouter avec un contexte d’environ 1M | La capacité, les limites et la disponibilité du gratuit peuvent changer |
| Comparaison payante à bas coût | GLM 5.3 Flash | Contexte de l’ordre de 1M, 22 fournisseurs listés et tarif temporaire de $0.075/$0.25 | La promotion est limitée dans le temps ; le modèle est orienté travail agentique |
| Comparaison à tarif intermédiaire | MiMo-V2.5 dans la collection roleplay d’OpenRouter | $0.119/$0.238 par 1M de tokens et contexte de 1.05M dans la fiche active | La page citée fournit des données de catalogue et d’usage, pas un score RP contrôlé |
| Secours gratuit automatique | openrouter/free | Sélectionne une route gratuite disponible sans imposer un slug fixe | Le modèle sous-jacent peut changer d’une requête à l’autre |
Commencez avec DeepSeek comme référence payante, vérifiez que l’endpoint gratuit de MiniMax M3 est toujours disponible avant de vous y fier, puis utilisez GLM 5.3 Flash comme second point de contrôle payant. Cette sélection repose sur les données d’usage, de prix, de contexte et de routage actuelles, et non sur un classement universel de la prose.
Ce que le classement roleplay d’OpenRouter mesure réellement
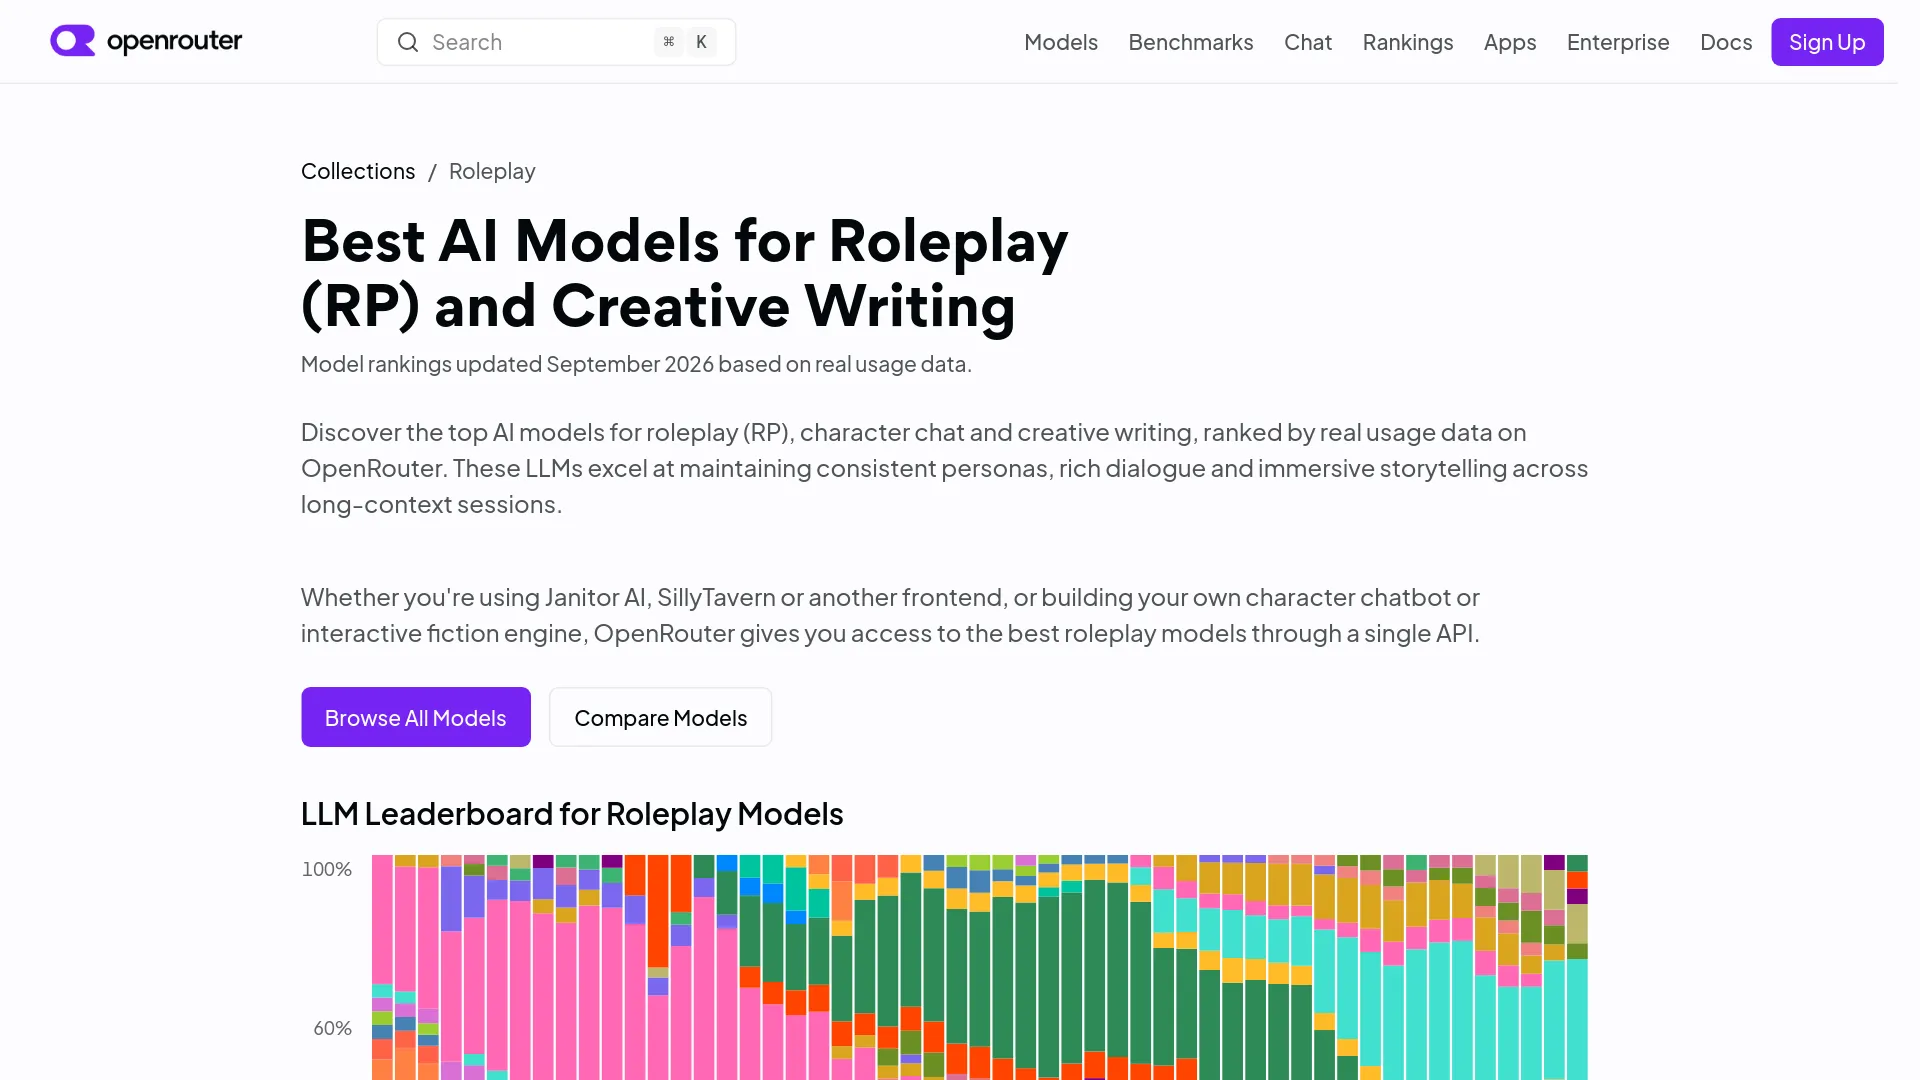
La collection Roleplay and Creative Writing d’OpenRouter est une page de découverte dynamique fondée sur l’usage. Dans sa capture du 2 septembre 2026, DeepSeek V4 Flash y occupe la première place.
Ce classement reflète les volumes d’utilisation, et non le respect d’une character card, la conservation des noms, la qualité d’écriture ou le taux de refus. Un modèle populaire peut surtout être peu cher, rapide, très disponible ou simple à router.
Servez-vous de la collection pour établir une courte liste, puis lancez la même card sûre et la même scène d’ouverture sur deux IDs de modèles fixés. Le test répond alors à une question plus utile : quelle route fonctionne le mieux avec votre prompt, vos réglages et votre budget ?
La sélection actuelle : contexte, tarifs et disponibilité
Les chiffres ci-dessous proviennent des pages roleplay, modèles gratuits et modèles individuels d’OpenRouter consultées le 2 septembre 2026. Les prix et le statut gratuit sont des instantanés opérationnels.
| ID du modèle | Contexte affiché | Prix entrée / sortie par 1M | Route gratuite observée ? | Ce que les données permettent d’établir |
|---|---|---|---|---|
deepseek/deepseek-v4-flash-0731 | 1,310,720 | $0.05 / $0.16 | Vérifier le catalogue actif | Tarif payant affiché bas, 30 fournisseurs et basculement automatique |
minimax/minimax-m3 | 1,048,576 | $0.23 / $0.96 en payant | Oui, listé comme MiniMax M3 (free) | Grand contexte et tests sans coût quand l’endpoint gratuit est disponible |
z-ai/glm-5.3-flash | 1,310,720 | $0.075 / $0.25 promotionnel | Vérifier le catalogue actif | 22 fournisseurs et 99.89% de disponibilité sur trois jours dans l’instantané |
xiaomi/mimo-v2.5 | 1.05M | $0.119 / $0.238 | Non établi par la page citée | Signal d’usage dans la collection roleplay et tarification payante modérée |
openrouter/free | Page du routeur : 200K | $0 | Routeur, pas un modèle fixe | Pratique pour expérimenter ; la sélection aléatoire réduit la reproductibilité |
DeepSeek V4 Flash 0731 : la référence coût/contexte
DeepSeek V4 Flash 0731 propose un contexte de 1,310,720 tokens, jusqu’à 393,216 tokens de complétion, et des tarifs affichés de $0.05 en entrée / $0.16 en sortie par million de tokens. Sa page OpenRouter indique 30 fournisseurs et décrit les modes de routage Balanced, Nitro et Exacto.
Avant de lancer une longue campagne, faites le test avec la même card : la page du modèle ne publie pas de mesure de cohérence de personnage.
MiniMax M3 : le candidat pour essayer gratuitement
La collection de modèles gratuits d’OpenRouter affiche MiniMax M3 à $0 en entrée comme en sortie, avec un contexte affiché de 1.05M. La page payante de MiniMax M3 indique 1,048,576 tokens de contexte, des entrées texte/image/vidéo, des sorties texte, et une tarification payante de $0.23 en entrée / $0.96 en sortie par million de tokens.
La documentation Free Variant d’OpenRouter précise qu’une route :free peut avoir une disponibilité et des limites de débit différentes du modèle payant. Si la reproductibilité est importante, choisissez le slug gratuit exact affiché dans le catalogue actif ; ne recourez à openrouter/free que si la sélection automatique vous convient.
GLM 5.3 Flash : pour diversifier les fournisseurs
GLM 5.3 Flash possède une fenêtre de contexte de 1,310,720 tokens et est affiché à $0.075 en entrée / $0.25 en sortie par million de tokens grâce à une remise promotionnelle de 50% via Z.ai jusqu’au 9 septembre 2026 à 16:00 UTC. La page d’OpenRouter liste 22 fournisseurs et une disponibilité sur trois jours de 99.89%.
La fiche positionne GLM 5.3 Flash pour le code efficace et les tâches agentiques de longue durée, pas spécifiquement pour le roleplay. Testez son adéquation au RP avec le même prompt plutôt que de la déduire de cette présentation produit.
MiMo-V2.5 et les autres solutions de secours
MiMo-V2.5 apparaît dans la collection roleplay d’OpenRouter avec un contexte de 1.05M et des prix de $0.119 en entrée / $0.238 en sortie. C’est un point de contrôle raisonnable à tarif intermédiaire, mais la page citée ne publie aucun résultat de roleplay contrôlé. Enregistrez un second slug exact avant qu’une session ne tombe en erreur : une solution de secours présélectionnée reste plus prévisible qu’un changement aléatoire de modèle.
Test de coût sur 1 000 tours : la gestion du contexte fait la facture
Un tour de roleplay comprend un message utilisateur et une réponse de l’assistant. OpenRouter facture les tokens : il n’existe donc pas de prix universel pour 1 000 tours, car une grande part de la dépense dépend de l’historique renvoyé par le frontend.
Ce modèle de projection suppose 1,000 tours, 200 nouveaux tokens utilisateur par tour, 500 tokens de sortie assistant par tour et un prompt fixe de personnage/système de 2,000 tokens. Dans le scénario d’historique complet, les 1 000 requêtes renvoient une conversation de plus en plus longue, pour un total d’environ 351.85M tokens en entrée et 0.5M tokens en sortie.
| Modèle | Scénario à historique compact : 4M en entrée + 0.5M en sortie | Scénario à historique complet : 351.85M en entrée + 0.5M en sortie |
|---|---|---|
| DeepSeek V4 Flash 0731 ($0.05/$0.16) | $0.28 | $17.67 |
| GLM 5.3 Flash ($0.075/$0.25) | $0.43 | $26.51 |
| MiMo-V2.5 ($0.119/$0.238) | $0.60 | $41.99 |
| MiniMax M3 payant ($0.23/$0.96) | $1.40 | $81.41 |
| MiniMax M3 gratuit | $0.00, sous réserve des limites | $0.00, sous réserve des limites |
La colonne à historique compact correspond à une moyenne de 4 000 tokens d’entrée par requête. Avec l’historique complet, les premiers messages sont renvoyés encore et encore ; c’est pourquoi une fenêtre de contexte généreuse ne rend pas automatiquement une campagne de 1 000 tours abordable.
Dans ces hypothèses, le prompt final avec historique complet atteint environ 701,500 tokens en entrée, avant les formats et métadonnées supplémentaires. Une fenêtre de contexte de 1M peut accueillir cet exemple, mais des réponses plus longues, des cards plus volumineuses, des lorebooks ou des templates cachés peuvent la dépasser. La capacité de contexte n’est pas une mémoire automatique.
Le prompt caching peut réduire le coût des entrées répétées lorsque le fournisseur et le chemin de requête le prennent en charge. Consultez la page Activity d’OpenRouter au lieu de supposer que chaque frontend bénéficie du même traitement du cache. Le guide de tarification d’OpenRouter explique plus largement ce modèle de facturation par tokens.
Ce qu’un test de cohérence sûr peut — et ne peut pas — révéler
Une comparaison non explicite peut s’appuyer sur un personnage fictif adulte, une scène anodine et des paramètres identiques sur tous les modèles :
- Insérez trois faits durables dans la character card, par exemple une profession, un lieu et un objectif non sensible.
- Imposez une narration à la troisième personne ou un point de vue clairement défini.
- Effectuez 20 tours avec la même ouverture et une limite de sortie de 400 à 600 tokens.
- Aux tours 5, 10 et 20, demandez au personnage d’agir à partir d’un fait antérieur sans le reformuler.
- Notez les changements de nom, les contradictions factuelles, les bascules de point de vue non souhaitées, les répétitions, les réponses vides et les refus.
Ce protocole compare votre prompt et votre route, pas la qualité universelle des modèles. Un refus peut provenir du modèle, du fournisseur, d’un classifieur du frontend ou du prompt ; ce guide ne communique donc aucun taux de refus. Pour la vitesse, mesurez la latence du premier token et les tokens générés par seconde sur trois exécutions identiques, en notant le modèle et la route du fournisseur.
Combien de temps le niveau gratuit d’OpenRouter permet-il de faire du roleplay ?
Le guide SillyTavern officiel d’OpenRouter indique que les comptes ayant acheté moins de $10 de crédits reçoivent 50 requêtes de modèles gratuits par jour. Après l’achat d’au moins $10 de crédits, le guide indique une allocation de 1,000 requêtes par jour. Il mentionne aussi une limite de 20 requêtes par minute.
Si une génération de l’assistant équivaut à un tour, cela représente environ 50 tours initiaux, ou 1 000 tours initiaux, par jour. Les régénérations, tentatives répétées, requêtes échouées et workflows à plusieurs messages consomment également des requêtes ; le nombre de scènes terminées peut donc être inférieur.
Les deux options gratuites ne se comportent pas de la même manière :
model-name:freefixe la variante gratuite d’un modèle nommé. Le comportement est plus reproductible, mais l’endpoint peut disparaître ou être limité en débit.openrouter/freechoisit automatiquement un modèle gratuit éligible. La documentation Free Models Router d’OpenRouter précise que la sélection est aléatoire après filtrage des capacités, et que la réponse identifie le modèle sous-jacent. C’est pratique pour tester, mais la voix du personnage peut changer entre deux requêtes.
Consultez la collection active de modèles gratuits d’OpenRouter avant de paramétrer un frontend. Ne construisez pas une longue campagne autour d’un slug gratuit copié dans un ancien guide.
Configurer SillyTavern pour une session OpenRouter stable
Le flux officiel d’OpenRouter utilise Chat Completion, et non Text Completion. Une connexion de clé réussie ne garantit toutefois pas que le modèle choisi, la route du fournisseur ou la taille de contexte puissent générer une réponse.
- Ouvrez le panneau API Connections de SillyTavern.
- Sélectionnez API Type: Chat Completion.
- Sélectionnez Source: OpenRouter.
- Autorisez la connexion via le flux disponible ou collez une clé API créée dans les paramètres de clés d’OpenRouter.
- Cliquez sur Connect, sélectionnez le slug exact du modèle, puis envoyez un Test Message.
- Enregistrez un profil de connexion pour le modèle payant et un autre pour la solution gratuite de secours.
Commencez avec une taille de contexte prise en charge par l’endpoint exact, le streaming activé et une limite de sortie modérée. Gardez la character card compacte et résumez les anciens tours avant que le prompt n’approche de la limite de l’endpoint. Testez séparément les paramètres d’échantillonnage, car ils peuvent modifier la longueur des sorties et le rythme.
Si la liste déroulante est vide, reconnectez-vous et actualisez la liste des modèles. Si la connexion fonctionne mais que la génération échoue, vérifiez le slug, les crédits, la disponibilité du fournisseur et un éventuel dépassement du contexte avant de réécrire le prompt.
Configuration de JanitorAI et résolution des erreurs
L’API d’OpenRouter est compatible avec OpenAI. L’endpoint standard de chat completions documenté dans le Quickstart d’OpenRouter est :
https://openrouter.ai/api/v1/chat/completionsL’article ne s’appuie pas sur une capture actuelle de l’interface JanitorAI. Utilisez donc les étapes suivantes comme modèle d’intégration générique compatible OpenAI, puis vérifiez les champs de votre interface JanitorAI actuelle :
- Créez une clé API OpenRouter et conservez-la privée.
- Choisissez l’option OpenAI-compatible ou custom API actuelle, si elle est disponible.
- Saisissez l’URL complète de chat completions si le champ attend un endpoint de complétion.
- Collez l’ID de modèle OpenRouter actuel exact, y compris
:freepour une variante gratuite. - Enregistrez, actualisez JanitorAI et testez avec un court message non explicite.
| Symptôme | Cause probable | Premier correctif |
|---|---|---|
| 401 ou token invalide | La clé est erronée, expirée ou collée avec des caractères en trop | Régénérez la clé et collez-la de nouveau ; n’utilisez pas de clé publique partagée |
| 404 ou aucun endpoint | Le slug du modèle ou l’URL est obsolète | Copiez le slug actuel depuis OpenRouter et vérifiez l’endpoint complet |
| 429 | Limite quotidienne/par minute des modèles gratuits ou surcharge du fournisseur | Attendez, limitez les nouvelles tentatives, basculez vers la solution de secours fixée ou utilisez une route payante |
| Réponse vide | Route non prise en charge, limite de sortie ou dépassement de contexte | Réduisez les réglages de contexte/sortie et testez directement le modèle dans OpenRouter |
| Le bot oublie le début | Le frontend a tronqué l’ancien historique | Réduisez la taille du prompt, résumez les anciens tours et adaptez-vous au contexte de l’endpoint |
| Refus ou changement brutal de style | Politique du fournisseur ou route de secours différente | Vérifiez le modèle/fournisseur réellement utilisé et employez un prompt de test neutre ; « uncensored » n’est pas une garantie |
Confidentialité, routage des fournisseurs et conformité
La FAQ d’OpenRouter indique que le service enregistre des métadonnées de requête de base, comme les horodatages, le modèle et le nombre de tokens, tandis que les prompts et complétions ne sont pas enregistrés par défaut, sauf si l’utilisateur choisit de l’activer. Les fournisseurs en amont peuvent appliquer leurs propres politiques de conservation et d’entraînement.
Zero Data Retention peut restreindre le routage aux fournisseurs respectant la politique de conservation choisie, mais certaines routes gratuites peuvent alors ne plus être disponibles. L’accès gratuit n’est pas une garantie de confidentialité, et « uncensored » n’est pas une propriété technique stable : les fournisseurs peuvent appliquer leurs propres politiques, tandis que le routage peut changer le fournisseur qui traite une requête.
Utilisez des prompts fictifs non explicites et ne tentez pas de contourner les protections des fournisseurs.
FAQ
Quel est actuellement le meilleur modèle OpenRouter pour le roleplay ?
Dans cet instantané, DeepSeek V4 Flash 0731 constitue la référence payante coût/contexte à comparer. Il associe des données d’usage roleplay actuelles sur OpenRouter à un contexte de l’ordre de 1M et à une tarification de $0.05/$0.16 par million de tokens, mais cela ne correspond pas à un score universel de qualité contrôlé.
Quel est le meilleur modèle OpenRouter gratuit pour le roleplay ?
Il n’existe pas de vainqueur permanent : MiniMax M3 est le candidat à essayer gratuitement dans la collection active consultée ici, tandis que openrouter/free est plus pratique mais moins reproductible.
Combien coûtent 1 000 tours de roleplay ?
Avec les hypothèses de ce guide, un usage à historique compact coûte environ $0.28 avec DeepSeek V4 Flash 0731 et $0.43 avec GLM 5.3 Flash ; l’usage à historique complet est modélisé à $17.67 et $26.51 respectivement.
Une fenêtre de contexte plus grande empêche-t-elle le modèle d’oublier ?
Non. Le contexte est le maximum accepté par l’endpoint, pas la garantie que chaque détail sera correctement exploité ; les résumés et les limites appliquées aux tours récents restent importants.
Pourquoi mon modèle de roleplay a-t-il refusé ou changé de comportement ?
Le fournisseur, la route de secours, l’endpoint gratuit ou la limite pratique de contexte ont pu changer. Vérifiez donc l’ID de modèle et la route réellement utilisés avant d’attribuer un refus isolé au modèle dans son ensemble.
Exécutez la même card sûre de 20 tours sur DeepSeek V4 Flash 0731 et sur un endpoint gratuit actuellement disponible, puis enregistrez les deux sous forme de profils nommés. La route payante offre des prix et une disponibilité plus prévisibles ; la route gratuite permet d’expérimenter, au prix d’une capacité et d’une identité de modèle susceptibles de changer.