 AIREITER
Avec un contexte d’un million de tokens et un tarif de 0,68 $ à l’entrée, Mistral Large 4 paraît étonnamment bon marché pour un modèle de mille milliards de paramètres. Mais il s’agit encore d’une preview publique : la remise n’a pas de date de fin annoncée, les limites varient selon la passerelle par rapport aux spécifications mises en avant, et la future licence des poids ouverts n’est pas encore publiée.
La décision en une minute
Mistral Large 4 mérite d’être testé dès maintenant si vous cherchez une API peu coûteuse avec un long contexte pour traiter des documents, des dépôts de code ou des workflows utilisant des outils. En revanche, il est trop tôt pour le considérer comme un remplacement stable à héberger soi-même ou comme un leader confirmé des benchmarks de programmation.
| Besoin | Décision |
|---|---|
| Tester de longs documents ou de grandes bases de code via une API | Testez-le maintenant, en surveillant les taux de cache et le coût de sortie |
| Avoir un tarif prévisible sur le long terme | Attendez ou prévoyez le tarif supérieur de 1,36 $ en entrée et 4,18 $ en sortie |
| Déployer le modèle en privé | Attendez la publication des poids, de la licence, de la quantification et des recommandations de déploiement |
| Obtenir le meilleur score en programmation | Ne vous fiez pas aux seuls chiffres du lancement ; utilisez le même protocole sur vos tâches |
Il s’agit d’une décision concernant une API en preview publique, pas d’un verdict définitif sur le modèle. Mistral a annoncé cette preview le 6 octobre 2026 et indique dans ses documents publics que les poids devraient être publiés d’ici la fin octobre. (Annonce de Mistral)
Ce qui est réellement disponible le 6 octobre
Mistral Large 4 est disponible sous forme d’API en preview publique via Mistral Studio. Mistral le présente comme un modèle multimodal natif à mixture-of-experts, doté de 1,05 billion de paramètres au total et de 49 milliards de paramètres actifs par token. L’annonce officielle mentionne également l’appel de fonctions, les sorties structurées, le question-réponse sur documents, le traitement par lots, les agents et les outils intégrés.
Le modèle est aussi référencé sous le nom mistralai/mistral-large-4-0 sur OpenRouter : l’accès via OpenRouter n’est donc plus une simple rumeur de jour de lancement. Les limites, la latence, la facturation et la politique de bascule peuvent toutefois varier selon la route utilisée.
L’API fonctionne, mais les poids téléchargeables et la licence définitive ne sont pas encore disponibles. La mention « open weight » ne doit pas être assimilée à un projet open source commercial sans restriction tant que Mistral n’a pas publié la fiche du modèle et les conditions d’utilisation.
Pourquoi le tarif se décline en deux montants
Les tarifs actuellement affichés pour la preview dans la documentation du modèle de Mistral sont particulièrement attractifs :
| Type de token | Tarif preview | Tarif possible après la preview, indiqué dans les documents de lancement |
|---|---|---|
| Entrée | 0,68 $ / 1 million de tokens | 1,36 $ / 1 million de tokens |
| Entrée mise en cache | 0,07 $ / 1 million de tokens | 0,14 $ / 1 million de tokens |
| Sortie | 2,09 $ / 1 million de tokens | 4,18 $ / 1 million de tokens |
Les montants réduits sont présentés comme un tarif de preview avec 50 % de remise sur la fiche de la passerelle de Vercel et sur d’autres pages d’accès au modèle, mais aucune date de fin n’est précisée. Considérez donc 0,68 $ et 2,09 $ comme les tarifs actuels, pas comme un engagement permanent.
Pour une charge comprenant 500 000 tokens d’entrée non mis en cache et 100 000 tokens de sortie, la facture en preview s’élève à environ 0,55 $ : 0,34 $ pour l’entrée et 0,209 $ pour la sortie. Si l’entrée est mise en cache, comptez environ 0,244 $ : 0,035 $ pour l’entrée en cache et 0,209 $ pour la sortie. Avant de migrer du trafic de production, évaluez la réutilisation du cache, le volume de sortie et la durée de cette remise.
Le contexte et les capacités varient selon la route
La documentation du modèle de Mistral annonce une fenêtre de contexte d’un million de tokens. Il s’agit d’une caractéristique au niveau du modèle, pas nécessairement de la limite exposée par chaque passerelle.
La page AI Gateway de Vercel indique actuellement un contexte partagé de 524K et une sortie maximale de 262K pour son fournisseur Mistral. Elle affiche également un délai P50 avant le premier token de 0,9 seconde, un débit de 38 tokens par seconde et un taux de cache de 74 %, calculé à partir du trafic de la passerelle.
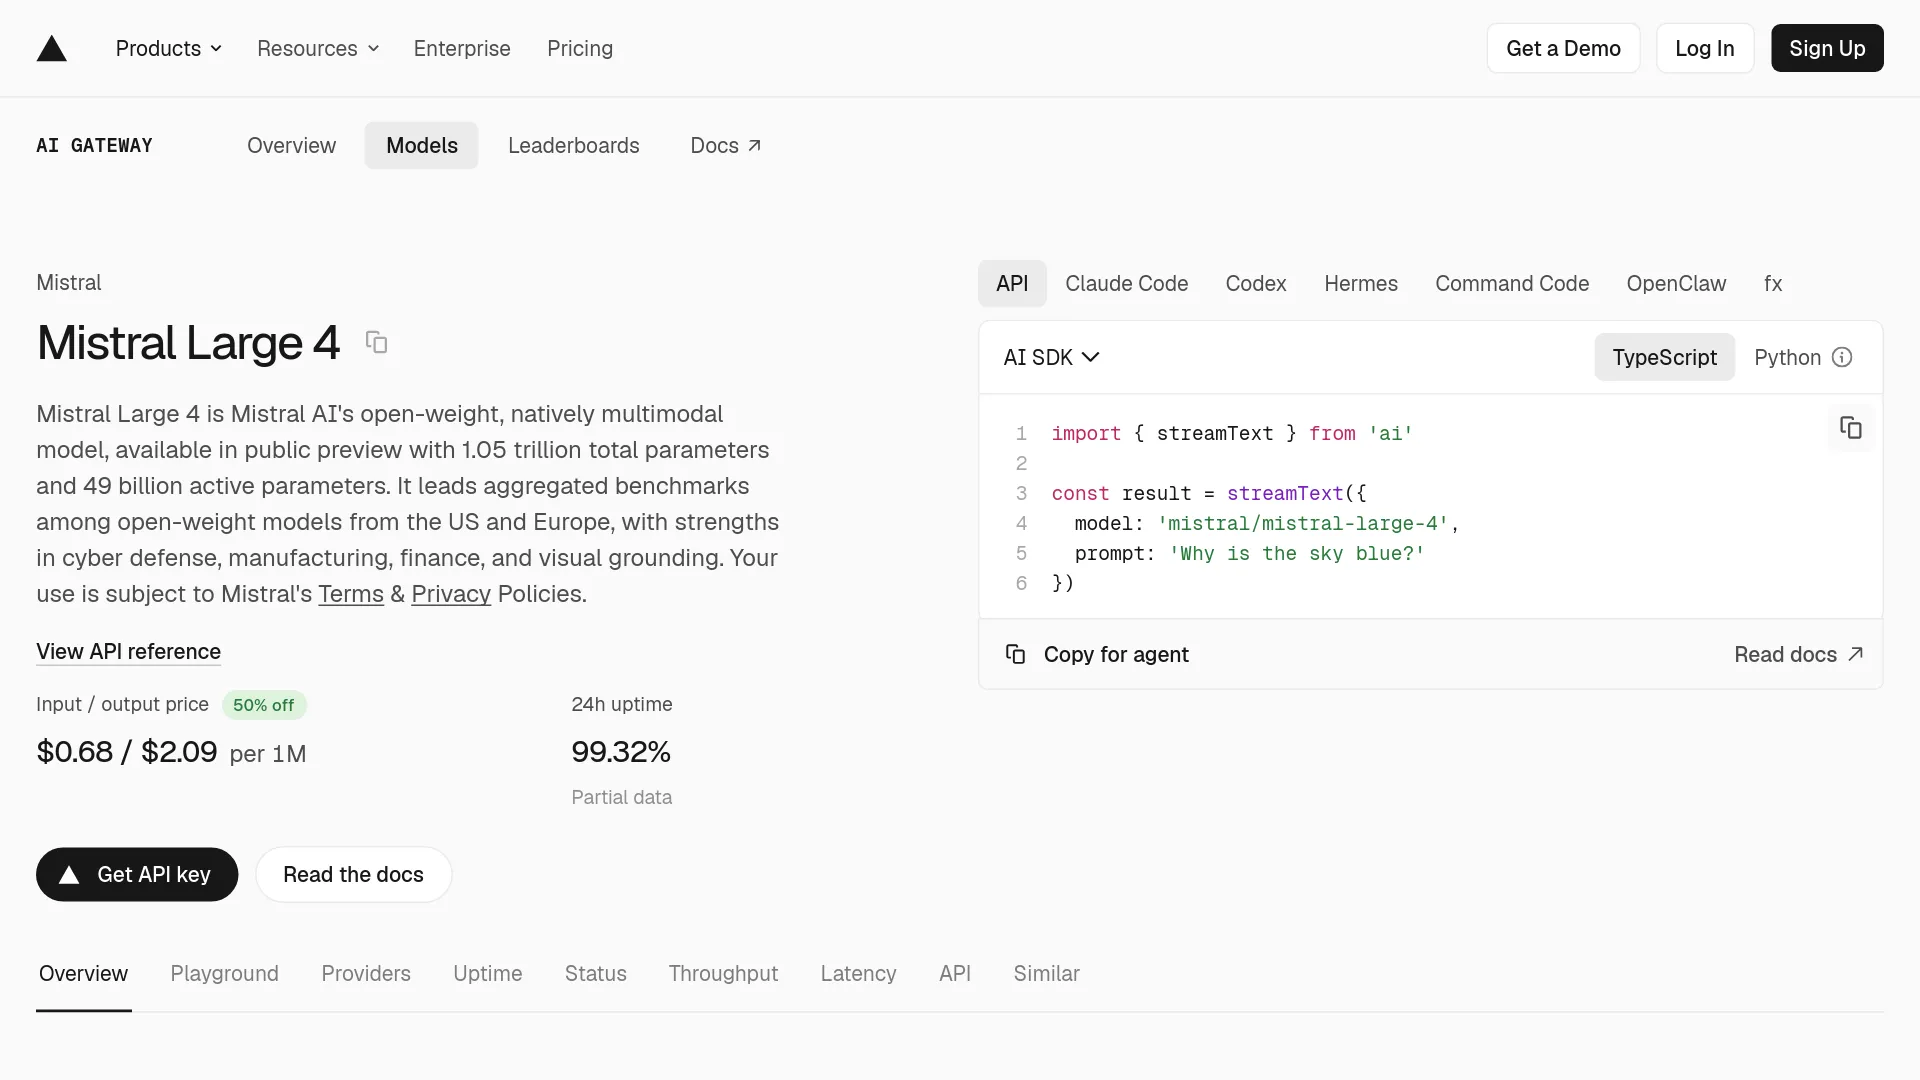
Ces chiffres correspondent à une route précise, pas à des garanties universelles du modèle. La page documente l’entrée d’images, l’appel d’outils, les API Chat Completions et Responses compatibles avec OpenAI, ainsi que l’accès Messages compatible avec Anthropic. Son identifiant de passerelle est mistral/mistral-large-4, contrairement à l’identifiant qualifié par le fournisseur utilisé par OpenRouter.
Pour une intégration, vérifiez le contexte partagé de l’endpoint, la limite de sortie, le décompte des images et des tokens, le comportement des outils, la politique de cache, le routage entre fournisseurs et les règles de bascule. La promesse d’un contexte de 1M est utile pour établir une première sélection, mais elle ne suffit pas à dimensionner une application.
Ce que les benchmarks permettent réellement de conclure
L’analyse du lancement publiée par TechsCurrent rapporte les chiffres de Mistral, soit 61,7 % sur DeepSWE v1.1, 28,3 % sur Terminal-Bench 4 et 59,9 % sur AutomationBench. La comparaison publiée par CellCog cite un score de 74,2 pour DeepSeek V4.1 Flash sur DeepSWE, contre 61,7 pour Mistral Large 4, tandis que le score de Mistral sur AutomationBench est supérieur à celui des modèles de comparaison. Il s’agit de signaux communiqués par les fournisseurs ou issus de sources différentes, pas d’un classement standardisé unique.
Avant d’utiliser le modèle pour des agents en production, lancez une évaluation figée :
- Utilisez le même dépôt, le même prompt, les mêmes outils et le même délai d’expiration pour Mistral Large 4 et le modèle actuellement utilisé.
- Mesurez le taux de réussite, les erreurs dans les arguments d’outils, les nouvelles tentatives, la latence, le nombre de tokens générés et le coût.
- Ajoutez des cas de récupération sur long contexte où la réponse se trouve au milieu puis vers la fin de l’entrée.
- Répétez le test avec un contexte mis en cache puis sans cache.
- Conservez les résultats de la preview séparément de ceux qui seront obtenus après la publication des poids.
À qui le modèle s’adresse dès maintenant
Équipes orientées API avec un contexte récurrent volumineux : testez Mistral Large 4 dès maintenant. Le tarif de 0,07 $ pour l’entrée mise en cache peut faire la différence lorsqu’un agent renvoie régulièrement le même préambule de règles, de dépôt ou de document. Fixez une limite de dépenses pour l’expérience, car le tarif supérieur reste plausible.
Équipes qui développent des workflows documentaires capables d’analyser des images : testez l’entrée d’images et l’extraction de documents sur la route que vous comptez utiliser en production. Le modèle accepte les images, mais les limites propres à chaque route et les détails de facturation doivent encore être vérifiés.
Équipes qui développent des agents de programmation : considérez-le comme un candidat, pas comme un vainqueur automatique. Les résultats de benchmark disponibles sont contrastés et la fiabilité réelle dépend des appels d’outils, des nouvelles tentatives et du taux de réussite.
Équipes sensibles à la confidentialité ou souhaitant héberger le modèle : attendez la publication des poids et de la licence. Les 49 milliards de paramètres actifs ne signifient pas que le checkpoint complet est léger : le modèle total doit toujours être stocké et servi. Le matériel nécessaire, la quantification, le débit et les droits de redistribution restent à déterminer.
FAQ sur l’API Mistral Large 4
Mistral Large 4 est-il déjà open source ?
Non. Lors du lancement, aucune licence définitive ni aucun poids téléchargeable n’étaient disponibles. Mistral prévoyait de publier les poids d’ici la fin octobre 2026, mais la seule mention « open weight » ne définit ni les droits d’usage commercial ni les droits de redistribution.
Le tarif de 0,68 $ est-il permanent ?
Aucune date de fin n’est annoncée. Établissez vos budgets de test sur la base des tarifs actuels de 0,68 $ en entrée et 2,09 $ en sortie, tout en modélisant les montants de 1,36 $ et 4,18 $.
La fenêtre de contexte est-elle de 1M ou de 524K ?
Mistral documente un contexte de 1M tokens au niveau du modèle ; Vercel indique un contexte partagé de 524K pour sa route de passerelle. Confirmez la limite correspondant au fournisseur et au format d’API que vous utiliserez.
Est-il déjà disponible sur OpenRouter ?
Oui, OpenRouter référence actuellement mistralai/mistral-large-4-0. Consultez la page en ligne avant le déploiement, car le routage d’une preview peut évoluer.
Peut-il gérer les images et les outils ?
La documentation officielle et celle des passerelles décrivent la prise en charge des images et l’appel d’outils. Testez le format des requêtes, les limites d’images, le décompte des tokens et le comportement en cas d’appel d’outil mal formé sur la route de votre choix.
Devrai-je l’héberger moi-même lorsque les poids seront disponibles ?
Pas automatiquement. Attendez de connaître la licence, les formats de checkpoint, les options de quantification, les besoins en mémoire, les données de débit et la configuration de référence pour le servir.
Le prochain test à lancer
Préparez une évaluation de 20 tâches avant d’acheminer du trafic réel : cinq tâches de récupération sur long contexte, cinq modifications de code, cinq questions sur des images ou des documents et cinq tâches d’appel d’outils. Consignez le taux de réussite, les nouvelles tentatives, le délai avant le premier token, la latence totale, les tokens d’entrée, de cache et de sortie, ainsi que le coût effectif par tâche réussie.
Sources : documentation du modèle Mistral, annonce de Mistral, Vercel AI Gateway, page du modèle sur OpenRouter, TechsCurrent, CellCog.