 AIREITER
Sur FinanceBench — 368 dépôts SEC, environ 53 900 pages et 150 questions — Mistral affirme que sa nouvelle couche Agentic Search améliore la précision des réponses de 47 à 53 points par rapport à un RAG one-shot avec une boucle limitée à la recherche. Avec la boucle complète de navigation, le gain monte jusqu’à 59 points, tout en réduisant la consommation de tokens jusqu’à un tiers. La contrepartie est nette côté latence : la boucle complète atteint encore 154 secondes au p90 et 71 secondes en moyenne.
Annoncé le 20 août 2026, Mistral Agentic Search est une couche de retrieval pensée pour les corpus d’entreprise complexes : dépôts réglementaires, contrats ou PDF numérisés. Il ne s’agit pas d’une évolution de la recherche web. Ici, les minutes nécessaires à la boucle sont le prix à payer pour gagner en précision.
Mistral Agentic Search, concrètement
Lancé le 20 août 2026, Mistral Agentic Search ajoute à un index existant une boucle de recherche en plusieurs étapes articulée autour de cinq outils : search, open, navigate, read et grep. La solution est disponible via le Mistral Search Toolkit et intégrée aux Libraries de Studio et Vibe. Vous conservez votre index, sans fine-tuning requis : la boucle agentique prend en charge les questions auxquelles une simple récupération de chunks ne suffit pas à répondre.
Une boucle en cinq outils : search, open, navigate, read, grep
L’exemple détaillé par Mistral est parlant : les dépenses américaines de défense nationale sur l’année civile 1953. Un unique appel de recherche avait remonté les chiffres de janvier à juin, mais manquait ceux de juillet à décembre. Le parcours agentique a, lui, lancé deux recherches, identifié treasury_bulletin_1954_02.pdf, puis lu la page 15 et son tableau 3. Il a ainsi récupéré les douze valeurs mensuelles et calculé un total annuel de 44 463 millions de dollars.
| Outil | Rôle |
|---|---|
search | Interroge l’index pour trouver les sources les plus pertinentes |
open | Ouvre un document identifié |
navigate | Se déplace vers une page, un tableau ou une section du document |
read | Extrait le contenu à cet emplacement |
grep | Recherche des tokens, codes ou identifiants exacts par motif |
Un RAG one-shot récupère un ensemble fixe de chunks, puis doit répondre en un seul passage. S’il obtient de mauvais résultats, il ne peut pas demander un document supplémentaire. La boucle peut au contraire comparer des sources, suivre des renvois vers des notes de bas de page ou des tableaux, et corriger une récupération incomplète. Selon Mistral, le compromis ne consiste pas à multiplier les tentatives et les tours inutiles, mais à les réduire.
Ce que disent réellement les benchmarks
L’annonce présente deux suites de benchmarks, toutes deux communiquées par l’éditeur et exécutées avec les réglages par défaut du Search Toolkit, sans tuning. Mistral les décrit ainsi : « these results are floors, not ceilings ». FinanceBench (Islam et al., 2023 ; version ouverte sur GitHub) rassemble 368 dépôts SEC de type 10-K, 10-Q et 8-K. D’après le comptage de Mistral, chacun compte environ 147 pages. Les 150 questions sont évaluées dans la configuration de Mistral par un LLM calibré sur des annotations humaines.
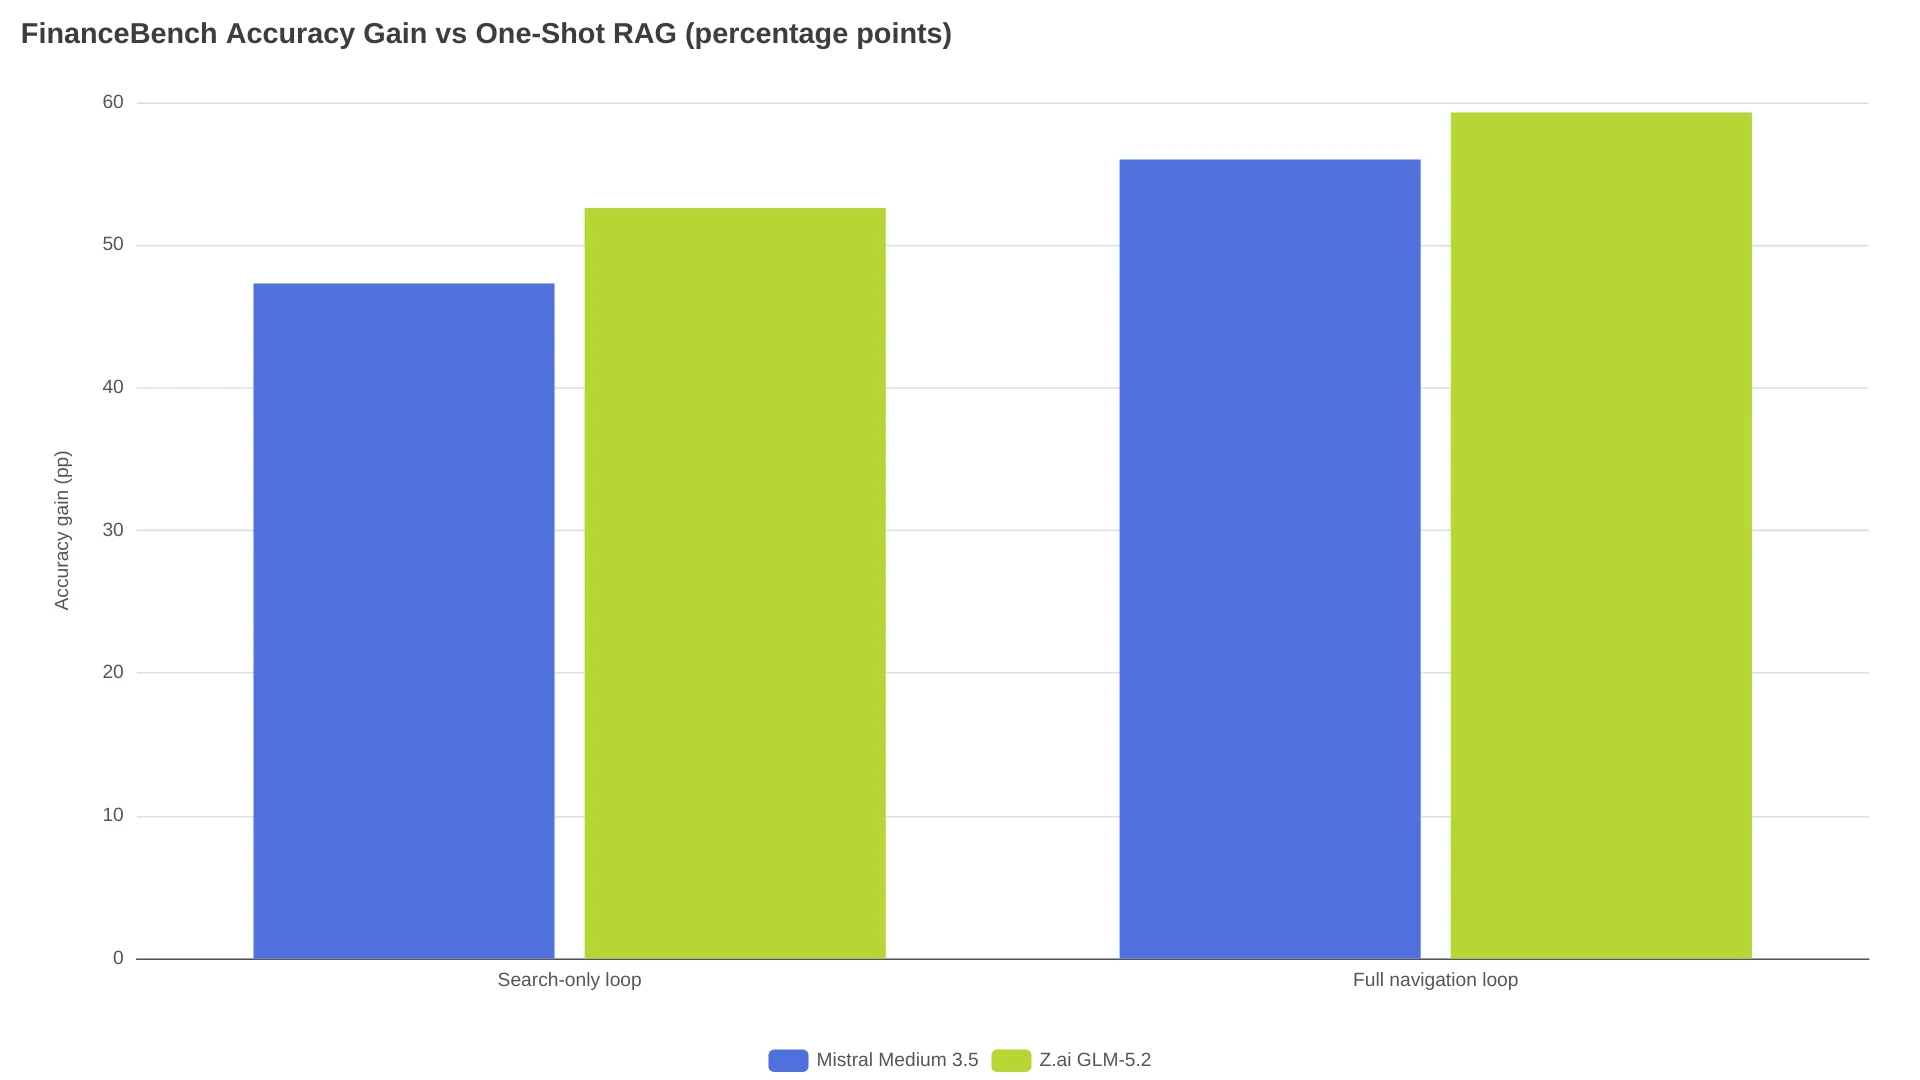
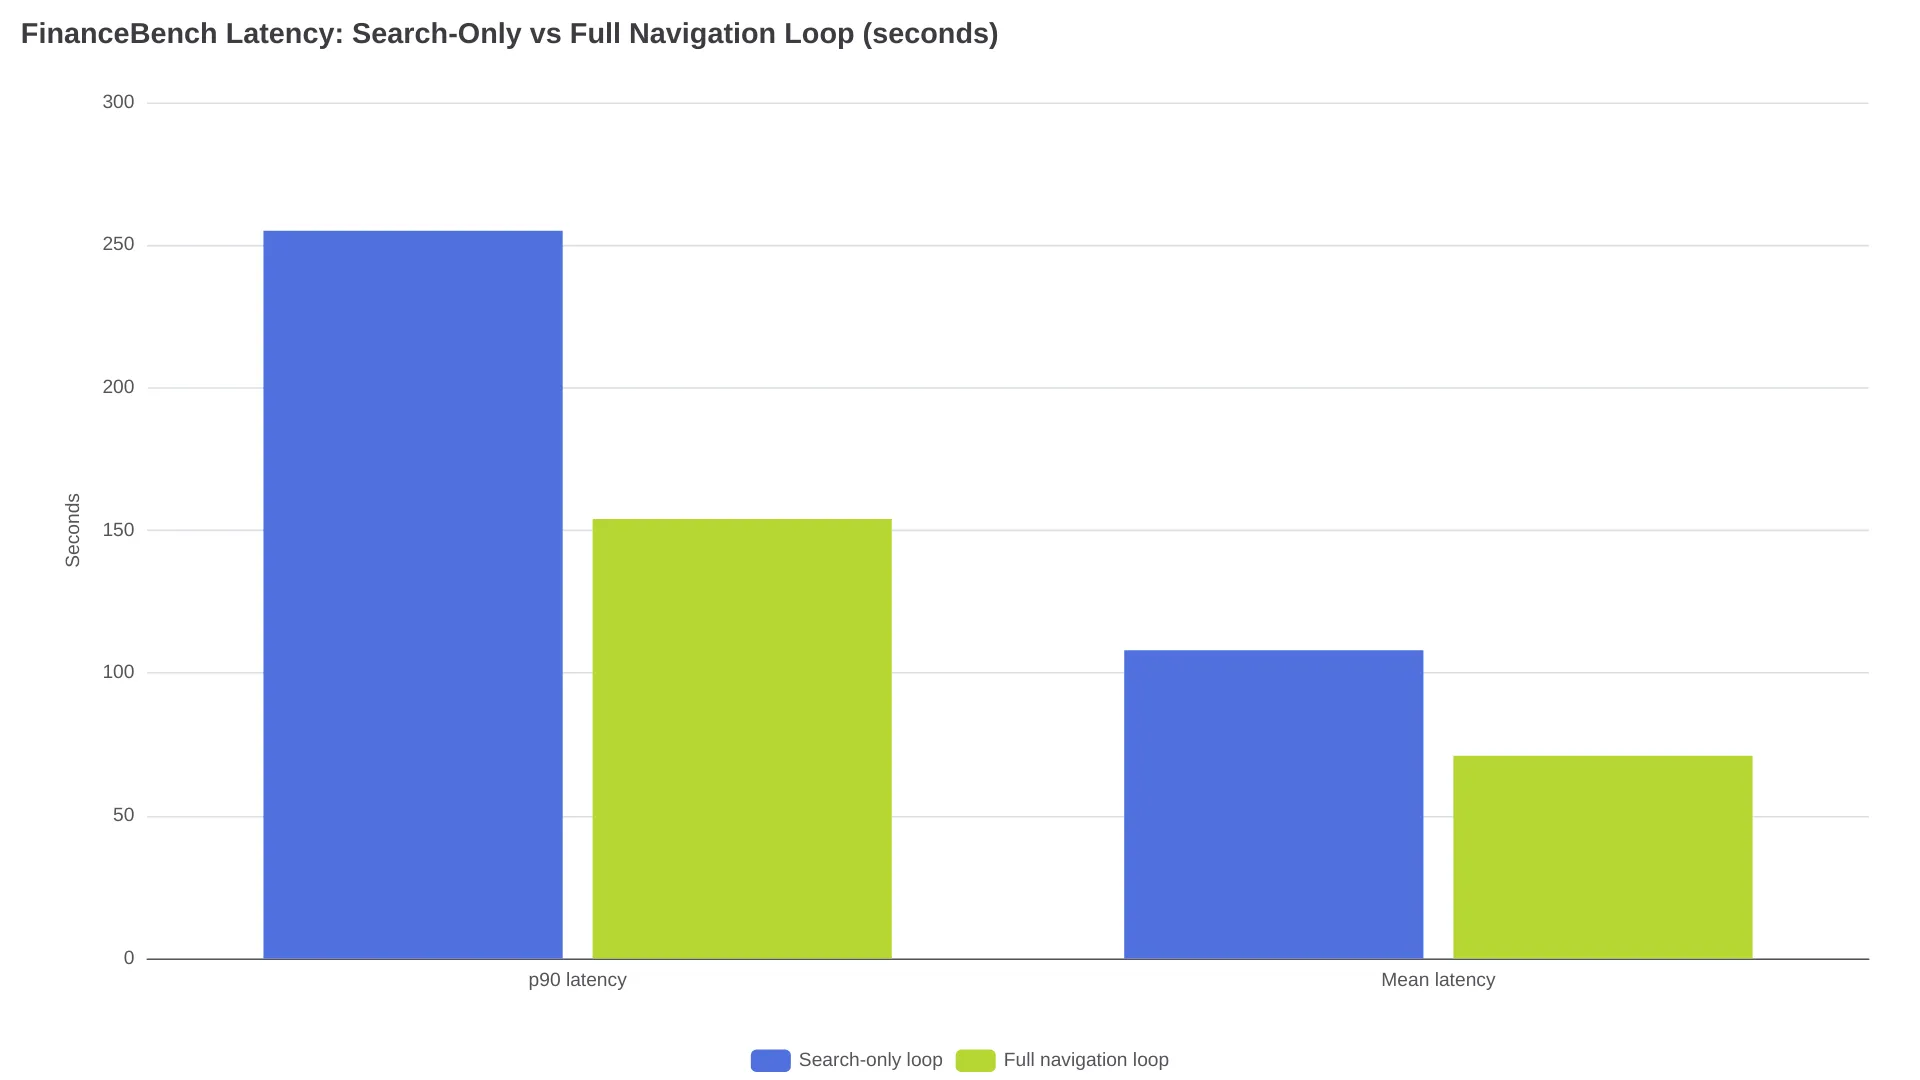
L’ajout des outils de navigation — open, navigate, read et grep — à la boucle limitée à la recherche apporte encore +8,7 points pour Mistral Medium 3.5 et +6,7 points pour GLM-5.2. Comparée à cette boucle agentique de recherche seule, la boucle complète de navigation utilise 23,9 % de tokens en moins avec Mistral Medium 3.5, et 33,7 % de moins avec GLM-5.2. La latence évolue dans le même sens : le p90 passe de 255 à 154 secondes, et la moyenne de 108 à 71 secondes. Point important : cette réduction de tokens est mesurée face à la boucle agentique de recherche seule, pas face au RAG one-shot.
OfficeQA Pro est la suite la plus difficile : 696 anciens Treasury Bulletins américains, environ 89 000 pages de PDF gouvernementaux numérisés et riches en tableaux, pour 133 questions. Avec la boucle complète, GLM-5.2 atteint 51,9 % de précision, soit un gain de +45,6 points qui implique une base one-shot de 6,3 %. Mistral Medium 3.5 progresse de +27,1 points. La navigation réduit aussi le nombre de tours, jusqu’à 7,0 %.
Mistral a évalué son propre Mistral Medium 3.5 ainsi que Z.ai GLM-5.2, un modèle tiers, et observe le même schéma de gains dans les deux cas. L’annonce cite également des travaux de Kimi, selon lesquels GLM-5.2 atteint 41,4 % sur OfficeQA Pro avec un harness Claude Code, contre 51,9 % avec le harness de Mistral. Aucune source primaire de Kimi n’est liée : l’écart de 10,5 points entre les harnesses est donc caractérisé par Mistral. Sa conclusion — « retrieval quality scales with model capability » — est que le goulot d’étranglement se situe dans le harness, pas dans le modèle.
Dans quels cas le RAG one-shot reste préférable
Mistral le reconnaît : la récupération indexée reste la base, et la boucle agentique intervient lorsque les premiers résultats ne suffisent pas. Le choix dépend surtout de la forme des documents et de votre budget de latence :
| Votre cas d’usage | Point de départ recommandé |
|---|---|
| Recherches directes dans des documents courts et propres | RAG one-shot |
| Récupération sémantique ou par mots-clés à fort volume | RAG one-shot |
| Réponses situées à des emplacements connus | RAG one-shot |
| Dépôts, contrats ou manuels avec tableaux et notes de bas de page | Agentic Search |
| PDF numérisés riches en tableaux | Agentic Search |
| Réponses réparties sur plusieurs documents à rapprocher | Agentic Search |
| Exigences de latence interactive, en secondes | RAG one-shot |
Si un p90 de 154 secondes rend votre produit inutilisable, aucun gain de précision ne compensera ce défaut. L’analyse par lots d’états financiers est une tout autre situation.
À ne pas confondre avec l’outil web_search
En recherchant ce produit, Google fait remonter la documentation websearch de Mistral — mais il s’agit d’un autre produit. Les outils web_search et web_search_premium appartiennent à l’Agents API : ils effectuent des recherches en direct sur le web avec citations. Ils sont facturés respectivement 30 $ et 50 $ pour 1 000 appels sur la page de tarifs API de Mistral, auxquels s’ajoutent les tokens du modèle. Agentic Search procède à l’inverse : il explore votre propre corpus indexé, sans interroger le web ouvert. Ces outils ne répondent pas au même besoin, et un seul dispose de tarifs publiés : l’annonce ne donne aucun prix pour Agentic Search.
Deux points d’entrée
- Search Toolkit. Des modules ouverts pour l’ingestion, les embeddings et l’indexation, déployables dans le cloud ou sur site. Les parseurs, le chunking, les modèles d’embeddings, les schémas Vespa, les profils de ranking et la récupération hybride sont configurables.
- Libraries de Studio et Vibe. L’option managée. Une Search Starter App peut créer un index local sur votre corpus avec la configuration par défaut : c’est le moyen le plus rapide de reproduire la configuration des benchmarks avant tout tuning.
Quel que soit votre choix, faites passer les mêmes questions représentatives dans un RAG one-shot et dans la boucle complète, puis comparez la qualité des réponses, la consommation de tokens et la latence p90 avant de vous engager.
Ce qui reste inconnu au lancement
Mistral n’a publié aucun tarif pour Agentic Search, et les résultats des benchmarks proviennent de l’éditeur. Aucune réplication indépendante avec prise en main n’était disponible au lancement. Les premières réactions publiques restent des impressions initiales :
« mistral vient d’ajouter l’agentic search à son API : c’est le bon choix. intégrer une recherche façon Perplexity dans un outil agent natif nous évite d’écrire des pipelines fragiles de web scraping et de gérer nous-mêmes la rotation des proxys. » — @AbdoKerdawy, développeur de produits IA (X)
Les affirmations sur les tokens suscitent déjà des réserves auxquelles l’annonce de Mistral ne répond pas entièrement :
« L’outil de retrieval agentique de Mistral affirme réduire les échecs de recherche en un passage de plus de 40 %. S’il contourne les consultations de base de données, réduira-t-il le nombre de tokens à dépenser ? » — @therawlogs, blogueur indépendant (X)
La réponse officielle tient dans une réduction de 24 à 34 % des tokens par rapport à la boucle de recherche seule. Reste à savoir si cela se vérifie hors des corpus de benchmark : seule une exécution indépendante sur le jeu FinanceBench ouvert permettrait de le trancher.
Les produits voisins se heurtent à la même contrainte. Le mode de recherche agentique Toast-1 de Mixedbread limite sa boucle à quatre tours et huit appels de récupération parallèles, et sa documentation indique clairement qu’il est plus lent qu’une recherche unique. Dans cette catégorie, la latence est le prix payé pour la précision.
Réponses directes
Mistral Agentic Search est-il disponible via l’Agents API ?
Non. Il est proposé via le Mistral Search Toolkit et les Libraries de Studio et Vibe. L’outil web_search de l’Agents API est un produit distinct de recherche web en direct, avec sa propre tarification.
Agentic Search réduit-il vraiment la consommation de tokens ?
D’après les benchmarks officiels, la boucle complète de navigation a utilisé 23,9 à 33,7 % de tokens en moins que la boucle agentique de recherche seule sur FinanceBench. Aucune réplication indépendante n’a encore été publiée.
Quels modèles fonctionnent avec Agentic Search ?
Mistral a testé Mistral Medium 3.5 et Z.ai GLM-5.2, avec des gains cohérents. L’éditeur présente cette couche comme agnostique au modèle et ne nécessitant aucun fine-tuning.
Combien coûte Mistral Agentic Search ?
Aucun tarif n’a été publié pour Agentic Search. Le prix de 30 $ pour 1 000 appels indiqué sur la page tarifaire de Mistral concerne l’ancien outil agentique web_search.
Le compromis non résolu est simple : ici, la précision s’achète en minutes. Pour du traitement par lots sur des dépôts, des contrats ou des archives gouvernementales numérisées, un gain de précision de +45 à +59 points — respectivement sur OfficeQA Pro et FinanceBench avec la boucle complète — ainsi qu’une baisse d’un tiers des tokens face à une boucle plus lente constituent un échange rationnel. Pour un usage directement exposé aux utilisateurs, 71 secondes de latence moyenne restent rédhibitoires. Et tant qu’un acteur extérieur à Mistral n’aura pas relancé FinanceBench, les chiffres les plus impressionnants de cette page resteront ceux du fournisseur.
À lire aussi : le guide API GLM-5.2 et le test de GLM-5.2, consacrés au second modèle évalué dans les tests de Mistral.