 AIREITER
Le dépôt d'origine facebookresearch/demucs est en lecture seule depuis le 1er janvier 2025. Demucs reste pourtant l'une des meilleures solutions gratuites à exécuter soi-même pour séparer les stems, à condition de l'installer depuis le fork qui a publié la version 4.1.0. Il faut simplement accepter ses limites : la guitare et le piano sont les premiers instruments à en pâtir.
Partez du dépôt Demucs maintenu, pas de l'ancien dépôt archivé
Deux dépôts GitHub affichent le même README, mais un seul reçoit encore des correctifs. facebookresearch/demucs est archivé et en lecture seule ; son propre README renvoie d'ailleurs vers un autre dépôt. Le projet est désormais maintenu sur adefossez/demucs. Son auteur, Alexandre Défossez, y précise qu'il s'agit de « Demucs officiellement maintenu maintenant que j'ai quitté Meta pour rejoindre Kyutai », tout en prévenant qu'il faut « s'attendre à des réponses lentes et à aucune nouvelle fonctionnalité pour le moment ».
La différence ne concerne donc pas uniquement l'URL : elle modifie aussi la manière d'installer l'outil.
Ce que v4.1.0 a changé
La note de version datée du 11/07/2026 présente Demucs v4.1.0 comme une version dotée d'un « packaging modernisé, de dépendances d'inférence allégées, de nombreux correctifs et de modèles préentraînés hébergés sur Hugging Face ». En pratique :
| Élément | Dépôt archivé | Dépôt maintenu (v4.1.0) |
|---|---|---|
| Version minimale de Python | 3.8 | 3.10 |
| Exécution la plus rapide | pip install -U demucs | uvx demucs MY_TRACK.mp3 (aucune installation) |
| Installation permanente | pip install -U demucs | uv tool install demucs (pip fonctionne toujours) |
| ffmpeg | Obligatoire | Facultatif, mais nécessaire pour produire du FLAC et lire les formats que sphn ne peut pas décoder |
| Modèles quantifiés | Inclus | Nécessitent l'extra : uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Hébergement des poids | dl.fbaipublicfiles.com | Hugging Face |
Autre piège à connaître avant d'ouvrir un ticket : PyTorch a abandonné la prise en charge des Mac Intel après la version 2.2. Les utilisateurs concernés sont donc limités à Python 3.12 et doivent lancer uvx --python 3.12 demucs.
Choisir son modèle : htdemucs, htdemucs_ft, htdemucs_6s ou mdx
L'option -n permet de sélectionner le modèle, et celui utilisé par défaut n'est pas toujours le meilleur choix. Demucs propose des modèles à quatre sources — batterie, basse, autres et voix —, une expérimentation à six sources ainsi que les anciens modèles issus du challenge MDX.
| Modèle | Sources | Vitesse | Réserve officielle | À choisir quand |
|---|---|---|---|---|
htdemucs | 4 | Référence (par défaut) | Aucune mention particulière | Premier essai, traitement par lots ou dès que le débit compte |
htdemucs_ft | 4 | Environ 4 fois plus lent | « pourrait être un peu meilleur » | Rendu final d'un morceau important |
htdemucs_6s | 6 | Intermédiaire | Guitare « correcte » ; piano « pas très bien géré », avec « beaucoup de fuites et d'artefacts » | Vous avez spécifiquement besoin d'une piste de guitare et pouvez accepter un résultat imparfait |
hdemucs_mmi | 4 | Référence | Architecture v3 réentraînée | Pour comparer si v4 sonne mal sur un mix précis |
mdx / mdx_extra | 4 | Référence | mdx_extra a été entraîné sur des données incluant l'ensemble de test MUSDB | Anciennes productions ou artefacts gênants avec v4 |
mdx_q / mdx_extra_q | 4 | Les plus rapides et les moins volumineux | « la qualité peut être légèrement inférieure » | Machines disposant de peu de stockage ou préécoutes rapides |
La formulation employée pour htdemucs_ft mérite attention : il faut multiplier les calculs par quatre pour un gain de qualité que l'auteur décrit lui-même comme seulement possible. Sur CPU, la pénalité est sévère, et les utilisateurs le signalent clairement.
Ce que mesurent réellement les scores SDR de 9,00 et 9,20 dB
Les deux chiffres apparaissent dans le même paragraphe du README, mais ils ne désignent pas la même chose. Hybrid Transformer Demucs atteint 9,00 dB de SDR sur l'ensemble de test MUSDB HQ. Le score supérieur de 9,20 dB nécessite des noyaux d'attention parcimonieuse ainsi qu'un fine-tuning par source. Or ce modèle parcimonieux « n'est pas fourni, car il nécessite du code CUDA personnalisé qui n'est pas encore prêt à être publié ».
Aucun modèle téléchargeable ne permet donc de reproduire 9,20 dB. Dans le tableau comparatif du README, la version v4 fine-tunée disponible atteint 9,0 de SDR global, à égalité avec Band-Split RNN entraîné sur 1,7 k mixages.
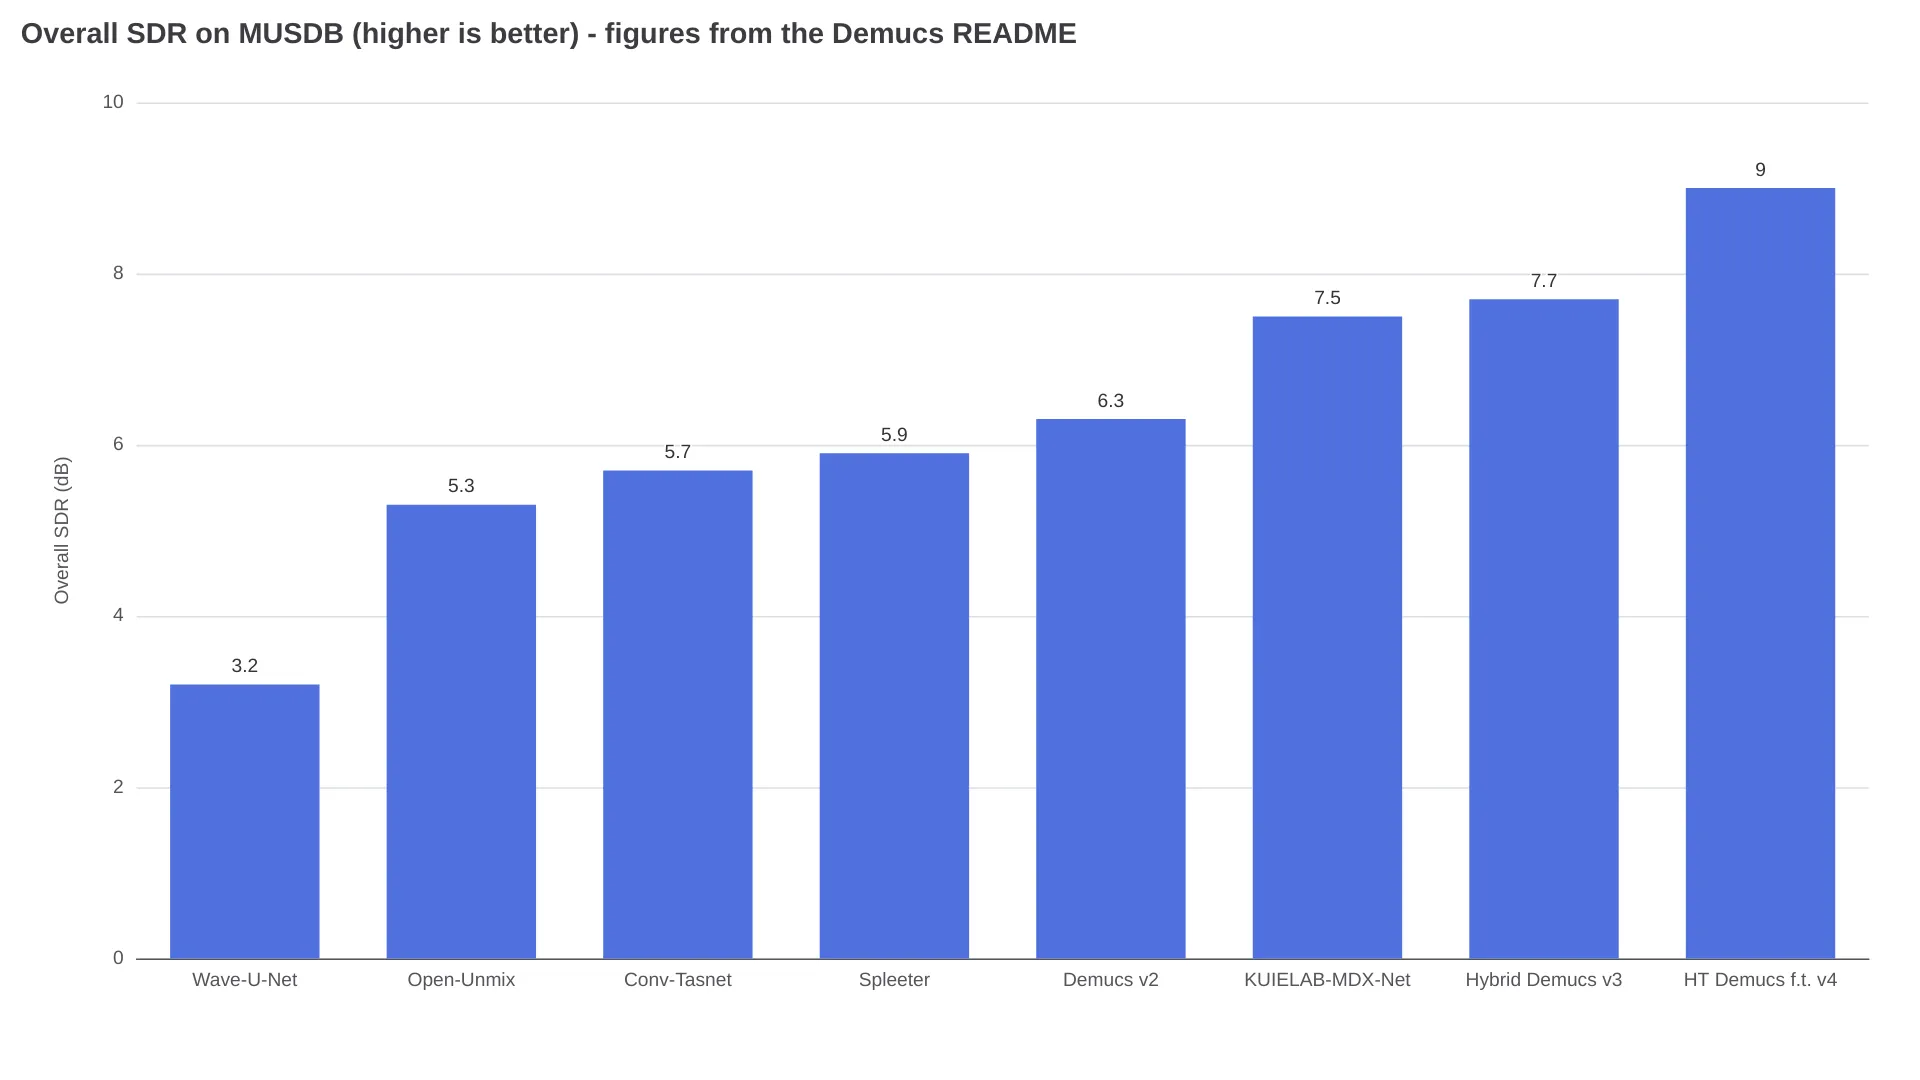
Dans ce même tableau, Spleeter plafonne à 5,9 dB malgré un entraînement sur 25 k morceaux, soit environ 3 dB de moins que l'entrée v4 fine-tunée.
Les options qui modifient le résultat
La plupart des traitements Demucs reposent sur trois choix : le nombre de stems, le volume de calcul à investir et le format de sortie.
--two-stems=vocalsactive le mode karaoké et produitvocals.wavainsi queno_vocals.wav. Demucs sépare d'abord le mix complet avant de recombiner les pistes : cette option n'est donc ni plus rapide ni moins gourmande en mémoire qu'un traitement normal.--shifts=Nfait la moyenne de N prédictions appliquées à des versions décalées aléatoirement du signal. Le traitement devient N fois plus lent ; le README conseille de « ne pas l'utiliser sans GPU ». L'article scientifique employait 10 décalages, contre 1 par défaut sur Replicate.--overlapvaut 0,25 par défaut. Vous pouvez le réduire à 0,1 pour gagner un peu de vitesse.--segment Nest le réglage à utiliser en cas d'erreur OOM. Mais un détail casse discrètement beaucoup de commandes copiées-collées : les modèles Hybrid Transformer acceptent une durée de segment maximale de 7,8 secondes. Une valeur élevée de--segmentn'a donc d'effet qu'avec les modèles qui ne reposent pas sur HT.- Options de sortie :
--mp3(320 kbit/s par défaut),--flac(nécessite ffmpeg),--int24et--float32. Par défaut, Demucs produit un WAV int16 en 44,1 kHz dansseparated/MODEL_NAME/TRACK_NAME. --clip-modea plus d'importance qu'il n'y paraît. Demucs redimensionne par défaut les stems pour éviter l'écrêtage, ce qui peut modifier leur équilibre de volume relatif. Avecclamp, il applique plutôt une limitation stricte.
Le même document indique qu'il faut au moins 3 Go de mémoire vidéo, et environ 7 Go avec les options par défaut. Si vous disposez de 3 Go ou moins, utilisez --segment 8 avec PYTORCH_NO_CUDA_MEMORY_CACHING=1. Sur CPU, le « temps de traitement devrait être environ égal à 1,5 fois la durée du morceau ». C'est une estimation optimiste comparée aux retours sur htdemucs_ft.
Les fuites de Demucs et la méthode en deux passes
Les fuites sont le reproche qui revient le plus souvent, notamment lorsque les voix partagent leur registre avec un instrument principal. Ryan Herr (@rrherr) l'a résumé sans détour après une tentative d'extraction :
demucs a laissé beaucoup de saxophone fuir dans la piste « vocals ».
La solution vers laquelle convergent les utilisateurs expérimentés n'est pas une option supplémentaire, mais l'emploi d'un second modèle. Le producteur japonais 夜凪P (@yonagip, 145 mentions J'aime) explique utiliser d'abord MelBand Roformer dans UVR5 pour séparer les voix de l'instrumental, puis envoyer uniquement l'instrumental dans htdemucs_ft afin d'en extraire la batterie, la basse et les autres éléments :
Demucs単体だとVoが他に漏れるんだけど (avec Demucs seul, les voix fuient vers les autres stems)
Deux autres retours vont dans le même sens. Un producteur constate une meilleure définition de la basse avec htdemucs_ft, mais un traitement quatre fois plus lent sur CPU (@hachi_vm). Un autre publie une comparaison d'extraction de guitare où htdemucs-6s est nettement devancé par un modèle BS-RoFormer (@junon_12). Ces témoignages restent anecdotiques et ne remplacent pas des benchmarks, mais ils correspondent à la réserve officielle : lors de l'annonce du modèle à six sources en décembre 2022, Défossez écrivait avoir observé « quelques fuites et artefacts ».
La règle pratique : avec un saxophone, une guitare lead ou un piano mélodique, considérez la première passe de Demucs comme un point de départ, pas comme un rendu final. Les alternatives de la famille Roformer sont accessibles via l'interface UVR5 si une seconde passe s'impose.
Utiliser Demucs via une API plutôt que l'installer
Si vous voulez obtenir des stems sans mettre en place un environnement Python, cjwbw/demucs sur Replicate est une solution hébergée très utilisée : environ 1,5 million d'exécutions sur des GPU Nvidia T4, pour un coût annoncé sur la page d'environ 0,020 $ par exécution (environ 50 exécutions par dollar). Les prédictions se terminent généralement en moins de 90 secondes.
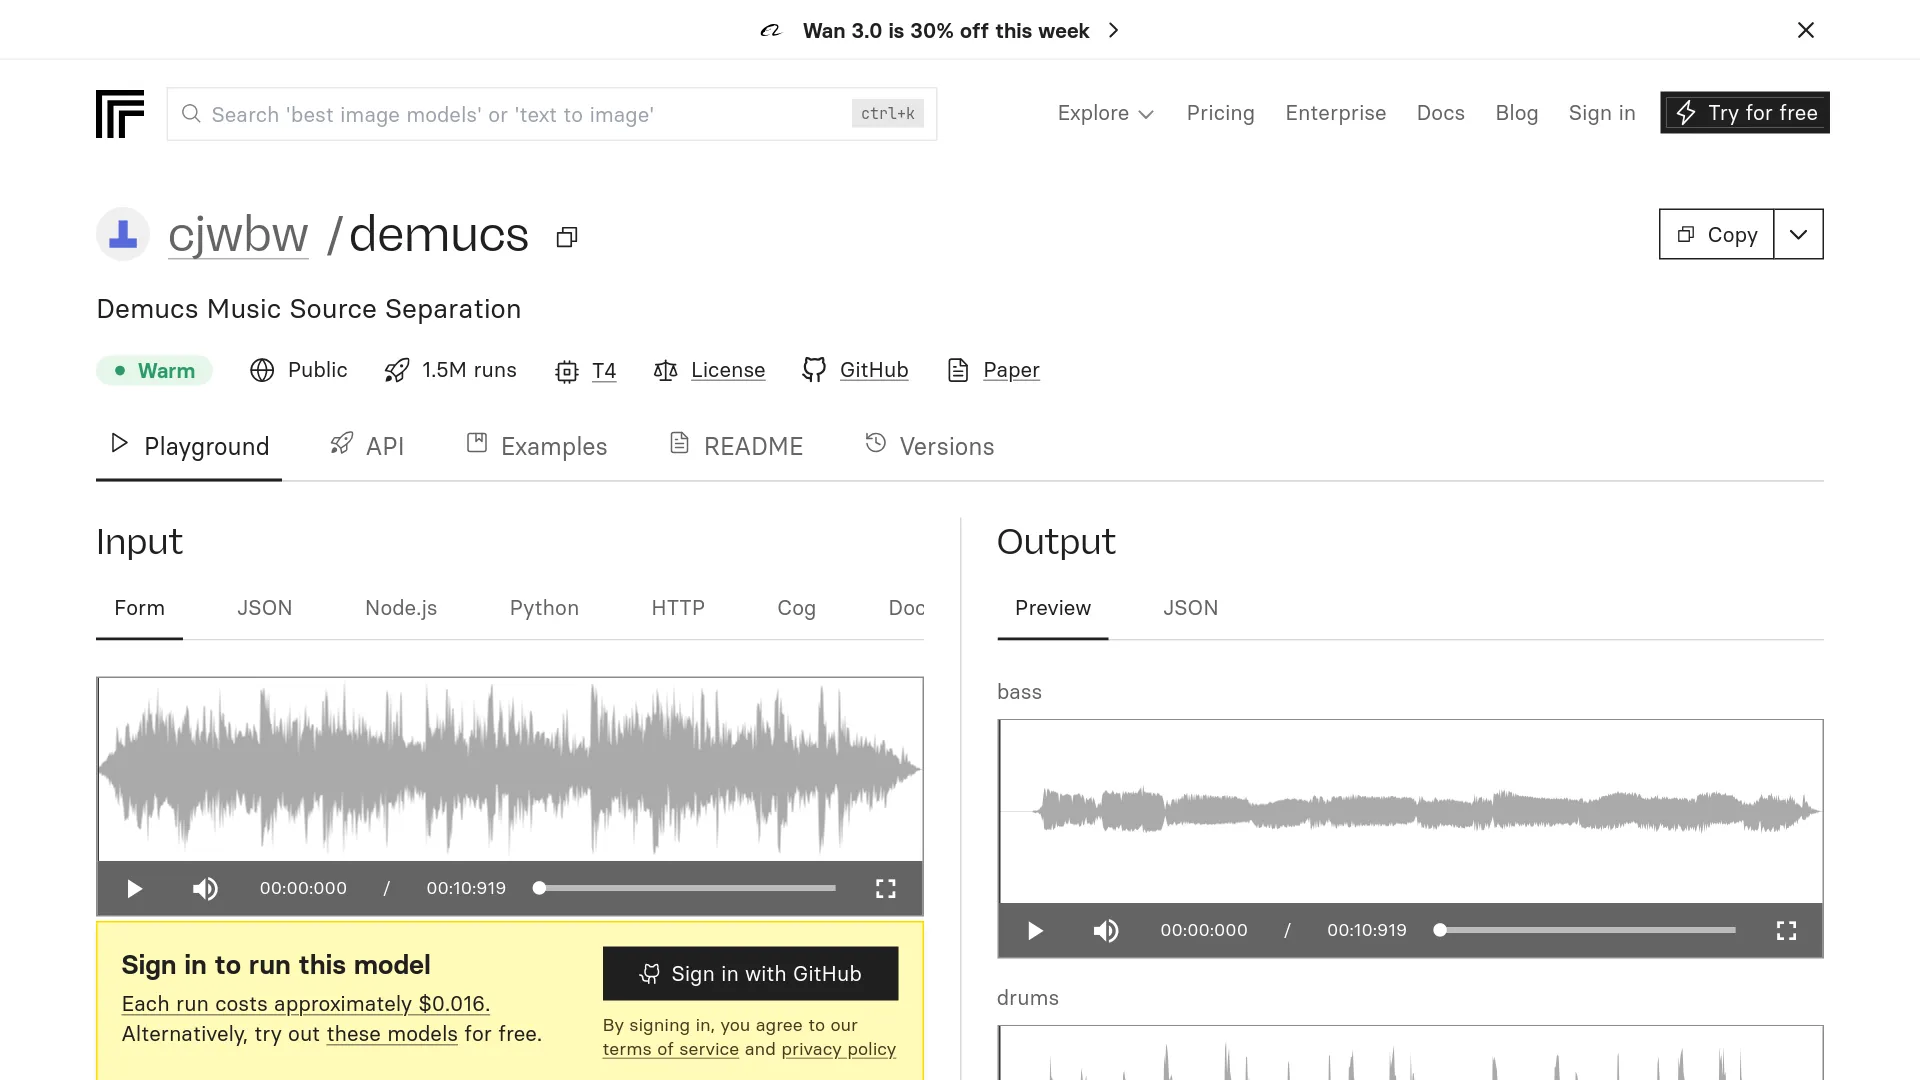
Le schéma d'entrée reprend les principaux réglages de la CLI : model_name (valeur par défaut : htdemucs), stem, shifts (1 par défaut), overlap (0,25), clip_mode (rescale), mp3_bitrate (320), float32 et output_format (mp3).
Une réserve n'est pas forcément visible sur la page : sa dernière version remonte à environ trois ans, et l'endpoint hébergé utilise un instantané figé. Vous appelez donc cette version précise, pas le travail réalisé en juillet 2026 sur le packaging et les dépendances de v4.1.0. Le temps d'exécution varie également davantage que ne le laisse penser le chiffre mis en avant : un exemple public de prédiction sur ce même modèle a pris 6 minutes et 18 secondes.
Combien coûte réellement un morceau de 4 minutes ?
Le chiffre qui détermine vraiment le choix d'un workflow est le coût par morceau. Et il dépend d'un détail de facturation que beaucoup découvrent après avoir souscrit.
LALAL.AI calcule la consommation selon la formule durée du fichier × nombre de types de séparation sélectionnés. Une chanson de 4 minutes séparée en quatre stems consomme donc 16 minutes, et non 4.
La même page tarifaire affiche des recharges ponctuelles (vérifiées le 25 septembre 2026) : 50 $ pour 750 minutes en Fast Queue, 190 $ pour 3 000 minutes et 300 $ pour 5 000 minutes. À ces tarifs, la séparation de quatre stems pour un morceau de 4 minutes coûte entre 0,96 $ et 1,07 $.
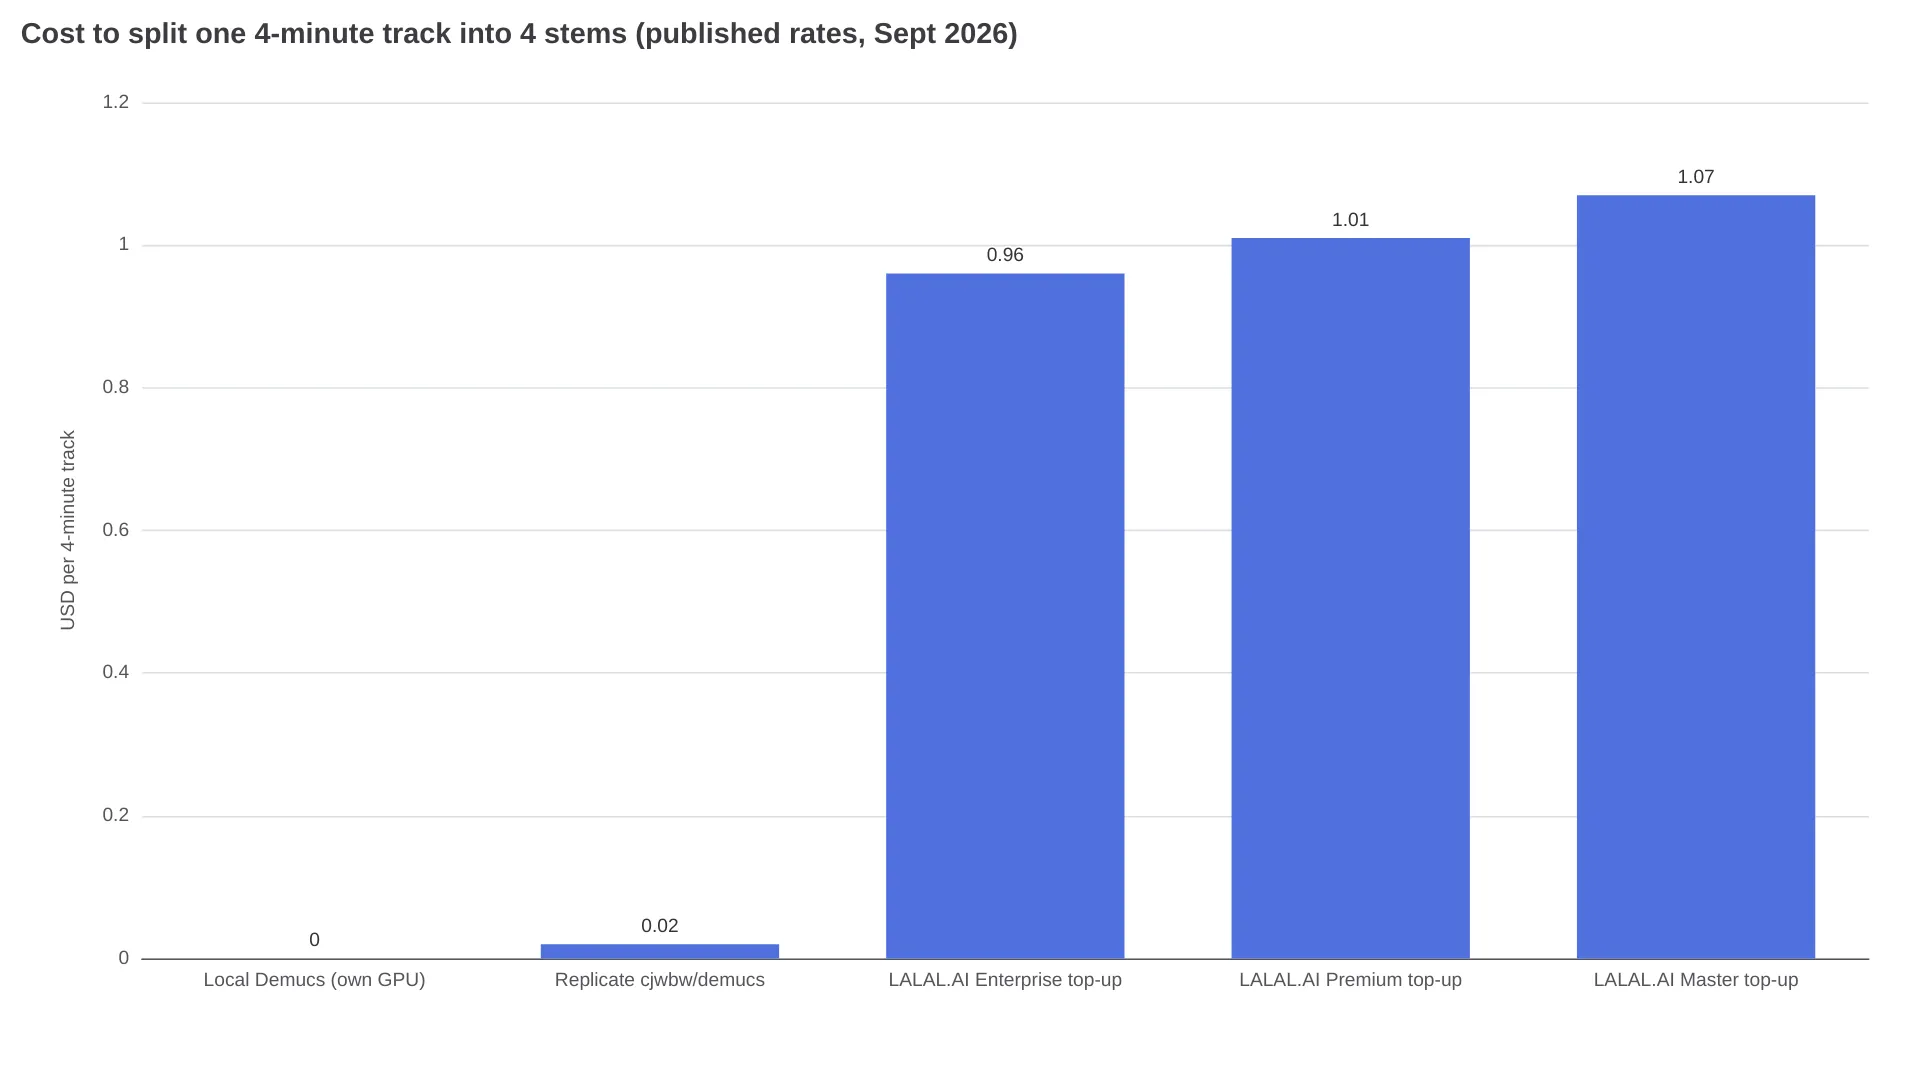
Il faut toutefois lire ce graphique avec une correction en tête : les montants de LALAL.AI correspondent au traitement prioritaire. Les forfaits payants incluent un nombre illimité de minutes en Relaxed Queue, et l'entreprise affirme que les deux files « offrent une qualité de séparation identique ». La Fast Queue sert uniquement à réduire l'attente.
| Forfait | Prix | Inclus | Limites principales |
|---|---|---|---|
| LALAL.AI Starter | Gratuit | 10 minutes en Relaxed Queue | Fichiers limités à 200 Mo |
| LALAL.AI Lite | 6,75 €/mois, 81 € facturés annuellement | Relaxed illimitée, 90 minutes Fast | Pas de traitement par lots, de VST ni d'API ; les minutes ne sont pas reportées |
| LALAL.AI Pro | 13,50 €/mois, 162 € facturés annuellement | Relaxed illimitée, 250 minutes Fast | Seul forfait avec accès API, plugin VST et traitement par lots |
| Moises | Non publié publiquement | Offre gratuite avec un nombre limité d'importations mensuelles | Tarifs accessibles après connexion ; annonce 27 types de stems |
Replicate cjwbw/demucs | Environ 0,020 $/exécution | T4, généralement en moins de 90 s | Version figée depuis environ 3 ans |
| Demucs en local | Gratuit (licence MIT) | Traitement illimité et hors ligne | Temps GPU et effort de configuration à votre charge |
Les 90 minutes de Fast Queue du forfait Lite couvrent environ cinq morceaux de 4 minutes séparés en quatre stems avant de basculer vers la file d'attente standard. Dès que vous traitez plus d'une poignée de morceaux par semaine, la facturation à la minute cesse rapidement d'être avantageuse. C'est précisément le volume à partir duquel l'installation de Demucs rentabilise l'après-midi passé à la configurer.
Quelle solution choisir selon le besoin ?
| Votre situation | Solution recommandée | Pourquoi |
|---|---|---|
| Séparations occasionnelles, pas de GPU ni de terminal | LALAL.AI Starter, puis Lite | Les 10 minutes gratuites permettent de tester la qualité avant de payer |
| Apprendre des morceaux, pratique principalement mobile | Moises | 27 types de stems, plus des outils de tempo et d'accords ; vérifiez le prix après connexion |
| Gros volume, GPU personnel | uvx demucs avec htdemucs | Aucun coût marginal, exécutions illimitées et données conservées sur votre machine |
| Un rendu final important | htdemucs_ft, avec --shifts 2 sur GPU | Pour grappiller le dernier soupçon de qualité au prix de quatre fois plus de calcul |
| Besoin d'une piste de guitare | htdemucs_6s d'abord, puis comparaison avec un modèle de la famille Roformer dans UVR5 | La documentation officielle reconnaît les fuites du modèle à six sources |
| Contenu inédit ou soumis à un accord de confidentialité | Demucs en local uniquement | Aucun envoi, licence MIT et traitement hors ligne |
| Backend applicatif sans budget ops | Replicate cjwbw/demucs | Environ 0,020 $ par exécution, sans infrastructure GPU à gérer |
FAQ sur la séparation des stems avec Demucs
Quel modèle Demucs donne les meilleures voix ?
htdemucs_ft est le meilleur modèle disponible à quatre sources pour les voix, avec un temps de traitement environ quatre fois supérieur à celui de htdemucs. Sur les mixages difficiles, les utilisateurs rapportent de meilleurs résultats avec une chaîne en deux passes : séparation des voix par un modèle de la famille Roformer, puis utilisation de Demucs pour détailler l'instrumental.
Demucs peut-il séparer la guitare et le piano ?
Uniquement avec htdemucs_6s. Le README officiel juge rapidement la qualité de la guitare « correcte » et indique que la source piano « ne fonctionne pas très bien », avec « beaucoup de fuites et d'artefacts ».
Faut-il un GPU NVIDIA pour utiliser Demucs ?
Non. Le CPU fonctionne avec -d cpu, et la documentation estime le traitement à environ 1,5 fois la durée du morceau. Sur Apple Silicon, vous pouvez utiliser -d mps. L'accélération GPU nécessite au moins 3 Go de VRAM, et environ 7 Go avec les options par défaut.
Pourquoi les stems séparés ne se recombinent-ils pas exactement comme le mix original ?
Demucs redimensionne chaque stem pour éviter l'écrêtage provoqué par les artefacts de séparation, ce qui peut modifier les volumes relatifs. Utilisez --clip-mode clamp pour appliquer plutôt un écrêtage strict, ou réduisez le volume du mix d'origine avant le traitement.
Où Demucs enregistre-t-il les stems ?
Dans separated/MODEL_NAME/TRACK_NAME/, sous forme de fichiers WAV stéréo en 44,1 kHz encodés en int16 : drums.wav, bass.wav, other.wav et vocals.wav, sauf si vous demandez une sortie MP3, FLAC, int24 ou float32.
Comment corriger une erreur CUDA out-of-memory ?
Réduisez --segment — 8 est la valeur minimale documentée pour les cartes de 3 Go —, définissez PYTORCH_NO_CUDA_MEMORY_CACHING=1 ou repassez sur -d cpu. Gardez à l'esprit que les modèles Hybrid Transformer limitent la durée de segment à 7,8 secondes : augmenter cette valeur au-delà n'a aucun effet avec eux.