 AIREITER
Para cuidar el tono de marca, nuestra elección es Claude Sonnet 5. Para procesar grandes volúmenes por unos ~$0.10 cada 1.000 tareas, DeepSeek V4 Flash. Y si priorizas rapidez y versatilidad, GPT-5.6 Terra. Esa es nuestra conclusión tras poner a prueba seis modelos el 17 de julio de 2026.
Enviamos exactamente los mismos tres prompts de traducción a la API de cada modelo y contrastamos sus respuestas sin procesar. La sorpresa no fue la calidad: los seis tradujeron correctamente el alemán técnico, y cinco de seis resolvieron un diálogo japonés con sujetos omitidos sin un solo fallo. Lo llamativo fue el coste. Dos modelos supuestamente baratos consumieron tantos tokens de razonamiento por petición que cada traducción acabó costando entre 8 y 10 veces más que con Claude, acercándose peligrosamente a las tarifas por carácter de DeepL.
En 2026, elegir el mejor LLM para traducir no depende tanto de cuál sabe hacerlo —todos pueden— como de cuál encaja con tu tipo de contenido y volumen sin disparar la factura de forma silenciosa.
Qué modelo elegir según el tipo de traducción
| Tu carga de trabajo | Elige | Motivo | Coste medido por 1.000 tareas |
|---|---|---|---|
| Textos de marketing y voz de marca | Claude Sonnet 5 | Suena redactado directamente en el idioma de destino, no traducido | ~$1.06 |
| Grandes volúmenes: catálogos, documentación, subtítulos | DeepSeek V4 Flash | Acertó en las tres pruebas y fue, con diferencia, el más barato | ~$0.10 |
| Cargas mixtas y mínima latencia | GPT-5.6 Terra | Respuestas de 3.0–4.3s y el formato más limpio | ~$0.88 |
| Aplicación estricta de glosarios y flujos con herramientas CAT | DeepL | Incluye bases terminológicas e integraciones que las API de LLM no ofrecen | $27.50 por 1M de caracteres |
Los costes son medias de nuestras tres tareas de prueba —tokens de salida × tarifas oficiales de julio de 2026—, extrapoladas a 1.000 traducciones cortas; la tabla de mediciones completa aparece más abajo. Hay una categoría fuera de esta prueba: para conversación de voz en directo, Google comercializa una variante Gemini 3.5 Live Translate diseñada específicamente para ello, a $3.50/$21 por millón de tokens. La mencionamos, pero no la probamos.
Metodología de la prueba
Tres prompts, seis modelos, mismo texto y una ejecución por modelo el 17 de julio de 2026: texto de marketing inglés→japonés para evaluar el tono; documentación de API inglés→alemán para comprobar terminología; y diálogo informal japonés→inglés para poner a prueba los sujetos omitidos y el contexto, un fallo clásico en pares CJK. CJK agrupa chino, japonés y coreano, tres idiomas en los que se concentran las quejas sobre calidad en traducción automática.
Los modelos fueron GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 y Kimi K2.6. Todas las llamadas pasaron por la misma cuenta de gateway y usaron la configuración predeterminada. Las cifras de latencia son comparables entre sí, aunque variarán según tu región y la carga del proveedor.
Estos son los tres textos de origen, sin cambios, para que puedas repetir la prueba:
EN→JA (marketing): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (técnico): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (diálogo): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Todas las mediciones, por modelo y tarea —latencia en segundos de reloj / tokens de salida del objeto de uso—:
| Modelo | EN→JA | EN→DE | JA→EN | Coste medio por tarea |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
Coste por tarea = tokens de salida × precio oficial de salida del proveedor. La entrada consume entre 60 y 110 tokens por tarea y añade menos de $0.0003 incluso con las tarifas de GPT-5.6 Terra; el gráfico posterior de coste por millón de caracteres sí la incluye. Todos los precios son tarifas oficiales de lista a 17 de julio de 2026, no los precios con descuento facturados a nuestra cuenta.
Una comprobación puntual de tres tareas no basta para clasificar modelos en 100 pares de idiomas, y no pretendemos que lo haga. Pero sí puede revelar diferencias que se mantienen incluso con una muestra pequeña. En este caso, fueron considerables.
Prueba 1: marketing de inglés a japonés
El prompt pedía una versión japonesa natural y cortés de una frase para la página de destino de un SaaS: "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
Claude Sonnet 5 redactó este texto:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
Es el registro que emplearía un copywriter japonés: el uso estilizado de カタチ —katakana para «forma»— y el ritmo marcado por comas son recursos habituales en landing pages, no gramática de manual. GPT-5.6 Terra y DeepSeek V4 Pro quedaron muy cerca, con versiones limpias y profesionales como 「アイデアを、より迅速に形に。」.
DeepSeek V4 Flash fue el más literal de los seis: 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」. Es correcto desde el punto de vista gramatical, pero se percibe como una traducción. En una página de producto convendría una revisión humana; para artículos de soporte o documentación interna, cumple perfectamente.
La diferencia existe, pero es reducida: los seis modelos produjeron japonés utilizable. El trabajo de voz de marca es donde el ~$1 adicional por 1.000 tareas de Claude se amortiza; en ninguna otra prueba tuvo tanta importancia.
Prueba 2: documentación técnica de inglés a alemán
Tradujimos dos frases de documentación de API con límites de tasa, HTTP 429, backoff exponencial y claves de idempotencia. Los seis modelos acertaron con la terminología técnica y emplearon convenciones naturales de documentación alemana: Ratenlimit, Statuscode 429, exponentielles Backoff e Idempotenzschlüssel.
Solo hubo una diferencia visible: GPT-5.6 Terra envolvió Retry-After en formato de código, como se suele componer el nombre de una cabecera en documentación real de API en alemán. Es un buen detalle, no una brecha de calidad.
En prosa documental estándar entre idiomas europeos con abundantes recursos, ninguno de los modelos de la muestra cometió un error; en esta generación, las diferencias de calidad eran demasiado pequeñas para apreciarse. Si eso representa toda tu carga de trabajo, decide por precio y velocidad, no por calidad. Por eso DeepSeek V4 Flash es la respuesta por defecto, a $0.14 de entrada / $0.28 de salida por millón de tokens.
Prueba 3: diálogo de japonés a inglés con sujetos omitidos
En japonés se omite habitualmente el sujeto de las frases, por lo que el traductor debe inferir quién hace qué. Nuestro diálogo también incluía 根回し (nemawashi: construir discretamente consenso antes de una decisión formal), un término cultural sin equivalente directo en inglés.
Cinco de seis modelos resolvieron todo correctamente. Asignaron bien los sujetos y tradujeron nemawashi como "lay the groundwork", "sound him out beforehand" o "give him a heads-up", todas elecciones defendibles. La versión de Claude sonó más a diálogo nativo: "he's probably gonna chew me out".
El único error real de las 18 respuestas vino de DeepSeek V4 Pro. Tradujo 「先に根回ししといたほうがいい」, un consejo sobre lo que conviene hacer a continuación, como "You should've laid the groundwork first", un lamento en pasado por una oportunidad ya perdida. Pocas palabras, significado opuesto. Si un compañero dijera una cosa y tú entendieras la otra, actuarías de forma distinta.
Un error de tiempo verbal en una sola ejecución es un dato, no un veredicto sobre el modelo —comparamos las dos variantes de DeepSeek con más detalle en nuestra comparativa DeepSeek V4 Flash vs Pro—. Aun así, sirve para recordar que fluidez y fidelidad son cualidades diferentes: una frase puede leerse a la perfección y expresar algo equivocado. Para contratos, contenido médico o cualquier caso en que interpretar mal un tiempo verbal cueste dinero, reserva revisión humana independientemente del modelo elegido.
La trampa del consumo de tokens: por qué la tabla de precios engaña
Este es el resultado que cambia la decisión de compra. Por millón de tokens de salida, GLM-5.2 cuesta $4.40 y Kimi K2.6 $4.00, menos de la mitad de los $10 de Claude Sonnet 5. Sin embargo, por cada traducción realizada, fueron entre 8 y 10 veces más caros.
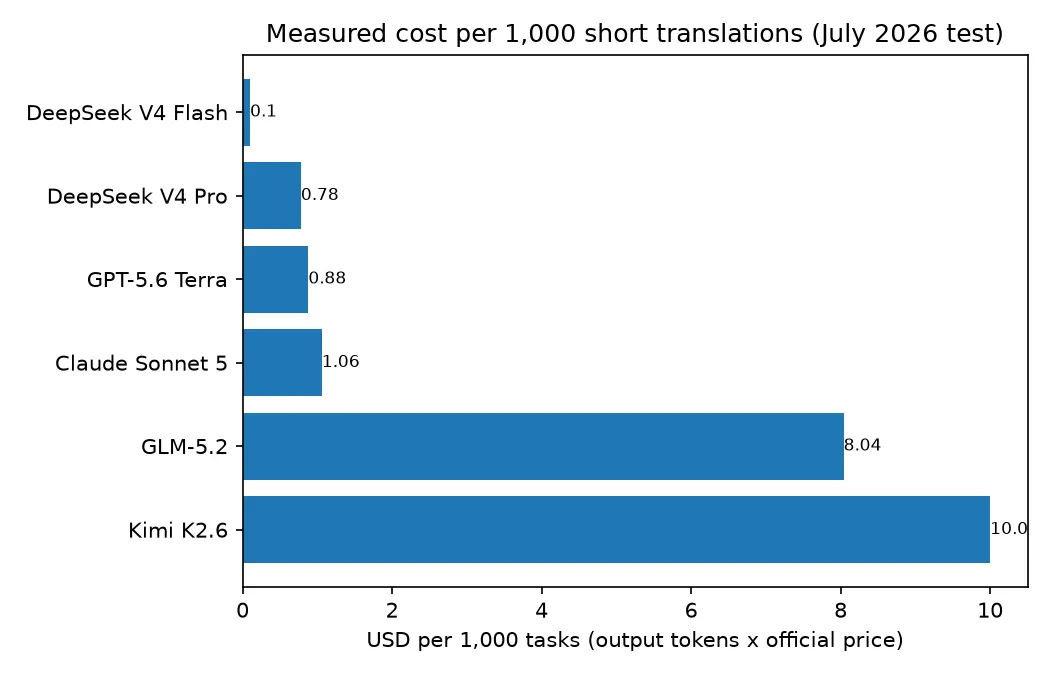
El motivo es que ambos modelos ejecutan una cadena de razonamiento visible antes de responder, y esos tokens de razonamiento se cobran como salida. Para traducir una frase de marketing, Kimi K2.6 emitió 2,849 tokens de salida y GLM-5.2 emitió 1,906, pese a que las traducciones tenían entre 40 y 60 tokens. Claude Sonnet 5 usó 60 tokens en la misma tarea; GPT-5.6 Terra, 46.
La latencia siguió el mismo patrón. GPT-5.6 Terra y Claude Sonnet 5 respondieron en 3–4 segundos en las tres tareas. DeepSeek V4 Flash necesitó 4–5s, DeepSeek V4 Pro entre 16 y 20s, mientras que GLM-5.2 y Kimi K2.6 tardaron entre 20 y 48 segundos por petición.
De aquí salen dos reglas prácticas. Primera: en tareas cortas y de gran volumen como la traducción, compara modelos por su coste medido por tarea, no por el precio de lista; lanza 20 peticiones y revisa el campo de uso. Segunda: desactiva o reduce el razonamiento para traducir. DeepSeek separa endpoints con y sin pensamiento, y GLM y Kimi exponen parámetros de pensamiento en el cuerpo de la petición. En nuestras tres tareas, la cadena de razonamiento no aportó ninguna mejora detectable en la calidad de salida.
Cuánto cuesta traducir a gran escala
Al escalar el consumo de tokens medido a un millón de caracteres de texto fuente en inglés —aproximadamente 250,000 tokens—, la diferencia se vuelve contundente:
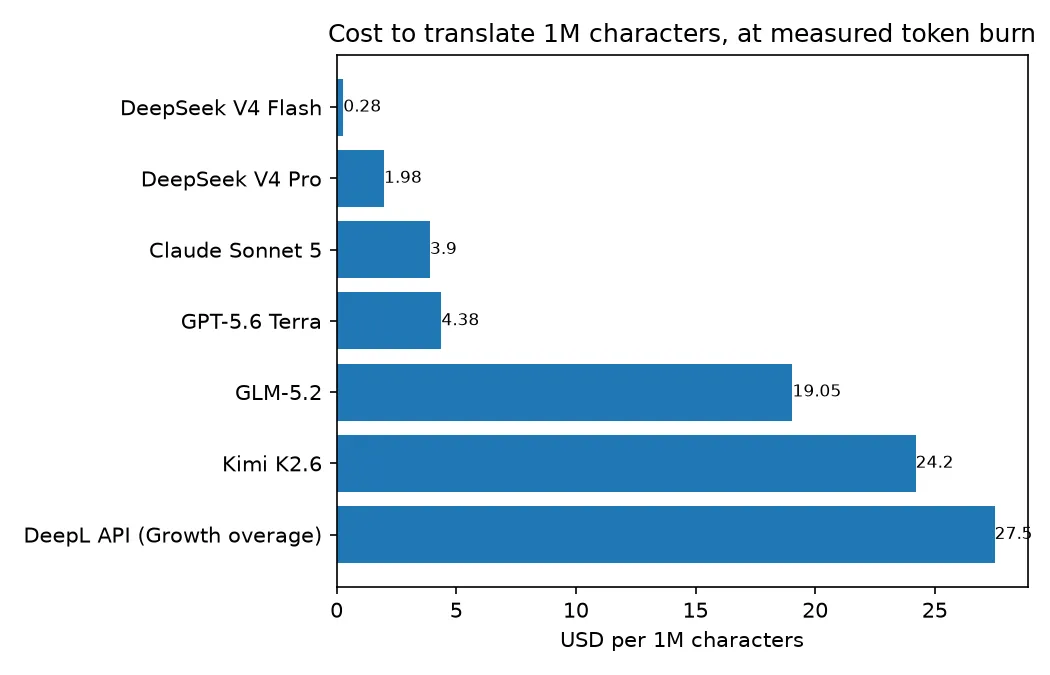
DeepSeek V4 Flash traduce el equivalente a una novela completa por unos $0.28. El mismo volumen mediante la API de DeepL cuesta $27.50 con las tarifas de exceso del plan Growth: una diferencia de 98x. Esto coincide en dirección con un análisis muy compartido en r/LocalLLaMA titulado "LLMs are 800x cheaper for translation than DeepL", cuyo multiplicador era mayor porque empleaba modelos autoalojados más pequeños.
Fíjate en la parte superior del gráfico: con el consumo de tokens medido, los modelos de pesos abiertos con razonamiento intensivo casi eliminan la distancia respecto a DeepL. El precio unitario sin medir tokens no es una estimación de costes.
Tres datos de precios que conviene conocer antes de comprometerse, todos verificados el 17 de julio de 2026:
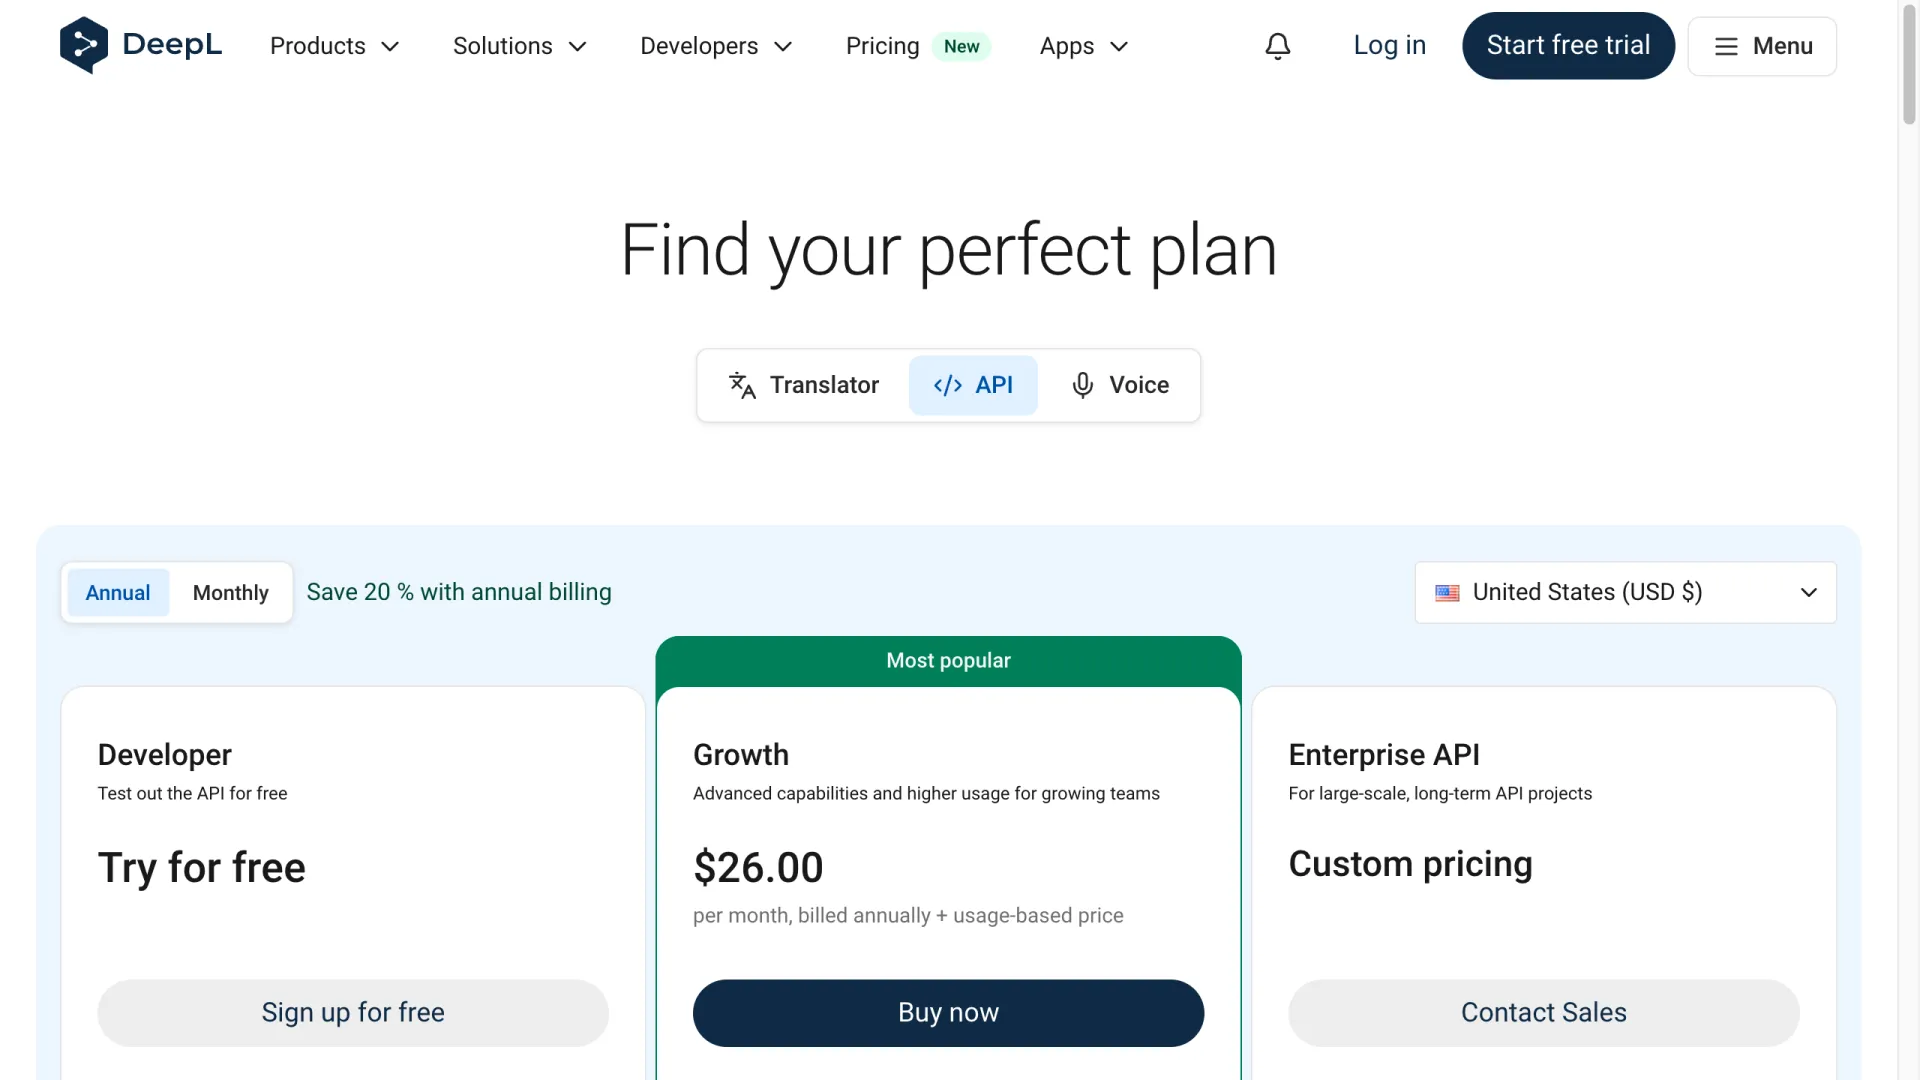
- Ha cambiado el nivel gratuito de DeepL. El plan API Developer ahora concede un crédito único de 1,000,000 de caracteres, no la cuota mensual de 500,000 caracteres que todavía aparece en documentación antigua y respuestas de foros. Growth cuesta $26/mes, facturado anualmente, e incluye 12M de caracteres/año; después, cada millón adicional cuesta $27.50.
- DeepSeek factura una fracción de lo que cobran los demás. V4 Flash cuesta $0.14 de entrada / $0.28 de salida por millón de tokens, y la entrada con acierto de caché baja a $0.0028. El antiguo nombre de modelo deepseek-chat se retira el 24 de julio de 2026.
- Claude Sonnet 5 tiene precio de introducción. $2/$10 por millón de tokens hasta el 31 de agosto de 2026; después, $3/$15. Su tokenizador más reciente también genera aproximadamente un 30% más de tokens para el mismo texto, algo que nuestros cálculos de coste ya contemplan. Si planificas más allá de septiembre, presupuesta ambos cambios.
- Las API Batch reducen la factura a la mitad. OpenAI, Anthropic y Google ofrecen descuentos de ~50% para procesamiento por lotes asíncrono. Las cargas de traducción normalmente no son sensibles a la latencia, así que es dinero gratis: el precio batch reduce GPT-5.6 Terra a ~$2.19 y Claude Sonnet 5 a ~$1.95 por millón de caracteres.
Cuándo siguen ganando DeepL o Google Translate
La economía por carácter favorece a los LLM, pero hay tres requisitos que todavía inclinan la balanza al otro lado:
- Terminología obligatoria. DeepL incluye glosarios y bases terminológicas que garantizan que un término se traduzca siempre igual. Con un LLM tendrías que indicarlo en el prompt y verificar el resultado: es probabilístico, no obligatorio.
- Integración con herramientas CAT y pipelines. Si tu memoria de traducción reside en una herramienta CAT —traducción asistida por ordenador—, los conectores de DeepL se integran directamente.
- Latencia inferior a un segundo a escala. Los motores tradicionales de traducción automática neuronal suelen responder más rápido que los LLM generalistas; para traducción integrada en una interfaz, importa.
Para voz en directo, ni la NMT clásica ni un LLM conversacional tienen el formato adecuado. Google pone precio a una variante específica de Gemini 3.5 Live Translate en $3.50/$21 por millón de tokens, con tarifas de audio por minuto, que analizamos en nuestro desglose de Gemini 3.5 Live Translate.
En idiomas poco frecuentes y con pocos recursos, la cobertura importa más que las clasificaciones de calidad: antes de comparar nada, comprueba que tu par de idiomas tenga soporte. DeepL admite alrededor de 30 idiomas; los LLM grandes manejan más de cien, aunque la calidad se degrada en los extremos de esa lista.
Alternativas open source y locales
Tanto GLM-5.2 como la serie K de Kimi publican pesos abiertos, así que el problema de consumo de tokens anterior se puede resolver mediante autoalojamiento: controlas los ajustes de muestreo y puedes suprimir por completo las cadenas de razonamiento.
Para traducción local con una sola GPU, Qwen3-30B-A3B es la recomendación que más se repite en los hilos de r/LocalLLaMA sobre modelos de traducción local para traducir idiomas europeos al inglés; a medida que el par de idiomas es más exótico, se recomiendan modelos más grandes. El motivo suele ser privacidad —contratos, productos aún no anunciados— o coste marginal cero, más que calidad; en esos mismos hilos, los modelos frontier alojados siguen describiéndose como mejores traductores.
Conviene seguir de cerca Kimi K3, que esta semana se lanzó con pesos abiertos a $3/$15 por millón de tokens alojado. Probamos K2.6 porque el acceso a la API de K3 todavía se estaba desplegando; si K3 hereda el apetito de tokens de la serie K, se aplicará la misma advertencia sobre el coste medido.
Cómo repetir la comparativa por tu cuenta
Todo lo anterior se puede reproducir con unas 20 llamadas a API: elige dos frases de tu propio contenido, envíalas a cada modelo candidato y consulta el objeto de uso de cada respuesta para conocer los recuentos reales de tokens. El coste total de nuestras 18 peticiones de prueba fue inferior a $0.15.
La parte molesta es gestionar seis claves de API de cinco proveedores. Nosotros ejecutamos los seis modelos mediante una sola cuenta de AIReiter, que revende acceso por API a modelos principales —claves de la familia Claude a aproximadamente una quinta parte de la tarifa de lista— detrás de un único endpoint compatible con Anthropic: una clave y el mismo formato de conexión para todos los modelos anteriores.
Si tu volumen de traducción es relevante, dedicar una hora a pruebas puntuales con tu propio contenido vale más que cualquier clasificación, incluida esta. Los modelos están lo bastante igualados en calidad como para que tu par de idiomas, requisitos de tono y mediciones de tokens sean quienes decidan.
Preguntas frecuentes
¿ChatGPT o Gemini: cuál traduce mejor?
En nuestras pruebas, GPT-5.6 Terra fue rápido, preciso y respetó bien el formato en las tres tareas. No enfrentamos Gemini directamente —no estaba disponible en nuestro gateway—, pero sus precios publicados son competitivos: $1.50/$9 por millón de tokens para 3.5 Flash. Además, es el único proveedor con un modelo dedicado a traducción de voz en directo.
¿Cuál es ahora mismo el traductor de IA más preciso?
En pares de idiomas con muchos recursos, las diferencias de precisión entre modelos frontier son pequeñas; los seis modelos probados tradujeron alemán técnico sin errores. Las diferencias se concentran en el tono —Claude lideró en el texto de marketing japonés— y en casos límite como sujetos omitidos y tiempos verbales, donde DeepSeek V4 Pro cometió el único error real de nuestra muestra.
¿Cuál es el mejor LLM open source para traducción?
GLM-5.2 y Kimi K2.6 publican sus pesos y tradujeron correctamente en nuestras pruebas; con autoalojamiento puedes desactivar las cadenas de razonamiento que encarecen sus API alojadas por tarea. Para hardware de consumo, Qwen3-30B-A3B es la recomendación habitual de la comunidad.
¿Puede un LLM sustituir a un traductor humano?
Para documentación interna, contenido de soporte y grandes volúmenes de texto de producto: en gran medida sí, a un 1–16% del coste por carácter de DeepL según el modelo —DeepSeek V4 Flash ~1%, Claude Sonnet 5 ~14%, GPT-5.6 Terra ~16%—. Para contratos, textos médicos y campañas de marca, el error de tiempo verbal de la Prueba 3 es la advertencia. Una salida fluida todavía puede invertir el sentido, así que mantén revisión humana cuando una mala interpretación salga cara.
¿Sigue mereciendo la pena DeepL en 2026?
Sí, en tres casos: glosarios obligatorios, integración con herramientas CAT y latencia inferior a un segundo. Fuera de ellos, es difícil defender los cálculos por carácter; además, el nivel gratuito es ahora un crédito único de 1M de caracteres, no una cuota mensual.