 AIREITER
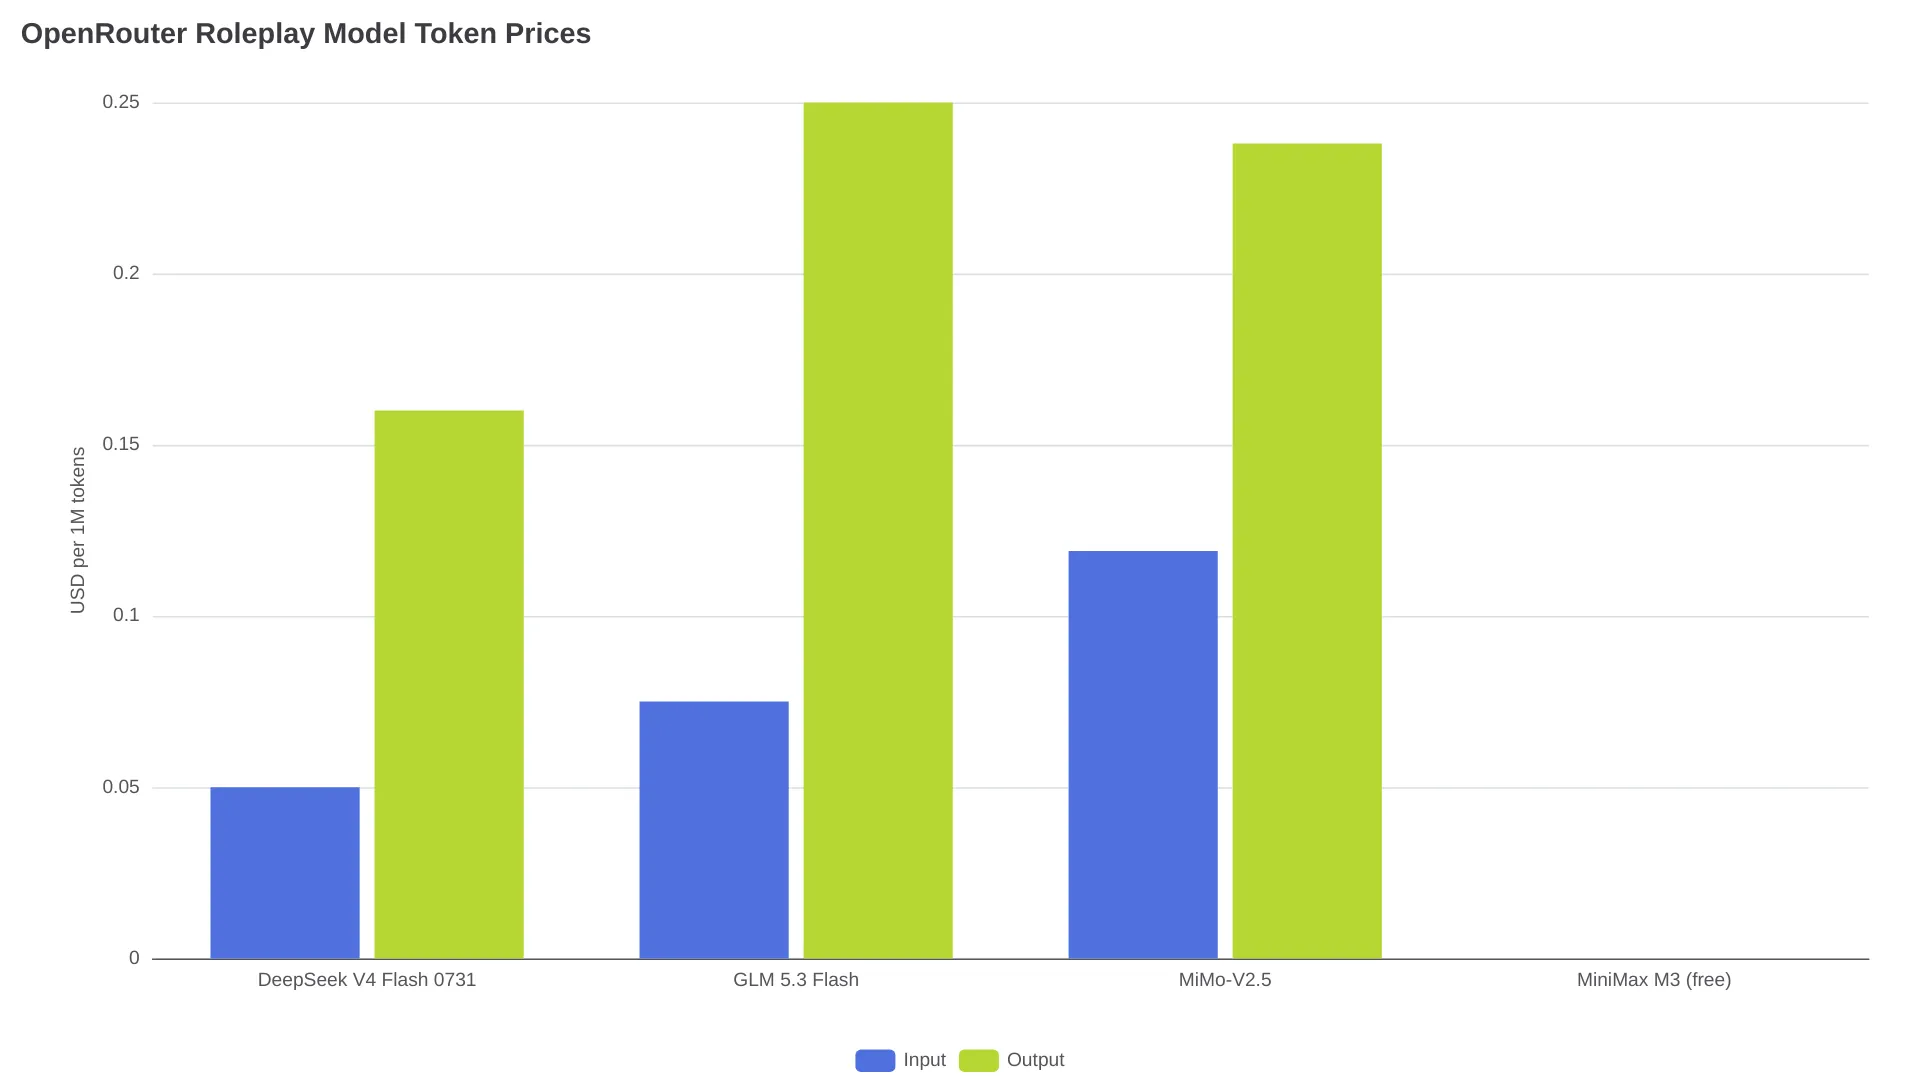
Für Roleplay über OpenRouter zählt nicht nur die Textqualität: Entscheidend sind auch ein konsistenter Stil, ausreichend Kontext und kalkulierbare Kosten. Im Snapshot vom 2. September 2026 ist DeepSeek V4 Flash 0731 der erste kosten- und kontextstarke Paid-Kandidat, den du testen solltest. OpenRouter führt das Modell mit einem Kontext in der 1M-Klasse sowie $0.05 Input- und $0.16 Output-Kosten pro Million Tokens. Kostenlose Routen eignen sich gut zum Ausprobieren, ihre Verfügbarkeit und Kapazität können sich jedoch ändern.
Dieser Leitfaden betrachtet technische Eigenschaften und Kosten für nicht-explizites, fiktives Roleplay. Er erklärt weder ein universell bestes „uncensored“-Modell noch veröffentlicht er Ablehnungsquoten ohne einen kontrollierten, direkt vergleichbaren Testlauf.
Welches OpenRouter-Modell passt 2026 zu deinem Roleplay?
Lege ein kostenpflichtiges Modell fest und halte eine aktuell verfügbare kostenlose Alternative bereit. Die Nutzungsrangliste ist dabei ein Signal für eine Vorauswahl – keine Qualitätswertung.
| Einsatzbereich | Erstes Modell zum Prüfen | Warum es passt | Wichtigste Einschränkung |
|---|---|---|---|
| Paid-Basis für Kosten und Kontext | DeepSeek V4 Flash 0731 | Kontext in der 1M-Klasse, $0.05/$0.16 pro 1M Tokens und aktuelle Roleplay-Nutzung auf OpenRouter | Nutzungsdaten ersetzen keinen kontrollierten RP-Test |
| Kostenloser Einstieg | MiniMax M3 (free) | In OpenRouters aktueller Free-Sammlung gelistet, mit ungefähr 1M Kontext | Freie Kapazität, Limits und Verfügbarkeit können sich ändern |
| Günstiger Paid-Vergleich | GLM 5.3 Flash | Kontext in der 1M-Klasse, 22 gelistete Provider und zeitweise $0.075/$0.25 | Der Rabatt ist befristet; das Modell ist für agentische Aufgaben positioniert |
| Vergleich im mittleren Preisbereich | MiMo-V2.5 in OpenRouters Roleplay-Sammlung | $0.119/$0.238 pro 1M Tokens und 1.05M Kontext im aktuellen Listing | Die zitierte Seite liefert Katalog- und Nutzungsdaten, keinen kontrollierten RP-Score |
| Automatischer kostenloser Fallback | openrouter/free | Wählt ohne festgelegten Slug eine verfügbare kostenlose Route aus | Das zugrunde liegende Modell kann sich zwischen Anfragen ändern |
Nutze DeepSeek zunächst als kostenpflichtige Basis, prüfe vor der Nutzung von MiniMax M3 den aktuellen kostenlosen Endpunkt und nimm GLM 5.3 Flash als zweiten Paid-Kontrollwert hinzu. Diese Vorauswahl stützt sich auf aktuelle Nutzung, Preise, Kontext und Routing-Daten – nicht auf ein allgemeingültiges Prosa-Ranking.
Was die OpenRouter-Roleplay-Rangliste tatsächlich aussagt
OpenRouters Roleplay and Creative Writing collection ist eine dynamische Entdeckungsseite auf Basis der Nutzung. Im Stand vom 2. September 2026 liegt DeepSeek V4 Flash dort auf Platz eins.
Die Rangfolge misst Nutzung, nicht die Einhaltung einer Character Card, korrekte Namen, Prosaqualität oder Ablehnungsraten. Ein häufig verwendetes Modell kann schlicht günstig, schnell, breit verfügbar oder einfach zu routen sein.
Erstelle mit der Sammlung eine Shortlist und lasse anschließend dieselbe sichere Card samt Eröffnungsszene über zwei fest angeheftete Modell-IDs laufen. Damit beantwortest du die konkretere Frage: Welche Route funktioniert besser mit deinem Prompt, deinen Einstellungen und deinem Budget?
Aktuelle Shortlist: Kontext, Preis und Verfügbarkeit
Die folgenden Angaben stammen von OpenRouters Roleplay-, Free-Model- und Modellseiten, geprüft am 2. September 2026. Preise und Free-Status sind Momentaufnahmen des laufenden Betriebs.
| Modell-ID | Angezeigter Kontext | Input- / Output-Preis pro 1M | Kostenlose Route gesehen? | Was die Daten belegen |
|---|---|---|---|---|
deepseek/deepseek-v4-flash-0731 | 1,310,720 | $0.05 / $0.16 | Live-Katalog prüfen | Niedriger gelisteter Paid-Preis, 30 Provider und automatisches Failover |
minimax/minimax-m3 | 1,048,576 | $0.23 / $0.96 bezahlt | Ja, als MiniMax M3 (free) gelistet | Großer Kontext und Tests ohne Kosten, solange der Free-Endpunkt verfügbar ist |
z-ai/glm-5.3-flash | 1,310,720 | $0.075 / $0.25 Aktionspreis | Live-Katalog prüfen | 22 Provider und 99.89% Verfügbarkeit über drei Tage im Snapshot |
xiaomi/mimo-v2.5 | 1.05M | $0.119 / $0.238 | Auf der zitierten Seite nicht belegt | Nutzungssignal aus der Roleplay-Sammlung und moderate Paid-Preise |
openrouter/free | Router-Seite: 200K | $0 | Router, kein festes Modell | Praktisch für Experimente; die zufällige Auswahl verringert die Reproduzierbarkeit |
DeepSeek V4 Flash 0731: Basis für Kosten und Kontext
DeepSeek V4 Flash 0731 bietet 1,310,720 Tokens Kontext, bis zu 393,216 Completion-Tokens und gelistete Preise von $0.05 für Input sowie $0.16 für Output je Million Tokens. Auf der OpenRouter-Seite stehen 30 Provider sowie die Routing-Modi Balanced, Nitro und Exacto.
Bevor du eine lange Kampagne beginnst, solltest du denselben Card-Test durchführen: Die Modellseite veröffentlicht keinen gemessenen Wert zur Charakterkonsistenz.
MiniMax M3: Kandidat für kostenlose Tests
OpenRouters Free-Model-Sammlung führt MiniMax M3 mit $0 für Input und Output sowie einer Kontextanzeige von 1.05M. Die kostenpflichtige MiniMax-M3-Seite nennt 1,048,576 Kontext-Tokens, Text-/Bild-/Video-Input, Text-Output und Paid-Preise von $0.23 Input sowie $0.96 Output pro Million Tokens.
Die Free-Variant-Dokumentation von OpenRouter weist darauf hin, dass eine :free-Route andere Verfügbarkeit und Rate Limits haben kann als das Paid-Modell. Wenn reproduzierbare Ergebnisse wichtig sind, wähle den exakt im Live-Katalog angezeigten Free-Slug. openrouter/free eignet sich nur dann, wenn die automatische Auswahl in Ordnung ist.
GLM 5.3 Flash: Option mit breiter Provider-Auswahl
GLM 5.3 Flash besitzt ein Kontextfenster von 1,310,720 Tokens und ist dank eines 50%-Aktionsrabatts über Z.ai bis zum 9. September 2026 um 16:00 UTC mit $0.075 Input und $0.25 Output pro Million Tokens gelistet. Die OpenRouter-Seite nennt 22 Provider und 99.89% Verfügbarkeit über drei Tage.
Die Modellseite positioniert GLM 5.3 Flash für effizientes Coding und langfristige Agent-Aufgaben, nicht speziell für Roleplay. Prüfe die RP-Eignung mit demselben Prompt, statt sie aus der Produktbeschreibung abzuleiten.
MiMo-V2.5 und weitere Fallbacks
MiMo-V2.5 erscheint in OpenRouters Roleplay-Sammlung mit 1.05M Kontext sowie Preisen von $0.119 für Input und $0.238 für Output. Das Modell ist ein brauchbarer Kontrollwert im mittleren Preisbereich, doch die zitierte Seite veröffentlicht kein kontrolliertes Roleplay-Ergebnis. Speichere vor einer Sitzung einen zweiten exakten Slug: Ein vorab gewählter Fallback ist berechenbarer als ein zufälliger Modellwechsel.
Kostentest für 1.000 Runden: Kontextverwaltung bestimmt die Rechnung
Eine Roleplay-Runde besteht aus einer Nutzernachricht und einer Assistant-Antwort. OpenRouter rechnet Tokens ab; einen pauschalen Preis für 1.000 Runden gibt es daher nicht. Maßgeblich ist vor allem, wie viel Verlauf das Frontend bei jeder Anfrage erneut mitsendet.
Dieses Rechenbeispiel geht von 1,000 Runden, 200 neuen Nutzer-Tokens pro Runde, 500 Assistant-Output-Tokens pro Runde und einem festen Character-/System-Prompt mit 2,000 Tokens aus. Beim vollständigen Verlauf senden die 1,000 Anfragen die wachsende Unterhaltung immer wieder mit. So entstehen insgesamt etwa 351.85M Input-Tokens und 0.5M Output-Tokens.
| Modell | Szenario mit kompaktem Verlauf: 4M Input + 0.5M Output | Szenario mit vollständigem Verlauf: 351.85M Input + 0.5M Output |
|---|---|---|
| DeepSeek V4 Flash 0731 ($0.05/$0.16) | $0.28 | $17.67 |
| GLM 5.3 Flash ($0.075/$0.25) | $0.43 | $26.51 |
| MiMo-V2.5 ($0.119/$0.238) | $0.60 | $41.99 |
| MiniMax M3 bezahlt ($0.23/$0.96) | $1.40 | $81.41 |
| MiniMax M3 free | $0.00, vorbehaltlich der Limits | $0.00, vorbehaltlich der Limits |
Die Spalte für den kompakten Verlauf rechnet mit durchschnittlich 4,000 Input-Tokens je Anfrage. Bei vollständigem Verlauf werden dieselben frühen Nachrichten wiederholt übertragen. Ein großes Kontextfenster macht eine Kampagne mit 1.000 Runden deshalb nicht automatisch günstig.
Unter diesen Annahmen umfasst der letzte Prompt bei vollständigem Verlauf ungefähr 701,500 Input-Tokens, noch ohne zusätzliches Formatting und Metadaten. Ein Kontextfenster von 1M kann dieses Beispiel aufnehmen, längere Antworten, größere Cards, Lorebooks oder versteckte Templates können es aber überschreiten. Kontextkapazität ist kein automatisches Gedächtnis.
Prompt Caching kann die Kosten wiederholter Inputs senken, sofern Provider und Anfragepfad es unterstützen. Prüfe die Activity-Seite von OpenRouter, statt davon auszugehen, dass jedes Frontend gleich vom Cache profitiert. OpenRouters Preisleitfaden erläutert das allgemeine Modell der Tokenabrechnung.
Was ein sicherer Konsistenztest leisten kann – und was nicht
Für einen nicht-expliziten Vergleich genügen ein erwachsener fiktiver Charakter, eine harmlose Szene und bei jedem Modell identische Einstellungen:
- Hinterlege drei dauerhafte Fakten in der Character Card, etwa Beruf, Ort und ein nicht sensibles Ziel.
- Lege eine Erzählung in der dritten Person oder eine eindeutig definierte Perspektive fest.
- Führe 20 Turns mit demselben Einstieg und einem Output-Limit von 400–600 Tokens durch.
- Bitte den Charakter in Turn 5, 10 und 20, auf eine frühere Information zu reagieren, ohne sie erneut zu nennen.
- Notiere Namenswechsel, widersprüchliche Fakten, unerwünschte Perspektivwechsel, Wiederholungen, leere Antworten und Ablehnungen.
Damit vergleichst du deinen Prompt und die Route, nicht die universelle Qualität eines Modells. Eine Ablehnung kann vom Modell, Provider, Frontend-Classifier oder Prompt stammen; deshalb nennt dieser Leitfaden keine Ablehnungsrate. Für die Geschwindigkeit solltest du First-Token-Latenz und generierte Tokens pro Sekunde in drei identischen Durchläufen erfassen und dabei Modell sowie Provider-Route notieren.
Wie lange reicht das kostenlose OpenRouter-Kontingent für Roleplay?
Der offizielle SillyTavern-Leitfaden von OpenRouter nennt für Accounts mit weniger als $10 an gekauften Credits 50 Anfragen an Free-Modelle pro Tag. Ab mindestens $10 gekauften Credits steigt das Kontingent laut Leitfaden auf 1,000 Anfragen pro Tag. Zusätzlich gilt ein Limit von 20 Anfragen pro Minute.
Wenn eine Assistant-Generierung einer Runde entspricht, sind das ungefähr 50 beziehungsweise 1,000 erste Runden pro Tag. Regenerierungen, Wiederholungsversuche, fehlgeschlagene Requests und Abläufe mit mehreren Nachrichten verbrauchen ebenfalls Anfragen. Die Zahl tatsächlich abgeschlossener Szenen kann also niedriger ausfallen.
Die beiden kostenlosen Optionen arbeiten unterschiedlich:
model-name:freelegt die kostenlose Variante eines bestimmten Modells fest. Das ist besser reproduzierbar, doch der Endpunkt kann verschwinden oder rate-limitiert werden.openrouter/freewählt automatisch ein geeignetes Free-Modell. Laut der Dokumentation zum Free Models Router erfolgt die Auswahl nach dem Capability-Filtering zufällig; die Antwort nennt das zugrunde liegende Modell. Das ist bequem für Tests, die Charakterstimme kann sich aber zwischen Anfragen ändern.
Prüfe die aktuelle OpenRouter-Free-Model-Sammlung, bevor du ein Frontend einrichtest. Baue keine lange Kampagne auf einem Free-Slug aus einem älteren Guide auf.
SillyTavern für eine stabile OpenRouter-Sitzung einrichten
Der offizielle OpenRouter-Workflow verwendet Chat Completion statt Text Completion. Eine erfolgreich verbundene API-Key-Verbindung garantiert noch nicht, dass das ausgewählte Modell, die Provider-Route oder die Kontextgröße tatsächlich eine Antwort erzeugen kann.
- Öffne in SillyTavern das Panel API Connections.
- Wähle API Type: Chat Completion.
- Wähle Source: OpenRouter.
- Autorisiere dich über den verfügbaren Ablauf oder füge einen in den Key-Einstellungen von OpenRouter erstellten API-Key ein.
- Klicke auf Connect, wähle den exakten Modell-Slug und sende eine Test Message.
- Speichere ein Verbindungsprofil für das Paid-Modell und ein weiteres für den kostenlosen Fallback.
Beginne mit einer Kontextgröße, die der exakte Endpunkt unterstützt, aktiviertem Streaming und einem moderaten Output-Limit. Halte die Character Card kompakt und fasse ältere Turns zusammen, bevor der Prompt an das Endpunkt-Limit stößt. Sampling-Einstellungen solltest du separat testen, weil sie Länge und Tempo der Ausgabe beeinflussen können.
Ist das Dropdown leer, verbinde dich erneut und aktualisiere die Modellliste. Funktioniert die Verbindung, aber keine Generierung, prüfe Slug, Credits, Provider-Verfügbarkeit und Kontextüberlauf, bevor du den Prompt umschreibst.
JanitorAI einrichten und typische Fehler beheben
Die API von OpenRouter ist OpenAI-kompatibel. Der im OpenRouter Quickstart dokumentierte Standard-Endpunkt für Chat Completions lautet:
https://openrouter.ai/api/v1/chat/completionsDieser Artikel basiert nicht auf einem aktuellen Screenshot der JanitorAI-Oberfläche. Nutze die folgenden Schritte daher als allgemeines Muster für OpenAI-kompatible Integrationen und prüfe die Felder in deiner aktuellen JanitorAI-Ansicht:
- Erstelle einen OpenRouter-API-Key und behandle ihn vertraulich.
- Wähle, falls verfügbar, die aktuelle OpenAI-kompatible oder Custom-API-Option.
- Trage die vollständige Chat-Completions-URL ein, wenn das Feld einen Completion-Endpunkt erwartet.
- Füge die exakte aktuelle OpenRouter-Modell-ID ein, bei einer kostenlosen Variante einschließlich
:free. - Speichere die Einstellungen, aktualisiere JanitorAI und teste mit einer kurzen nicht-expliziten Nachricht.
| Symptom | Wahrscheinliche Ursache | Erste Maßnahme |
|---|---|---|
| 401 oder ungültiger Token | Der Key ist falsch, abgelaufen oder mit zusätzlichen Zeichen eingefügt | Key neu generieren und erneut einfügen; keinen öffentlich geteilten Key verwenden |
| 404 oder kein Endpunkt | Modell-Slug oder URL ist veraltet | Aktuellen Slug bei OpenRouter kopieren und den vollständigen Endpunkt prüfen |
| 429 | Tages-/Minutenlimit des Free-Modells oder Provider-Überlastung | Warten, Wiederholungen reduzieren, zum festgelegten Fallback wechseln oder eine Paid-Route nutzen |
| Leere Antwort | Nicht unterstützte Route, Output-Limit oder Kontextüberlauf | Kontext- und Output-Einstellungen senken und das Modell direkt in OpenRouter testen |
| Der Bot vergisst den Anfang | Das Frontend hat älteren Verlauf abgeschnitten | Prompt verkleinern, ältere Turns zusammenfassen und den Kontext an den Endpunkt anpassen |
| Ablehnung oder plötzlicher Stilwechsel | Provider-Policy oder eine andere Fallback-Route | Tatsächliches Modell und Provider prüfen und einen neutralen Test-Prompt verwenden; „uncensored“ ist keine Garantie |
Datenschutz, Provider-Routing und Compliance
Laut der FAQ von OpenRouter werden grundlegende Request-Metadaten wie Zeitstempel, Modell und Tokenanzahl erfasst. Prompts und Completions werden standardmäßig nicht gespeichert, sofern Nutzer nicht ausdrücklich zustimmen. Vorgeschaltete Provider können eigene Richtlinien zu Aufbewahrung und Training haben.
Zero Data Retention kann das Routing auf Provider beschränken, die der gewählten Aufbewahrungsrichtlinie entsprechen. Dadurch können jedoch einige kostenlose Routen wegfallen. Kostenloser Zugriff ist keine Datenschutzgarantie, und „uncensored“ ist keine stabile technische Eigenschaft: Provider können eigene Regeln anwenden, und das Routing kann ändern, welcher Provider eine Anfrage bearbeitet.
Verwende nicht-explizite fiktive Prompts und versuche nicht, Schutzmechanismen von Providern zu umgehen.
FAQ
Welches OpenRouter-Modell ist aktuell am besten für Roleplay?
DeepSeek V4 Flash 0731 ist in diesem Snapshot die kostenpflichtige Basis für Kosten und Kontext, mit der sich andere Modelle vergleichen lassen. Es verbindet aktuelle Hinweise aus der OpenRouter-Roleplay-Nutzung mit Kontext in der 1M-Klasse und Preisen von $0.05/$0.16 pro Million Tokens, stellt aber keinen kontrollierten, universellen Qualitätswert dar.
Welches kostenlose OpenRouter-Modell eignet sich am besten für Roleplay?
Es gibt keinen dauerhaften Sieger: MiniMax M3 ist der kostenlose Einstiegskandidat in der hier geprüften Live-Sammlung. openrouter/free ist bequemer, liefert aber weniger reproduzierbare Ergebnisse.
Was kosten 1.000 Roleplay-Runden?
Mit den Annahmen dieses Leitfadens kostet die Nutzung mit kompaktem Verlauf ungefähr $0.28 bei DeepSeek V4 Flash 0731 und $0.43 bei GLM 5.3 Flash. Für vollständigen Verlauf werden $17.67 beziehungsweise $26.51 modelliert.
Verhindert ein größeres Kontextfenster, dass das Modell Details vergisst?
Nein. Der Kontext ist die maximale Eingabemenge, die ein Endpunkt akzeptiert, keine Garantie dafür, dass jedes Detail korrekt berücksichtigt wird. Zusammenfassungen und Begrenzungen für ältere Turns bleiben wichtig.
Warum lehnt mein Roleplay-Modell plötzlich ab oder verhält sich anders?
Provider, Fallback-Route, Free-Endpunkt oder die praktisch verfügbare Kontextgrenze können sich geändert haben. Prüfe daher die tatsächliche Modell-ID und Route, bevor du eine einzelne Ablehnung als allgemeine Modelleigenschaft interpretierst.
Lass dieselbe sichere 20-Turn-Card über DeepSeek V4 Flash 0731 und einen aktuellen kostenlosen Endpunkt laufen und speichere beide als benannte Profile. Die Paid-Route bietet besser planbare Preise und Verfügbarkeit; die Free-Route ermöglicht Experimente, allerdings bei wechselnder Kapazität und Modellidentität.