 AIREITER
Bei FinanceBench – 368 SEC-Filings mit insgesamt rund 53.900 Seiten und 150 Fragen – will Mistral die Antwortgenauigkeit mit seiner neuen Agentic-Search-Schicht deutlich gesteigert haben: gegenüber One-Shot-RAG mit einer reinen Suchschleife um 47 bis 53 Prozentpunkte, mit der vollständigen Navigationsschleife sogar um bis zu 59 Punkte. Gleichzeitig sinkt der Token-Verbrauch um bis zu ein Drittel. Der Haken zeigt sich bei der Latenz: Die komplette Schleife braucht im p90 noch 154 Sekunden, im Durchschnitt 71 Sekunden.
Mistral Agentic Search wurde am 20. August 2026 vorgestellt und richtet sich an anspruchsvolle Unternehmenskorpora wie Geschäftsberichte, Verträge und gescannte PDFs. Es handelt sich nicht um ein Websuche-Upgrade. Die minutenlange Verarbeitung ist der Preis für die höhere Trefferqualität.
Was Mistral Agentic Search macht
Mistral Agentic Search ist eine am 20. August 2026 veröffentlichte Retrieval-Schicht, die einen vorhandenen Index in eine mehrstufige Schleife mit fünf Tools einbettet: search, open, navigate, read und grep. Verfügbar ist das Ganze über das Mistral Search Toolkit; außerdem steckt es in den Libraries von Studio und Vibe. Der Index bleibt im eigenen Besitz, Fine-Tuning ist nicht erforderlich. Die Agentenschleife übernimmt Fragen, bei denen reines Chunk-Retrieval an seine Grenzen kommt.
Die fünf Tools im Zusammenspiel: search, open, navigate, read, grep
Am anschaulichsten wird das Verfahren an Mistrals eigenem Beispiel: den US-Verteidigungsausgaben im Kalenderjahr 1953. Ein einzelner Suchaufruf fand zwar die Werte für Januar bis Juni, übersah aber Juli bis Dezember. Der agentische Ablauf führte stattdessen zwei Suchen aus, fand treasury_bulletin_1954_02.pdf, sprang anschließend auf Seite 15 zu Tabelle 3 und las dort alle zwölf Monatswerte aus. Ergebnis: insgesamt 44.463 Millionen Dollar für das Jahr.
| Tool | Aufgabe |
|---|---|
search | Durchsucht den Index nach passenden Quellen |
open | Lädt ein gefundenes Dokument |
navigate | Springt darin zu Seiten, Tabellen oder Abschnitten |
read | Extrahiert den Inhalt an der jeweiligen Stelle |
grep | Findet exakte Tokens, Codes oder Kennungen per Musterabgleich |
One-Shot-RAG holt eine festgelegte Menge an Chunks und muss die Antwort in einem einzigen Durchlauf erzeugen. Fehlt nach der ersten Suche ein wichtiges Dokument, kann es nicht einfach nachfassen. Die Schleife dagegen vergleicht Quellen, folgt Verweisen in Fußnoten und Tabellen und kann unvollständige Treffer ausgleichen. Laut Mistral führt das nicht zu mehr unnötigen Wiederholungen, sondern zu weniger.
Was die Benchmarks tatsächlich zeigen
Die Ankündigung enthält zwei Benchmark-Suiten. Beide Ergebnisse stammen von Mistral und wurden mit den Standardwerten des Search Toolkits ohne Tuning ermittelt. Mistrals eigene Einordnung lautet: „Diese Ergebnisse sind eine Untergrenze, keine Obergrenze.“ FinanceBench (Islam et al., 2023; frei verfügbar auf GitHub) umfasst 368 SEC-10-K-, 10-Q- und 8-K-Filings. Nach Mistrals Zählung hat jedes davon etwa 147 Seiten; hinzu kommen 150 Fragen, deren Antworten das Setup mithilfe eines an menschlichen Labels kalibrierten LLM bewertet.
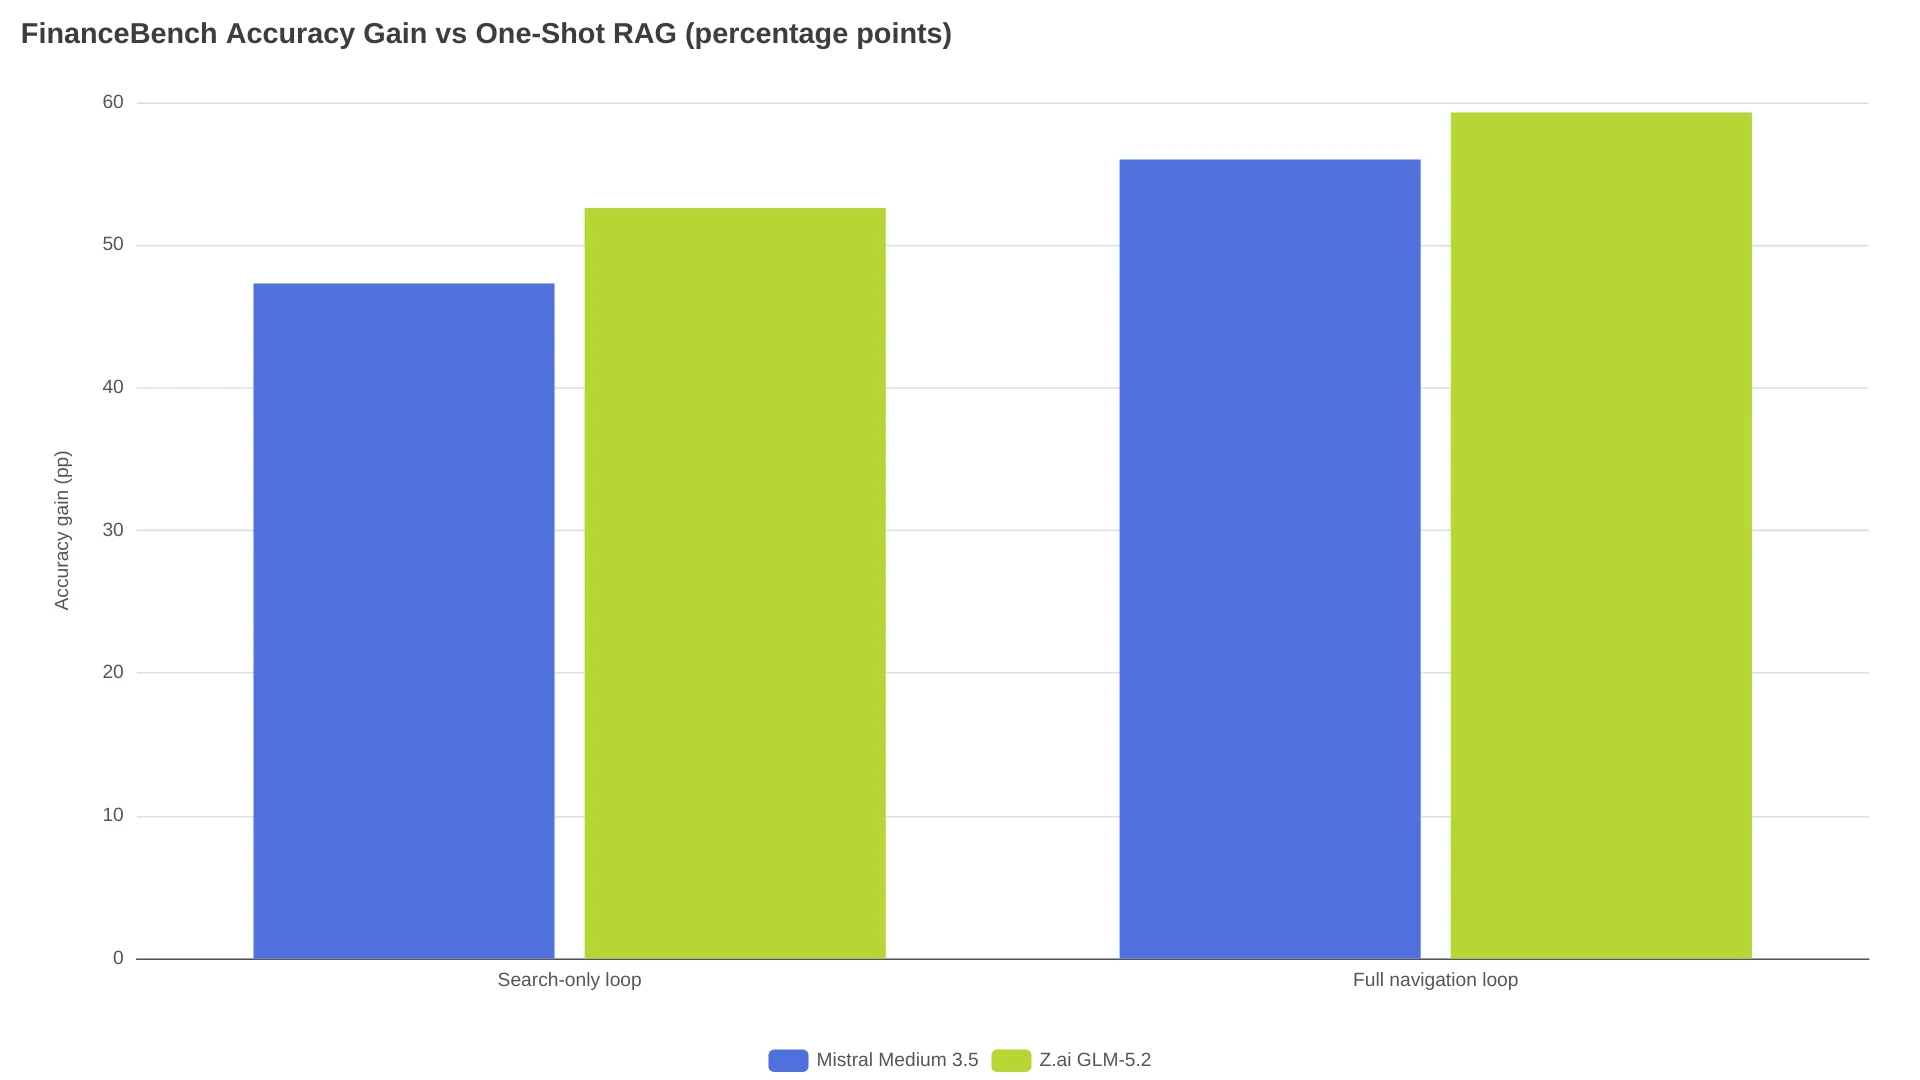
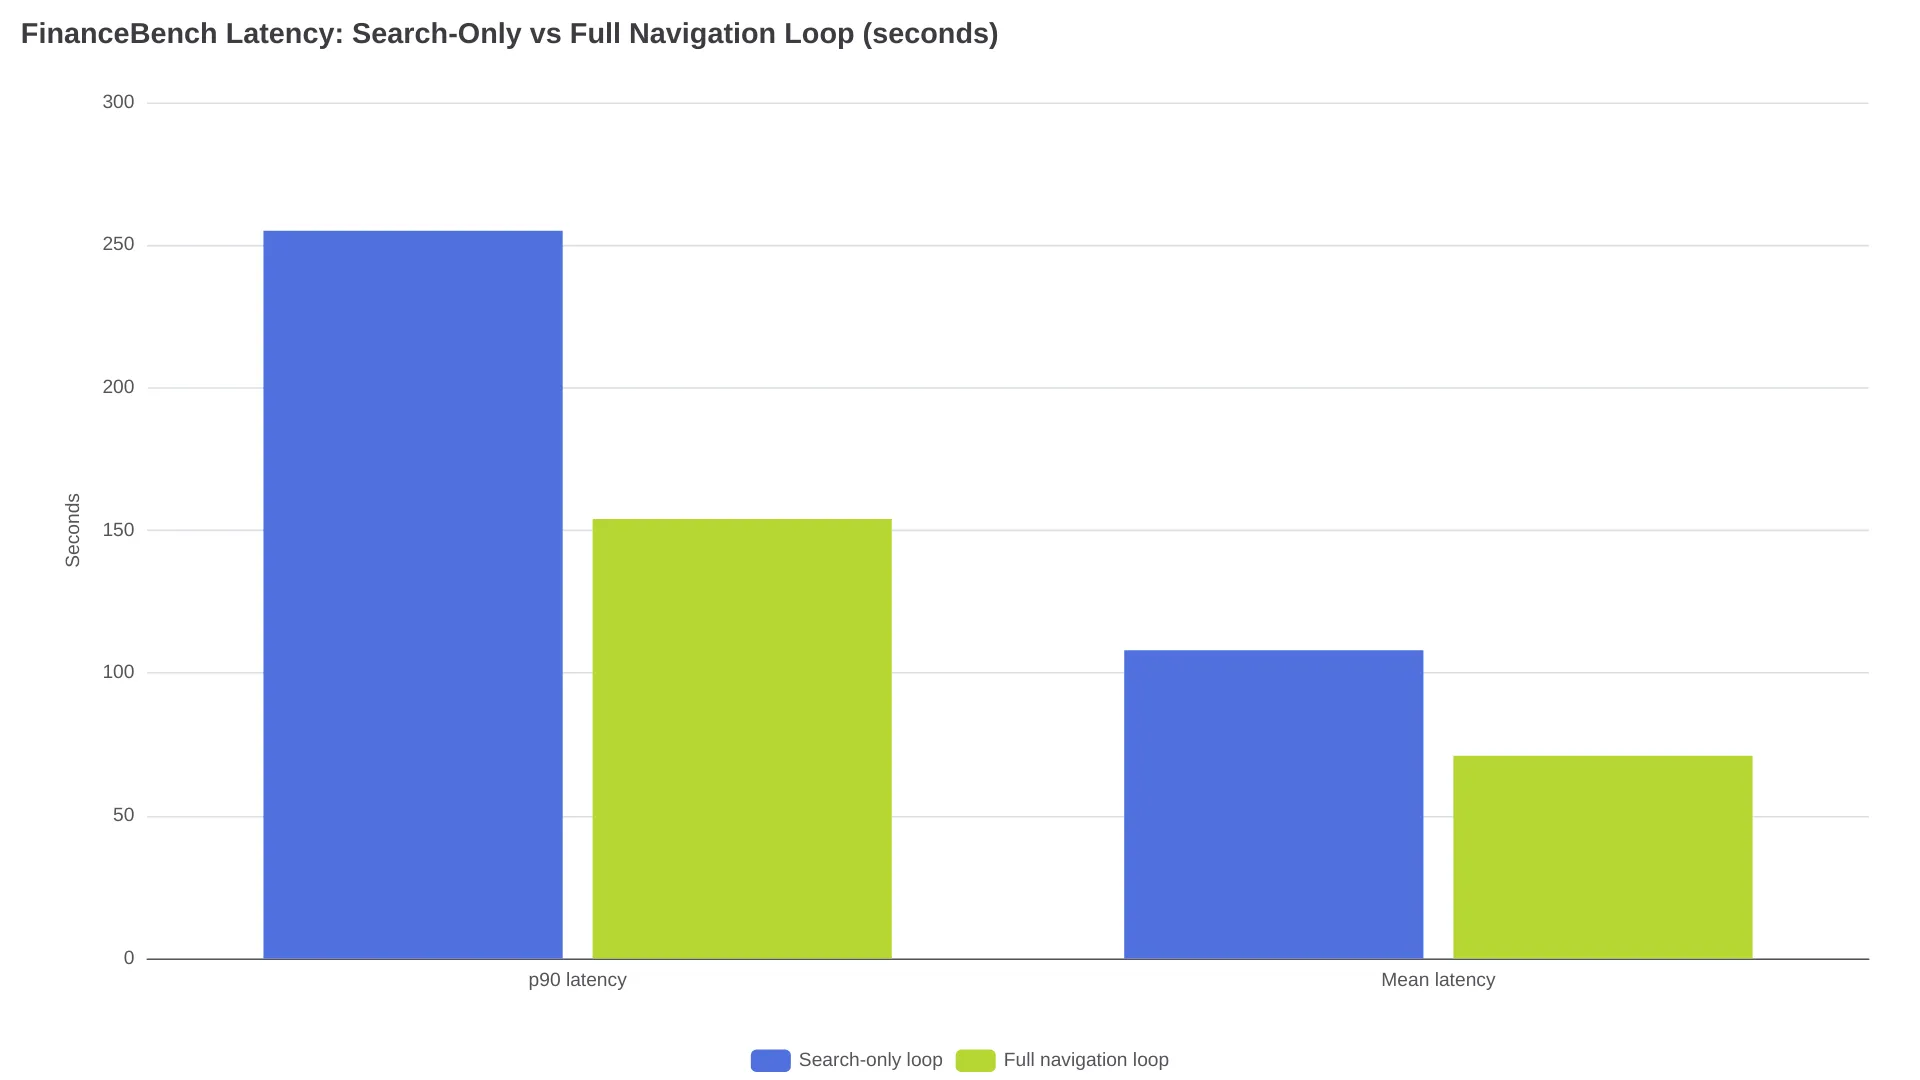
Die zusätzlichen Navigationstools (open, navigate, read, grep) bringen gegenüber der reinen Suchschleife weitere 8,7 Prozentpunkte für Mistral Medium 3.5 und 6,7 Punkte für GLM-5.2. Gleichzeitig benötigt die vollständige Navigationsschleife 23,9 % weniger Tokens mit Mistral Medium 3.5 und 33,7 % weniger mit GLM-5.2. Auch die Latenz verbessert sich: Das p90 sinkt von 255 auf 154 Sekunden, der Mittelwert von 108 auf 71 Sekunden. Wichtig ist der Vergleichsmaßstab: Die Token-Einsparung wurde gegenüber der Suchschleife gemessen, nicht gegenüber One-Shot-RAG.
OfficeQA Pro ist die anspruchsvollere Suite. Sie umfasst 696 historische US-Treasury-Bulletins mit rund 89.000 Seiten gescannter, tabellenlastiger Behörden-PDFs sowie 133 Fragen. GLM-5.2 erreichte mit der vollständigen Schleife 51,9 % Genauigkeit – ein Plus von 45,6 Prozentpunkten, was einen One-Shot-Ausgangswert von 6,3 % bedeutet. Mistral Medium 3.5 legte um 27,1 Prozentpunkte zu. Die Navigation senkte die Zahl der Durchläufe um bis zu 7,0 %.
Mistral testete sowohl das eigene Mistral Medium 3.5 als auch das externe Modell Z.ai GLM-5.2; beide zeigten dasselbe Muster. Außerdem verweist die Ankündigung auf Kimi-Forschung: Dort kam GLM-5.2 unter einem Claude-Code-Harness bei OfficeQA Pro auf 41,4 %, unter Mistrals Harness dagegen auf 51,9 %. Eine primäre Kimi-Quelle ist nicht verlinkt, daher stammt auch die Einordnung dieser Differenz von 10,5 Prozentpunkten von Mistral. Die Schlussfolgerung des Anbieters – „Die Retrieval-Qualität skaliert mit der Modellfähigkeit“ – deutet darauf hin, dass der Harness und nicht das Modell den Engpass bildet.
Wann One-Shot-RAG weiterhin die bessere Wahl ist
Mistral betont selbst, dass ein indexbasiertes Retrieval die Grundlage bleibt und die Agentenschleife erst dann zum Einsatz kommen sollte, wenn die ersten Ergebnisse nicht ausreichen. Entscheidend sind vor allem die Struktur der Dokumente und das verfügbare Latenzbudget:
| Dein Anwendungsfall | Sinnvoller Startpunkt |
|---|---|
| Direkte Abfragen in kurzen, sauberen Dokumenten | One-Shot-RAG |
| Keyword- oder semantische Suche mit hohem Volumen | One-Shot-RAG |
| Antworten befinden sich an bekannten Stellen | One-Shot-RAG |
| Filings, Verträge und Handbücher mit Tabellen und Fußnoten | Agentic Search |
| Gescannte, tabellenlastige PDFs | Agentic Search |
| Antworten verteilen sich auf mehrere Dokumente und müssen abgeglichen werden | Agentic Search |
| Interaktive Anforderungen an die Latenz (Sekunden) | One-Shot-RAG |
Wenn ein p90 von 154 Sekunden dein Produkt ausbremst, lässt sich das nicht durch bessere Genauigkeit kompensieren. Für die Stapelverarbeitung von Finanzberichten sieht die Rechnung allerdings anders aus.
Agentic Search ist nicht das web_search-Tool
Wer nach diesem Produkt sucht, landet bei Google schnell bei Mistrals Websearch-Dokumentation – dabei geht es um etwas anderes. Die Tools web_search und web_search_premium gehören zur Agents API und durchsuchen das Web live, inklusive Quellenangaben. Auf der Mistral-Preisseite für die API werden dafür 30 beziehungsweise 50 US-Dollar pro 1.000 Aufrufe fällig, zusätzlich zu den Modell-Tokens. Agentic Search funktioniert in die entgegengesetzte Richtung: Es durchsucht den eigenen indexierten Datenbestand und greift nicht auf das offene Web zu. Die beiden Angebote lösen unterschiedliche Probleme – und nur für eines gibt es veröffentlichte Preise. Für Agentic Search nennt die Ankündigung keine Kosten.
Zwei Wege zum Einstieg
- Search Toolkit. Offene Module für Ingestion, Embeddings und Indexierung, die sich in Cloud- oder On-Premises-Umgebungen betreiben lassen. Parser, Chunking, Embedding-Modelle, Vespa-Schemas, Ranking-Profile und hybrides Retrieval können konfiguriert werden.
- Libraries in Studio und Vibe. Der gemanagte Weg. Eine Search Starter App erstellt mit Standardkonfiguration lokal einen Index über den eigenen Datenbestand. Damit lässt sich das Benchmark-Setup am schnellsten nachbauen, bevor man mit dem Tuning beginnt.
Egal für welchen Weg du dich entscheidest: Schicke dieselben repräsentativen Fragen zunächst durch One-Shot-RAG und anschließend durch die vollständige Schleife. Erst danach solltest du dich anhand von Antwortqualität, Token-Verbrauch und p90-Latenz festlegen.
Was zum Start noch offen ist
Mistral hat bislang keine Preise für Agentic Search veröffentlicht. Auch die Benchmark-Ergebnisse stammen vom Anbieter selbst; eine unabhängige praktische Reproduktion lag zum Start nicht vor. Die ersten öffentlichen Reaktionen sind daher vor allem Momentaufnahmen:
„mistral just added agentic search to their api is the right move. wrapping perplexity-style search into a native agent tool saves us from writing fragile web-scraping pipelines and managing proxy rotation ourselves.“ — @AbdoKerdawy, AI product developer (X)
Die Aussagen zum Token-Verbrauch sind allerdings bereits auf Kritik gestoßen, die Mistrals Ankündigung nicht vollständig beantwortet:
„The Mistral agentic search retrieval tool claims to cut single-pass search failures by over 40%. If it bypasses database lookups, will it reduce the number of tokens you need to spend?“ — @therawlogs, independent blogger (X)
Die offizielle Antwort lautet: 24–34 % weniger Tokens gegenüber der reinen Suchschleife. Ob dieser Wert auch außerhalb der Benchmark-Korpora Bestand hat, müsste ein unabhänglicher Lauf auf dem offenen FinanceBench-Datensatz zeigen.
Auch benachbarte Produkte stoßen auf dasselbe Grundproblem: Mixedbread begrenzt seinen agentischen Toast-1-Suchmodus auf vier Runden und acht parallele Retrieval-Aufrufe. In der eigenen Dokumentation steht ausdrücklich, dass er langsamer ist als eine einzelne Suche. Die Latenz ist der Preis, den Anbieter in dieser Kategorie für mehr Genauigkeit zahlen.
Die direkten Antworten
Ist Mistral Agentic Search über die Agents API verfügbar?
Nein. Agentic Search wird über das Mistral Search Toolkit sowie die Libraries in Studio und Vibe ausgeliefert. Das web_search-Tool der Agents API ist ein separates Produkt für die Live-Websuche mit eigener Preisstruktur.
Senkt Agentic Search den Token-Verbrauch tatsächlich?
Den offiziellen Benchmarks zufolge benötigte die vollständige Navigationsschleife auf FinanceBench 23,9–33,7 % weniger Tokens als eine rein suchbasierte agentische Schleife. Eine unabhängige Reproduktion gibt es bislang nicht.
Welche Modelle funktionieren mit Agentic Search?
Mistral testete Mistral Medium 3.5 und Z.ai GLM-5.2 mit konsistenten Verbesserungen. Die Schicht wird als modellagnostisch beschrieben und benötigt kein Fine-Tuning.
Was kostet Mistral Agentic Search?
Für Agentic Search selbst wurden noch keine Preise veröffentlicht. Die auf Mistrals Preisseite genannten 30 US-Dollar pro 1.000 Aufrufe beziehen sich auf das ältere web_search-Agententool.
Der offene Zielkonflikt lässt sich leicht zusammenfassen: Hier wird Genauigkeit mit Minuten erkauft. Für Stapelverarbeitung über Filings, Verträge und gescannte Behördenunterlagen kann ein Genauigkeitssprung von +45 bis +59 Prozentpunkten – die Ergebnisse der vollständigen Schleife bei OfficeQA Pro beziehungsweise FinanceBench – zusammen mit einem um ein Drittel niedrigeren Token-Verbrauch den langsameren Ablauf rechtfertigen. Für alles, was direkt mit Nutzern interagiert, sind durchschnittlich 71 Sekunden jedoch weiterhin nicht akzeptabel. Und solange niemand außerhalb von Mistral FinanceBench erneut ausführt, bleiben die stärksten Zahlen auf der Seite Anbieterangaben.
Weiterführend: Der GLM-5.2 API-Leitfaden und der GLM-5.2-Test beleuchten das zweite Benchmark-Modell aus Mistrals Tests.