 AIREITER
Wer im Entwickleralltag schnell Code schreiben, ausführen und wieder anpassen will, fährt mit GPT-5.6 Terra meist besser: Das Modell antwortet in etwa der halben Gesamtzeit, erzeugt deutlich weniger Output-Tokens und liegt bei Terminal-Agenten vor Claude Sonnet 5. Bei realen Bugfixes in bestehenden Repositories herrscht praktisch Gleichstand, bei zusammengesetzten Reasoning-Aufgaben hat Sonnet 5 knapp die Nase vorn. Und für den ersten produktiven Einsatz entscheidend: Sonnet 5 ist bereits überall verfügbar, während Terra weiterhin schrittweise über Preview-Zugänge ausgerollt wird. Dieser Vergleich von GPT-5.6 Terra und Claude Sonnet 5 deckt einen Live-Test, veröffentlichte Benchmarks, Tempo- und Preisunterschiede sowie eine Empfehlung nach Einsatzgebiet ab.
| Aufgabe | Bessere Wahl |
|---|---|
| Interaktives Coding mit Edit-Run-Schleife | Terra |
| Terminal- / CLI-Agenten | Terra |
| Bugfixes in echten Repositories | Nahezu Gleichstand |
| Computer-Use- / Desktop-Agenten | Sonnet 5 |
| Anspruchsvollstes mehrstufiges Reasoning | Sonnet 5 |
| Niedrigste effektive Kosten je Aufgabe | Terra |
Terra im Live-Test: ein ehrlicher Praxiswert
Im Juli 2026 habe ich GPT-5.6 Terra über einen Chat-Endpunkt bei Temperatur 0 eine kleine, aber tückische Aufgabe lösen lassen: my_atoi, die String-zu-Integer-Funktion aus LeetCode #8. Sie muss führende Leerzeichen, ein optionales Vorzeichen, den Abbruch am ersten Nicht-Zeichen und die Begrenzung bei 32-Bit-Überläufen korrekt behandeln. Anschließend lief die Antwort gegen 20 Testfälle für die kritischen Ränder: leere Strings, "words and 987", "-91283472332" (unterhalb von INT_MIN), "+-12" sowie Clamping an beiden Grenzen.
Terra bestand 20 von 20 Tests in 5,5 Sekunden gemessener Client-Zeit und verwendete 193 Output-Tokens. Besonders sauber ist der Overflow-Schutz: Statt erst nach einem Überlauf zu begrenzen, prüft das Modell value > (2**31 - ... - digit) // 10 vor der Multiplikation. Ein interner Überlauf entsteht damit gar nicht erst:
while i < n and "0" <= s[i] <= "9":
    digit = ord(s[i]) - ord("0")
    if value > (2**31 - (1 if sign == 1 else 0) - digit) // 10:
        return 2**31 - 1 if sign == 1 else -2**31
    value = value * 10 + digit
    i += 1
Eine wichtige Einschränkung: Das ist ein einzelner kleiner Test, kein Benchmark – und zudem einseitig. Ich habe keinen API-Zugang zu einem echten Claude-Sonnet-5-Endpunkt. Alle folgenden Sonnet-5-Werte stammen daher aus klar gekennzeichneten öffentlichen Quellen, nicht aus eigenen Runs. Das Terra-Ergebnis ist ein konkreter Hinweis auf dessen Token-Effizienz, aber kein eigenständiges Gesamturteil.
Bei welchen Aufgaben welches Modell vorne liegt
Die Benchmarks ergeben kein klares Gesamtsieger-Modell. Der Vorteil hängt stark vom Aufgabentyp ab.
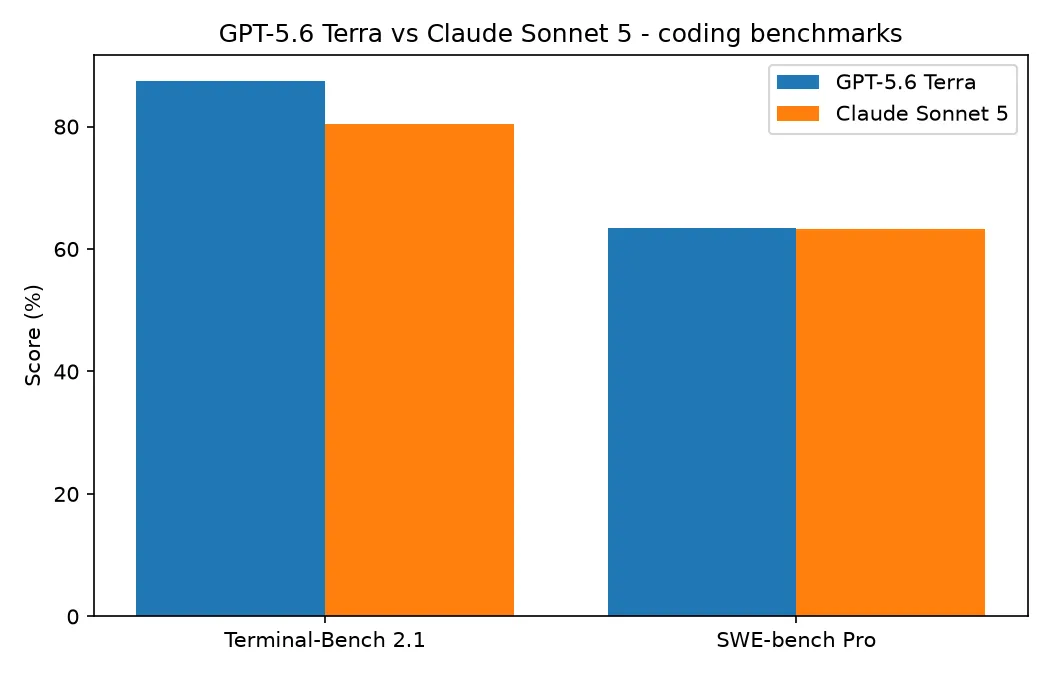
Beim Terminal-Bench 2.1, der terminalgestütztes Coding mit Agenten misst, erreicht Terra 87,4 % gegenüber 80,4 % für Sonnet 5. Für CLI-Agenten und shelllastige Automatisierung ist das ein spürbarer Abstand. Im SWE-bench Pro, der reale Bugs in echten Repositories behebt, liegen beide dagegen praktisch gleichauf: 63,4 % gegen 63,2 %. Bei den unübersichtlichen, dateiübergreifenden Fixes des Arbeitsalltags hat keines der Modelle einen klaren Vorsprung.
Bei zusammengesetztem Reasoning zieht Sonnet 5 knapp vorbei: Laut Artificial Analysis liegt sein Intelligence Index bei 53, Terra erreicht 52 – jeweils mit Terra auf xhigh Effort und Sonnet 5 auf maximalem Effort, Stand Juli 2026. Sonnet 5 erzielt außerdem 81,2 % bei OSWorld-Verified, dem Benchmark für Computer-Use-Agenten. Für Terra sind die öffentlichen Werte in diesem Bereich weniger umfangreich. Unterm Strich: Terra für Terminal-Agenten, Gleichstand bei Repo-Bugfixes und Sonnet 5 für besonders schwieriges Reasoning sowie Desktop-Agenten.
Tempo und Latenz: der Unterschied, den man direkt merkt
Benchmarks verschleiern oft das, was im Alltag zuerst auffällt: die Wartezeit auf eine Antwort. Artificial Analysis misst für Terra 118 Output-Tokens pro Sekunde, Sonnet 5 kommt auf 71. Bei der Time to First Token liegen die Werte bei 16,3 Sekunden für Terra gegenüber 198,7 Sekunden für Sonnet 5. Der zweite Wert ist ein Worst Case, kein Standardfall: Er betrifft Sonnet 5 mit maximalem Reasoning-Effort, bei dem vor der ersten Ausgabe ein langer Denkprozess vorgeschaltet wird. Mit niedrigerem Effort sinkt die TTFT deutlich, an der Reihenfolge ändert das aber nichts: Terra startet und beendet die Aufgabe früher.
Ein Praxistest von Merge zeigt das gleiche Bild. Für eine Marketing-Homepage benötigte Terra 60,2 Sekunden, Sonnet 5 136,6 Sekunden. Dabei erzeugte Terra 10.677 Output-Tokens gegenüber 17.870 bei Sonnet 5. Auch mein atoi-Test passt dazu: Terra lieferte eine korrekte, vollständig begrenzte Implementierung mit 193 Tokens. Die bislang begrenzten öffentlichen Daten und Praxistests zeigen in dieselbe Richtung: Terra formuliert knapper und liefert früher erste Ergebnisse, während Sonnet 5 mehr Tokens und Zeit investiert – teils in Reasoning, das je nach Aufgabe nützlich sein kann oder eben nicht.
In einer engen Edit-Run-Edit-Schleife summiert sich dieser Latenzunterschied schnell. Startet man hingegen eine einzelne schwierige Agentenaufgabe und geht weg, fällt er deutlich weniger ins Gewicht.
Die Kosten im Vergleich
Die regulären API-Preise liegen so nah beieinander, dass sie selten allein den Ausschlag geben.
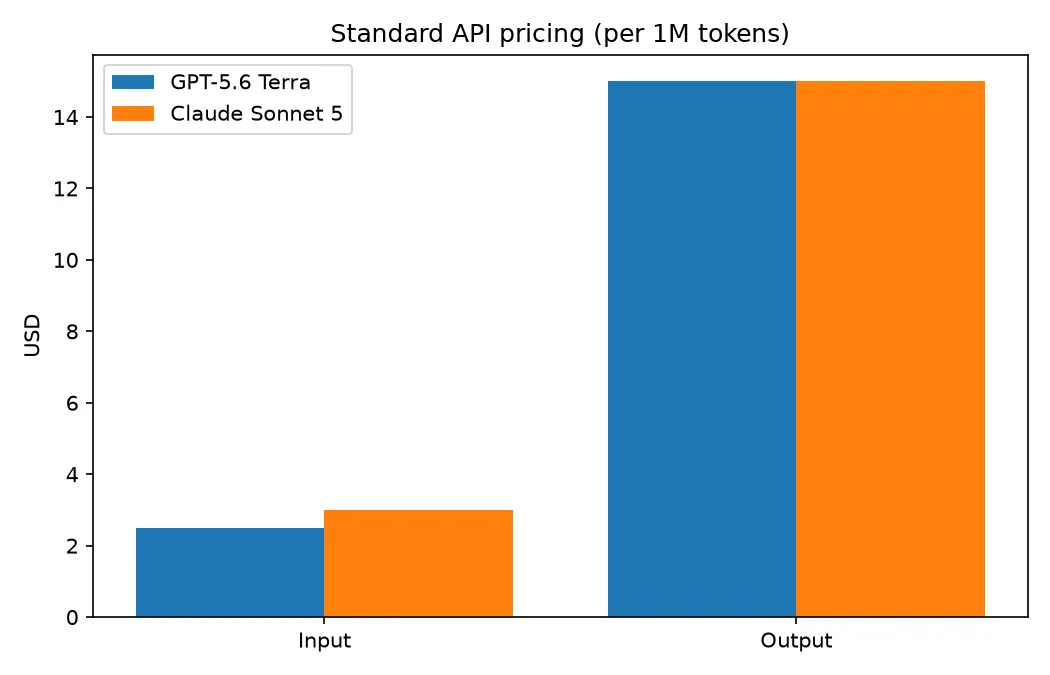
Terra kostet laut Liste 2,50 US-Dollar pro Million Input-Tokens und 15 US-Dollar für Output. Der Standardtarif von Sonnet 5 liegt bei 3 US-Dollar Input / 15 US-Dollar Output. Anthropic bietet jedoch bis 31. August 2026 einen Einführungspreis von 2 US-Dollar / 10 US-Dollar an. Damit hat Sonnet 5 bis dahin den günstigeren Listenpreis. Beide Modelle bieten ein Kontextfenster von 1 Million Tokens und maximal 128K Output. Terra kostet bei vergleichbarer Alltagsqualität außerdem ungefähr halb so viel wie die vorherige GPT-5.5-Stufe; das Preis-Leistungs-Argument richtet sich also nicht nur gegen Sonnet 5.
Für diese Modelle kursieren drei Kostenkennzahlen, die jeweils etwas anderes messen:
- Listenpreis pro Token: Terra ist beim Input günstiger und beim Output gleichauf. Der Einführungstarif von Sonnet 5 unterbietet derzeit allerdings beide Werte.
- Gemischter Indexpreis: Artificial Analysis nennt 2,17 US-Dollar für Terra und 1,54 US-Dollar für Sonnet 5. Das ist jedoch ein 3:1-Mix aus Input und Output bei den getesteten Effort-Stufen – nicht der Preis, den eine konkrete Aufgabe kostet.
- Effektive Kosten pro abgeschlossener Aufgabe: Weil Terra für dasselbe Ergebnis weniger Tokens ausgibt, gewinnt es hier meist. Der Build-Test von Merge kostete mit Terra 0,120 US-Dollar, mit Sonnet 5 0,179 US-Dollar – also etwa ein Drittel weniger, obwohl Sonnet 5 einen vergünstigten Output-Tarif hatte.
Für die meisten Workloads ist der effektive Preis je Aufgabe die Zahl, die tatsächlich auf der Rechnung landet – und sie spricht für Terra. Beide Modelle sind über Anthropic- und OpenAI-kompatible APIs erreichbar, einschließlich Drittanbieter-Gateways, die Zugang mit Rabatt weiterverkaufen, falls der Listenpreis eine harte Grenze ist.
Wofür sich Entwickler entscheiden
Benchmarks und das Verhalten der Community stimmen nicht immer überein. Deshalb lohnt auch ein Blick auf die Diskussionen. Auf X überwog im Juli 2026 aus Kostengründen die Tendenz zu den GPT-5.6-Tiers. Ein Entwickler berichtete, seine gesamte Pipeline für Agentenintegrationen ersetzt zu haben – Opus 4.8 durch Terra und Sonnet 5 durch Luna – und nannte die neueren Modelle „blazing fast, very capable and cheaper“. Ein anderer schrieb, er habe „mostly stopped using Claude“ und nutze Cursor mit Grok sowie Codex mit Terra/Sol als primären Stack für agentisches Coding.
Terra taucht zudem als Modell auf, das Probleme löst, an denen Claude scheiterte: Ein Builder berichtete, Terra habe einen Bug behoben, „that Claude Sonnet 5 couldn't crack“, und aus einem einzigen Prompt ein vollständiges Website-UI erzeugt. Die nüchternere Einordnung liefert ein Entwickler, der anmerkte, Terra sei „not as aggressive as Sol to hunt bugs, but it gets the job done“. Das passt zum Bild von Terra als konstantem, günstigem Arbeitstier statt als maximal aggressivem Bug-Jäger.
Das nimmt Sonnet 5 nichts von seiner Attraktivität. Es ist heute auf jeder Tarifstufe verfügbar, integriert sich in Claudes ausgereiften Tool-Stack und den adaptive-thinking workflow, und sein Umgang mit langem Kontext bleibt bei umfangreichen agentischen Aufgaben überzeugend. Für Teams, die bereits auf Claude standardisiert sind, ist diese Kontinuität oft mehr wert als ein paar Cent pro Aufgabe.
Welches Modell passt zu welchem Einsatz?
Entscheidend ist die Form des Workloads, nicht ein pauschales „besseres“ Modell. Für die Coding-Arbeit, die ich am häufigsten mache – schnelle Iterationen, Terminal-Agenten und niedrige Kosten je Aufgabe –, ist Terra meine Standardwahl. Für reasoning-intensive Aufgaben halte ich Sonnet 5 bereit.
- Wähle GPT-5.6 Terra, wenn du häufig interaktiv programmierst, Latenz in einer Edit-Run-Schleife wichtig ist, du Terminal- oder CLI-Agenten einsetzt oder die niedrigsten effektiven Kosten pro Aufgabe suchst. Tempo und Token-Effizienz sind die eigentlichen Stärken.
- Wähle Claude Sonnet 5, wenn deine Arbeit besonders schwieriges mehrstufiges Reasoning, agentische Runs mit langem Kontext oder Computer-Use-Aufgaben erfordert. Das Modell passt auch, wenn du bereits im Claude-Ökosystem arbeitest und etwas brauchst, das heute auf jeder Tarifstufe verfügbar ist. Der Einführungspreis von 2 US-Dollar / 10 US-Dollar bis 31. August macht es zudem leicht, Sonnet 5 auszuprobieren.
Für die meisten Entwickler, die täglich Features ausliefern, gewinnt Terra mit seinem Tempo-Kosten-Profil. Bei wirklich harten Reasoning-Aufgaben oder wenn sich ein Plattformwechsel nicht lohnt, bleibt Sonnet 5 die sicherere Wahl. Die Modelle liegen nah genug beieinander, dass letztlich der eigene Workflow entscheidet – nicht die Rangliste.
FAQ
Ist GPT-5.6 Terra besser als Claude Sonnet 5?
Für schnelles und kosteneffizientes Coding: ja. Terra ist schneller, pro Aufgabe günstiger und liegt bei Benchmarks für Terminal-Agenten vorn. Bei den schwierigsten Reasoning- und Computer-Use-Aufgaben ist Sonnet 5 mindestens gleichauf und oft vorne. Einen universellen Sieger gibt es nicht; entscheidend ist die Aufgabe.
Ist Claude Sonnet 5 gut zum Programmieren?
Ja. Bei realen Repo-Bugfixes erreicht es im SWE-bench Pro nahezu Terra-Niveau, 63,2 % gegenüber 63,4 %, und bei agentischen OSWorld-Verified-Aufgaben liegt es vorn. Seine Schwächen gegenüber Terra liegen bei Geschwindigkeit und Time to First Token, nicht bei der Codequalität.
Wie viel günstiger ist Terra im Vergleich zu Sonnet 5?
Beim Listenpreis liegt Terra bei 2,50 US-Dollar / 15 US-Dollar, Sonnet 5 regulär bei 3 US-Dollar / 15 US-Dollar. Der Einführungstarif von Sonnet 5 mit 2 US-Dollar / 10 US-Dollar bis 31. August 2026 unterbietet Terra jedoch vorübergehend. Bei den effektiven Kosten je Aufgabe liegt Terra meist trotzdem vorn, weil es weniger Output-Tokens erzeugt.
Haben Terra und Sonnet 5 das gleiche Kontextfenster?
Praktisch ja: Beide bieten ein Kontextfenster von 1 Million Tokens und maximal 128K Output. Die Kontextgröße dürfte daher kaum das entscheidende Kriterium sein.
Ist GPT-5.6 Terra schon überall verfügbar?
Noch nicht vollständig. Sonnet 5 ist heute auf allen Tarifstufen verfügbar, während der Zugang zu GPT-5.6 teils weiterhin auf Preview und ausgewählte API-Partner beschränkt ist. Das ist relevant, wenn du das Modell sofort produktiv einsetzen musst.