 AIREITER
Das ursprüngliche Repository facebookresearch/demucs ist seit dem 1. Januar 2025 schreibgeschützt. Demucs gehört trotzdem weiterhin zu den stärksten kostenlosen Lösungen für die lokale Stem-Separation – sofern du es aus dem Fork mit v4.1.0 installierst und akzeptierst, dass Gitarre und Klavier zu den ersten Instrumenten gehören, bei denen die Qualität nachlässt.
Das gepflegte Demucs-Repo verwenden – nicht das archivierte
Auf GitHub gibt es zwei Repositories mit demselben README, aber nur eines davon erhält noch Fehlerbehebungen. facebookresearch/demucs ist archiviert und schreibgeschützt; im eigenen README wird bereits auf eine andere Adresse verwiesen. Die gepflegte Version liegt bei adefossez/demucs. Autor Alexandre Défossez schreibt dort, dies sei „das offiziell gepflegte Demucs, nachdem ich Meta verlassen habe, um zu Kyutai zu wechseln“. Gleichzeitig weist er darauf hin, dass man „vorerst mit langsamen Antworten und keinen neuen Funktionen rechnen“ sollte.
Der Unterschied betrifft also nicht nur die URL, sondern auch die Installationsbefehle.
Was sich mit v4.1.0 geändert hat
Der Release-Eintrag vom 11/07/2026 führt Demucs v4.1.0 mit „modernisiertem Packaging, schlankeren Inference-Abhängigkeiten, zahlreichen Fehlerbehebungen und auf Hugging Face gehosteten vortrainierten Modellen“ auf. In der Praxis bedeutet das:
| Punkt | Archiviertes Repo | Gepflegtes Repo (v4.1.0) |
|---|---|---|
| Minimale Python-Version | 3.8 | 3.10 |
| Schnellster Start | pip install -U demucs | uvx demucs MY_TRACK.mp3 (keine Installation nötig) |
| Dauerhafte Installation | pip install -U demucs | uv tool install demucs (pip funktioniert weiterhin) |
| ffmpeg | Erforderlich | Optional; nötig für FLAC-Ausgabe und Formate, die sphn nicht dekodieren kann |
| Quantisierte Modelle | Enthalten | Benötigen das Extra: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Hosting der Gewichte | dl.fbaipublicfiles.com | Hugging Face |
Ein wichtiger Stolperstein, bevor du einen Bug meldest: PyTorch hat die Unterstützung für Intel-Macs nach Version 2.2 eingestellt. Damit bist du auf Python 3.12 begrenzt; Intel-Mac-Nutzer sollen daher uvx --python 3.12 demucs verwenden.
Das passende Modell auswählen: htdemucs, htdemucs_ft, htdemucs_6s, mdx
Mit dem Flag -n legst du das Modell fest. Die Voreinstellung ist nicht automatisch für jeden Zweck die beste Wahl. Demucs bietet Modelle für vier Quellen – Drums, Bass, Other und Vocals –, ein Experiment mit sechs Quellen sowie die älteren MDX-Modelle aus dem entsprechenden Wettbewerb.
| Modell | Quellen | Geschwindigkeit | Offizieller Hinweis | Sinnvoll, wenn |
|---|---|---|---|---|
htdemucs | 4 | Basis (Standard) | keiner angegeben | du einen ersten Durchlauf oder Batch-Verarbeitung machst und Durchsatz zählt |
htdemucs_ft | 4 | ~4× langsamer | „könnte etwas besser sein“ | du den finalen Export eines wichtigen Tracks erstellst |
htdemucs_6s | 6 | Zwischen den beiden | Gitarre „okay“; Klavier „funktioniert nicht besonders gut“, mit „viel Übersprechen und Artefakten“ | du unbedingt einen Gitarren-Stem brauchst und Kompromisse akzeptierst |
hdemucs_mmi | 4 | Basis | v3-Architektur, neu trainiert | du per A/B-Test prüfen willst, ob v4 bei einem bestimmten Mix schlechter klingt |
mdx / mdx_extra | 4 | Basis | mdx_extra wurde mit Daten trainiert, die auch den MUSDB-Testsatz enthielten | du älteres Material bearbeitest oder dich die Artefakte von v4 stören |
mdx_q / mdx_extra_q | 4 | Am schnellsten, am kleinsten | „Die Qualität kann etwas schlechter sein“ | du wenig Speicher hast oder schnell eine Vorschau brauchst |
Der Vorbehalt bei htdemucs_ft ist entscheidend: Für einen möglichen Qualitätsgewinn steigt der Rechenaufwand auf das Vierfache. Auf der CPU ist dieser Aufschlag massiv – und Nutzer sprechen das auch offen an.
Was die SDR-Werte 9.00 und 9.20 dB tatsächlich aussagen
Beide Zahlen stehen im selben README-Absatz, sind aber nicht gleichzusetzen. Hybrid Transformer Demucs erreicht 9.00 dB SDR auf dem MUSDB-HQ-Testsatz. Die höheren 9.20 dB setzen Sparse-Attention-Kernels und Fine-Tuning pro Quelle voraus. Dieses Sparse-Modell „wird nicht bereitgestellt, da es eigenen CUDA-Code benötigt, der noch nicht veröffentlichungsreif ist“.
Kein herunterladbares Modell erreicht also die 9.20 dB. In der Vergleichstabelle des README kommt der ausgelieferte, feinabgestimmte v4-Eintrag insgesamt auf 9.0 SDR und liegt damit gleichauf mit Band-Split RNN, das auf 1.7k Mixes trainiert wurde.
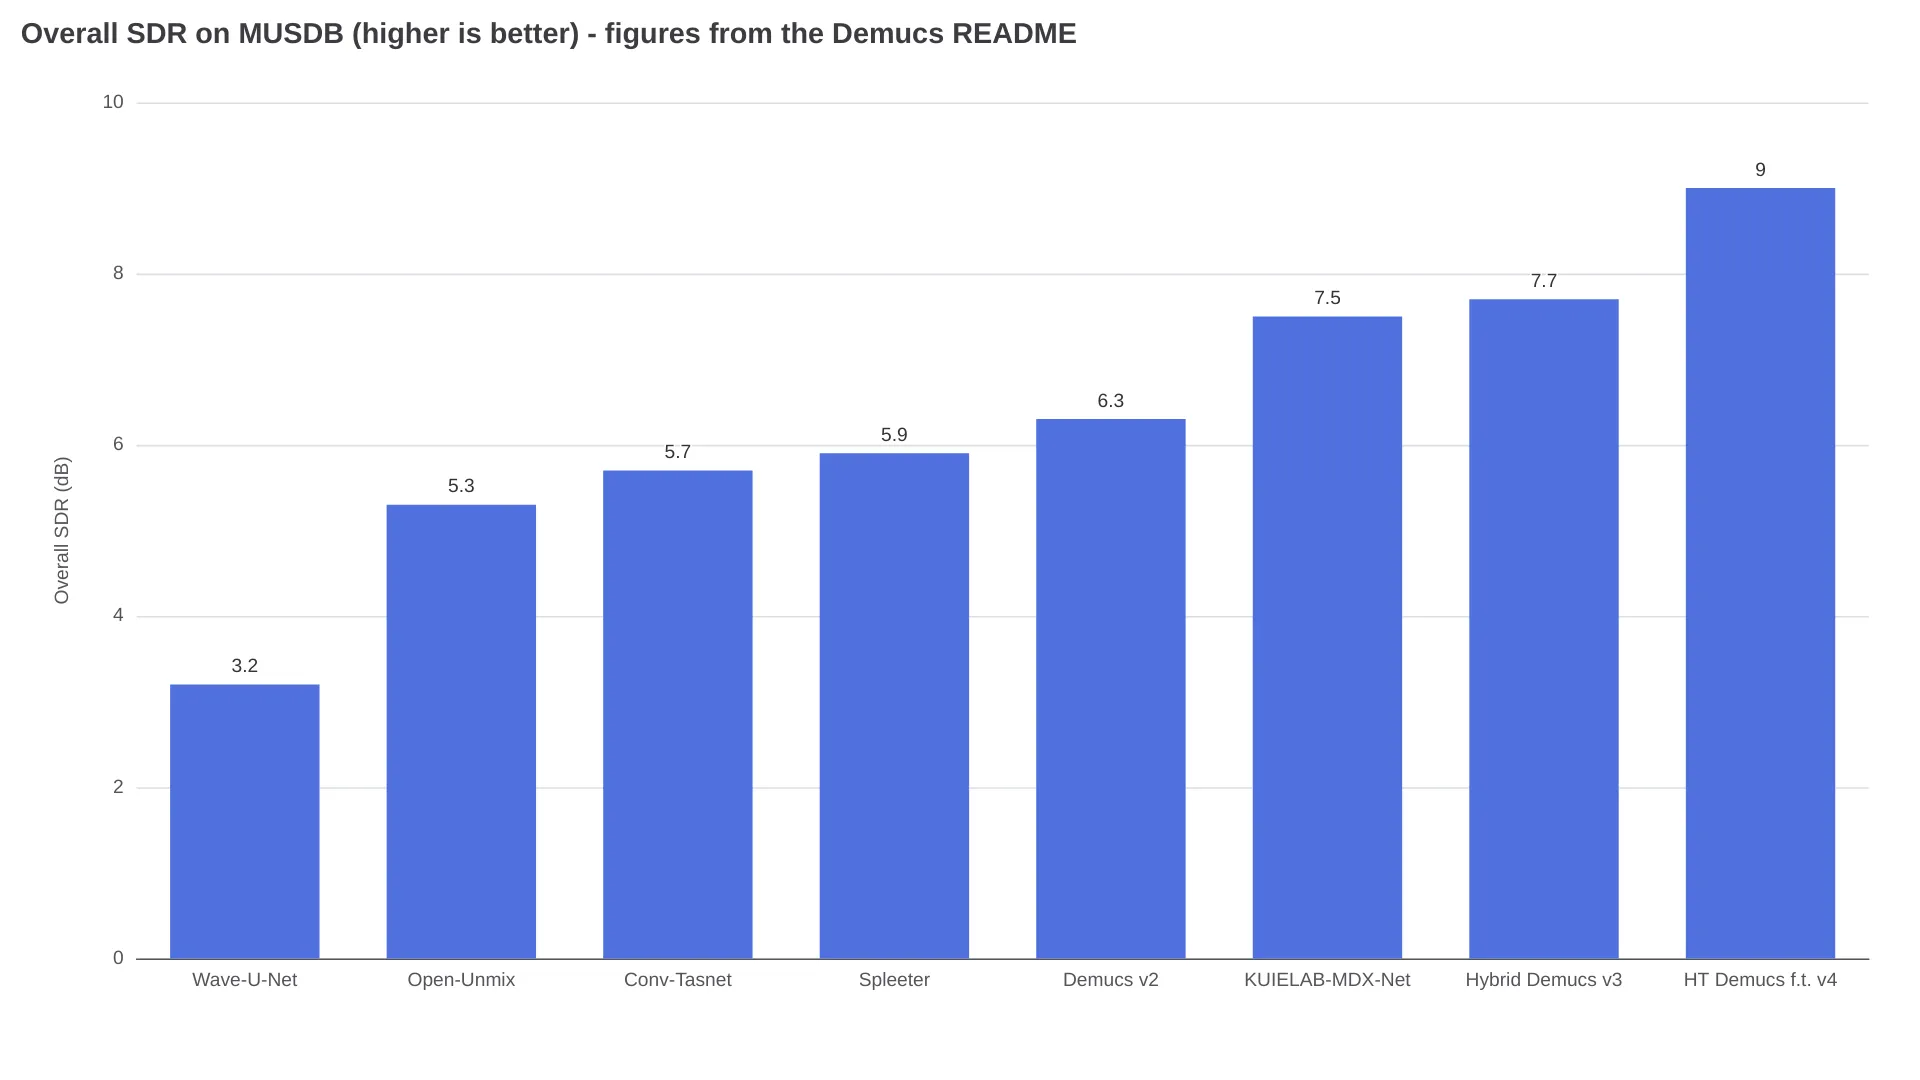
In derselben Tabelle kommt Spleeter trotz des Trainings mit 25k Songs nur auf 5.9 dB – gegenüber dem feinabgestimmten v4-Eintrag ist das ein Abstand von ungefähr 3 dB.
Diese Flags verändern das Ergebnis
Bei den meisten Demucs-Läufen musst du drei Dinge festlegen: Wie viele Stems sollen entstehen, wie viel Rechenzeit darf die Separation kosten und in welchem Format soll ausgegeben werden?
--two-stems=vocalsaktiviert den Karaoke-Modus und erzeugtvocals.wavsowieno_vocals.wav. Demucs trennt den kompletten Mix zunächst vollständig und mischt ihn anschließend herunter. Das ist daher weder schneller noch speicherschonender als ein normaler Lauf.--shifts=Nmittelt N Vorhersagen mit zufällig verschobenem Eingangssignal. Dadurch wird die Vorhersage N-mal langsamer; im README lautet die Empfehlung: „nicht verwenden, außer du hast eine GPU“. Im Paper wurden 10 Shifts genutzt, bei Replicate ist standardmäßig 1 eingestellt.--overlapsteht standardmäßig auf 0.25 und kann für einen kleinen Geschwindigkeitsgewinn auf 0.1 reduziert werden.--segment Nist der wichtigste Regler gegen OOM-Fehler. Ein Detail sorgt dabei regelmäßig für Probleme in kopierten Befehlen: Hybrid-Transformer-Modelle unterstützen maximal 7.8 Sekunden Segmentlänge. Ein längerer Wert bei--segmentwirkt daher nur bei den Nicht-HT-Modellen.- Ausgabe-Flags sind
--mp3(standardmäßig 320 kbps),--flac(benötigt ffmpeg),--int24und--float32. Standardmäßig schreibt Demucs 16-Bit-WAV mit 44.1 kHz nachseparated/MODEL_NAME/TRACK_NAME. --clip-modeist wichtiger, als es zunächst wirkt: Standardmäßig skaliert Demucs die Stems neu, um Clipping zu vermeiden. Dadurch können sich die relativen Lautstärken zwischen den Stems verändern.clampbegrenzt stattdessen hart.
Die Hardware-Anforderungen aus derselben Dokumentation: mindestens 3 GB GPU-RAM, mit den Standardargumenten ungefähr 7 GB. Wer bei 3 GB oder weniger liegt, sollte --segment 8 zusammen mit PYTORCH_NO_CUDA_MEMORY_CACHING=1 verwenden. Auf der CPU soll die „Verarbeitungszeit ungefähr dem 1,5-Fachen der Trackdauer entsprechen“. Das wirkt allerdings optimistisch im Vergleich zu den Erfahrungswerten mit htdemucs_ft.
Wo Demucs überspricht – und wie Nutzer das Problem in zwei Durchläufen umgehen
Übersprechen ist die Kritik, die immer wieder auftaucht. Besonders deutlich wird es bei Vocals, die im selben Register wie ein Lead-Instrument liegen. Ryan Herr (@rrherr) brachte es nach einem Extraktionsversuch auf den Punkt:
demucs let a lot of sax bleed into the 'vocals' track.
Erfahrene Nutzer greifen daher nicht zu einem speziellen Flag, sondern zu einem zweiten Modell. Der japanische Produzent 夜凪P (@yonagip, 145 Likes) beschreibt, wie er zunächst in UVR5 einen MelBand-Roformer-Lauf verwendet, um Vocals und Instrumentalspur zu trennen. Anschließend gibt er nur das Instrumental an htdemucs_ft, um Drums, Bass und Other aufzuteilen:
Demucs単体だとVoが他に漏れるんだけど (with Demucs alone, the vocals leak into the other stems)
Zwei weitere Nutzerberichte zeigen in dieselbe Richtung: Ein Produzent misst mit htdemucs_ft eine bessere Bassdefinition, bezeichnet die CPU-Verarbeitung aber als viermal langsamer (@hachi_vm). Ein anderer veröffentlicht einen Vergleich zur Gitarrenextraktion, bei dem htdemucs-6s sichtbar gegen ein BS-RoFormer-Modell verliert (@junon_12). Das sind Einzelerfahrungen und keine Benchmarks, sie passen aber zur offiziellen Einschätzung: Als Défossez das Modell mit sechs Quellen im Dezember 2022 ankündigte, schrieb er, dass er „etwas Übersprechen und Artefakte“ beobachtet habe.
Praktische Faustregel: Enthält die Aufnahme Saxofon, eine Leadgitarre oder ein melodisch eingesetztes Klavier, solltest du einen einzelnen Demucs-Lauf eher als Ausgangspunkt denn als fertiges Ergebnis betrachten. Alternativen aus der Roformer-Klasse sind über die UVR5-Oberfläche erreichbar, wenn du einen zweiten Durchlauf brauchst.
Demucs per API nutzen statt lokal zu installieren
Wenn du Stems ohne Python-Umgebung erzeugen möchtest, ist cjwbw/demucs auf Replicate eine weit verbreitete gehostete Variante: ungefähr 1.5 Millionen Läufe auf Nvidia-T4-Hardware. Laut der Schätzung auf der Seite kostet ein Lauf etwa $0.020 (~50 Läufe pro Dollar), die Vorhersagen sind typischerweise innerhalb von 90 Sekunden fertig.
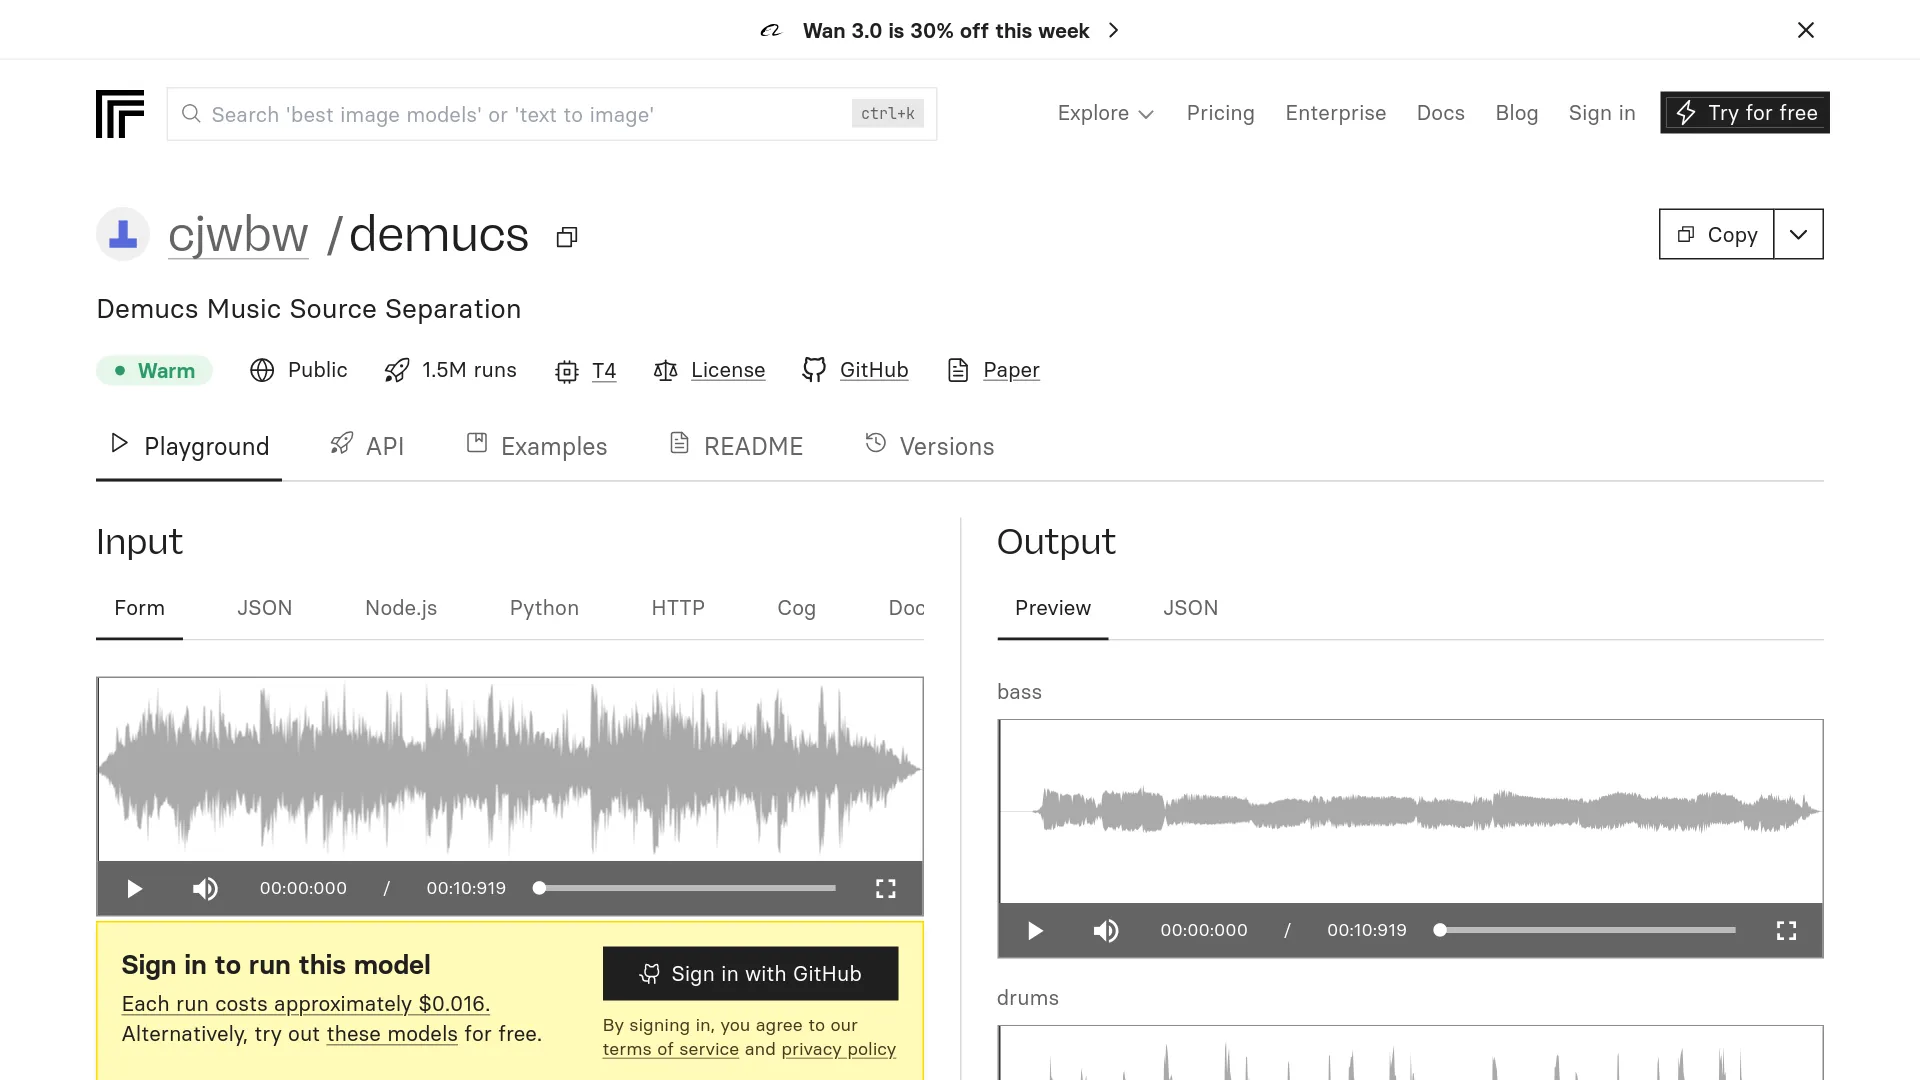
Das Eingabeschema entspricht weitgehend der CLI: model_name (Standard htdemucs), stem, shifts (Standard 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32 und output_format (mp3).
Ein Detail weist die Seite allerdings nicht automatisch aus: Die letzte Version ist ungefähr drei Jahre alt, und ein gehosteter Endpoint verwendet einen festgelegten Snapshot. Du rufst also diesen Build auf – nicht das Packaging und die Dependency-Überarbeitung von v4.1.0 aus dem Juli 2026. Auch die Laufzeit schwankt stärker, als die Schlagzeile vermuten lässt: Eine öffentliche Beispielvorhersage für dasselbe Modell dauerte 6 Minuten 18 Sekunden.
Was ein 4-Minuten-Track tatsächlich kostet
Für den Workflow entscheidend sind die Kosten pro Track. Und die hängen von einem Abrechnungsdetail ab, das viele erst nach dem Abschluss eines Abos entdecken.
LALAL.AI berechnet die Nutzung als Dateilänge × Anzahl der ausgewählten Stem-Separation-Typen. Ein 4-minütiger Song, der in vier Stems aufgeteilt wird, verbraucht daher 16 Minuten – nicht 4.
Dieselbe Preisseite listet einmalige Aufladungen auf (geprüft am September 25, 2026): $50 für 750 Minuten in der Fast Queue, $190 für 3,000 und $300 für 5,000. Bei diesen Preisen kostet die Separation eines 4-Minuten-Songs in vier Stems zwischen $0.96 und $1.07.
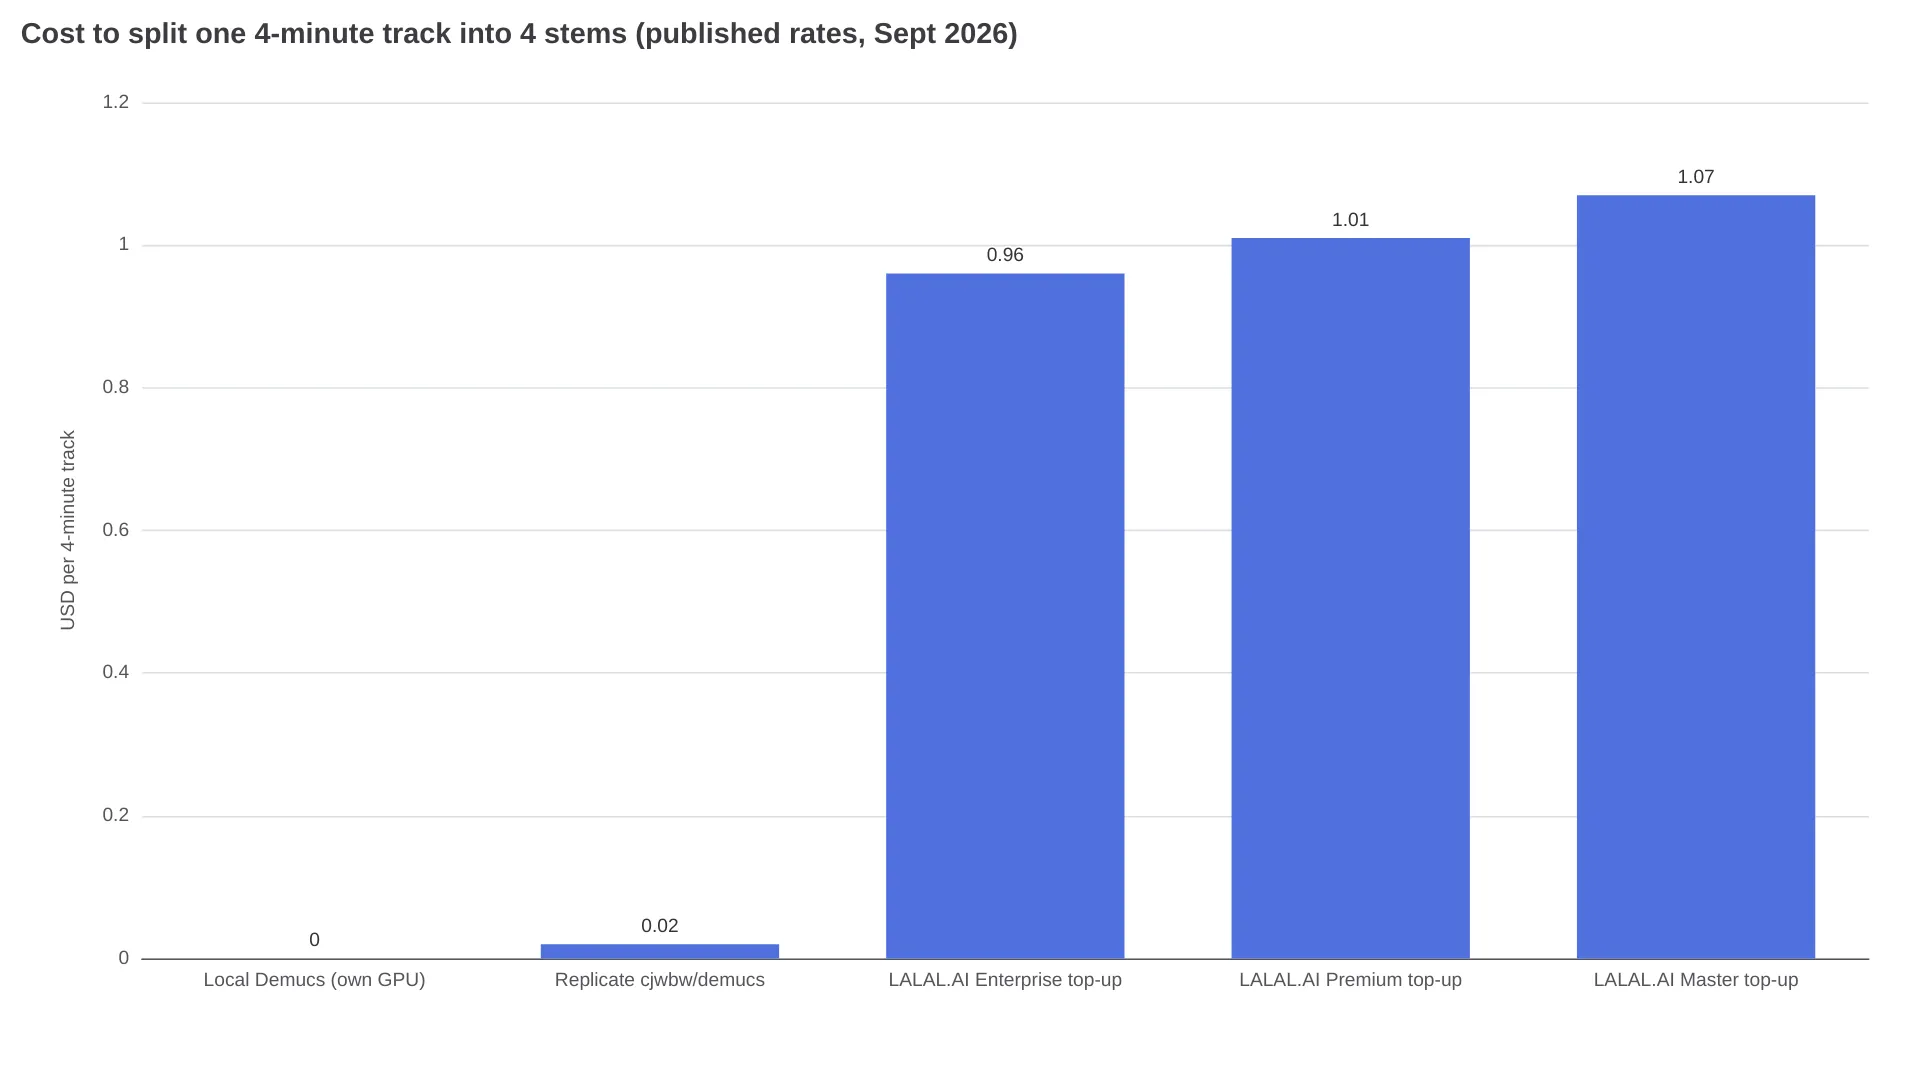
Eine Einschränkung solltest du bei diesem Diagramm beachten: Die LALAL.AI-Werte beziehen sich auf die Verarbeitung in der Priority-Warteschlange. Bezahlte Tarife enthalten unbegrenzte Minuten in der Relaxed Queue. Das Unternehmen gibt an, dass beide Warteschlangen „identische Separation-Qualität liefern“. Die Fast Queue verkürzt lediglich die Wartezeit.
| Tarif | Preis | Enthalten | Wichtige Einschränkungen |
|---|---|---|---|
| LALAL.AI Starter | Kostenlos | 10 Minuten Relaxed Queue | Upload-Limit von 200 MB |
| LALAL.AI Lite | €6.75/Monat, €81 jährlich abgerechnet | Unbegrenzt Relaxed, 90 Fast-Minuten | Kein Batch, VST oder API; Minuten verfallen |
| LALAL.AI Pro | €13.50/Monat, €162 jährlich abgerechnet | Unbegrenzt Relaxed, 250 Fast-Minuten | Einziger Tarif mit API-Zugriff, VST-Plugin und Batch-Verarbeitung |
| Moises | Öffentlich nicht angegeben | Kostenloser Tarif mit begrenzten monatlichen Uploads | Preistabelle erst nach dem Login sichtbar; wirbt mit 27 Stem-Typen |
Replicate cjwbw/demucs | ~$0.020/Lauf | T4, meist unter 90 s | Version seit ~3 Jahren festgeschrieben |
| Lokales Demucs | Kostenlos (MIT-Lizenz) | Unbegrenzt, offline | Deine GPU-Zeit und der Einrichtungsaufwand |
Mit 90 Minuten Fast Queue im Lite-Tarif lassen sich ungefähr fünf Tracks mit vier Stems pro Monat verarbeiten, bevor du in die Relaxed Queue wechselst. Wer mehr als eine Handvoll Songs pro Woche bearbeitet, stellt schnell fest, dass eine Abrechnung pro Minute unattraktiv wird. Genau ab diesem Umfang lohnt sich die Installation von Demucs für einen freien Nachmittag Einrichtung.
Welche Lösung zu welchem Einsatz passt
| Deine Situation | Beste Lösung | Warum |
|---|---|---|
| Gelegentliche Separation, keine GPU, kein Terminal | LALAL.AI Starter, danach Lite | Mit 10 kostenlosen Minuten lässt sich die Qualität vor dem ersten Bezahlen testen |
| Stücke lernen, Üben mit dem Smartphone | Moises | 27 Stem-Typen sowie Funktionen für Tempo und Akkorde; Preis nach dem Login prüfen |
| Hoher Durchsatz, eigene GPU | uvx demucs mit htdemucs | Keine Grenzkosten, unbegrenzte Läufe, nichts verlässt deinen Rechner |
| Ein wichtiger finaler Export | htdemucs_ft, --shifts 2 auf einer GPU | Für das letzte Stück Qualität wird der vierfache Rechenaufwand in Kauf genommen |
| Gitarren-Stem benötigt | Zuerst htdemucs_6s, danach ein Vergleich mit einem Modell der Roformer-Klasse in UVR5 | Die offizielle Dokumentation räumt beim Modell mit sechs Quellen Übersprechen ein |
| Unveröffentlichtes oder NDA-Material | Nur lokales Demucs | Kein Upload, MIT-Lizenz, Offline-Verarbeitung |
| App-Backend ohne Ops-Budget | Replicate cjwbw/demucs | ~$0.020/Lauf und keine eigene GPU-Infrastruktur erforderlich |
Demucs Stem Separation FAQ
Welches Demucs-Modell liefert die besten Vocals?
htdemucs_ft ist das stärkste ausgelieferte Modell mit vier Quellen für Vocals, benötigt aber ungefähr viermal so lange wie htdemucs. Bei schwierigen Mixes berichten Nutzer von besseren Ergebnissen mit einer Kette aus zwei Durchläufen: zuerst eine Vocal-Separation mit einem Modell der Roformer-Klasse, anschließend Demucs für die Aufteilung des Instrumentals.
Kann Demucs Gitarre und Klavier separieren?
Nur mit htdemucs_6s. Im offiziellen README wird die Gitarrenqualität in einem kurzen Test als „okay“ bezeichnet. Beim Klavier heißt es dagegen, die Quelle „funktioniert nicht besonders gut“, mit „viel Übersprechen und Artefakten“.
Benötige ich eine NVIDIA-GPU für Demucs?
Nein. Demucs läuft auch auf der CPU mit -d cpu; die Dokumentation veranschlagt die Verarbeitung mit ungefähr dem 1,5-Fachen der Trackdauer. Auf Apple-Silicon-Geräten kannst du -d mps verwenden. Für GPU-Beschleunigung sind mindestens 3 GB VRAM nötig, mit den Standardargumenten ungefähr 7 GB.
Warum lassen sich die separierten Stems nicht wieder zum ursprünglichen Mix zusammensetzen?
Demucs skaliert die einzelnen Stems neu, um durch die Separation verursachtes Clipping zu vermeiden. Dadurch können sich die relativen Lautstärken zwischen den Stems verändern. Verwende --clip-mode clamp für hartes Clipping oder reduziere die Lautstärke des Eingangsmixes vor der Verarbeitung.
Wo speichert Demucs die Stems?
Unter separated/MODEL_NAME/TRACK_NAME/ als Stereo-WAV-Dateien mit 44.1 kHz und 16-Bit-Kodierung: drums.wav, bass.wav, other.wav und vocals.wav – sofern du nicht die Ausgabe als MP3, FLAC, int24 oder float32 anforderst.
Wie behebe ich einen CUDA-Out-of-Memory-Fehler?
Reduziere --segment (8 ist der dokumentierte Mindestwert für Karten mit 3 GB), setze PYTORCH_NO_CUDA_MEMORY_CACHING=1 oder wechsle mit -d cpu auf die CPU. Beachte außerdem, dass Hybrid-Transformer-Modelle die Segmentlänge auf 7.8 Sekunden begrenzen. Ein höherer Wert hat bei diesen Modellen daher keinen Effekt.