 AIREITER
MuseTalk, 4 GB belleğe sahip bir dizüstü GPU'sunda çalışabiliyor: resmî README, FP16 modunda bir RTX 3050 Ti Laptop GPU'nun sekiz saniyelik bir klibi yaklaşık beş dakikada işlediğini belirtiyor. MuseTalk lipsync kararındaki asıl mesele de burada yatıyor: Modelin çalışması başka, bunu yeterince hızlı yapması başka. Aynı ayrım çözünürlükte, kurulumda ve aşağıdaki maliyet tablosunda da karşımıza çıkıyor.
MuseTalk görüntünüzde neyi değiştiriyor, neyi olduğu gibi bırakıyor?
MuseTalk, mevcut bir videodaki ağız ve yüzün alt bölümünü yeniden boyayarak dudak hareketlerini verdiğiniz ses kaydıyla eşleştiriyor. Kafa pozisyonu, göz hareketleri, yüz ifadesi, arka plan ve kamera hareketi yeniden üretilmiyor; kaynak videodan olduğu gibi aktarılıyor. Yani bu bir konuşan kafa üreticisi değil, yerel bir düzenleme aracı. İşe başlamak için yüzün net biçimde göründüğü hazır bir videoya ihtiyacınız var.
Hızın arkasındaki neden model mimarisi. Tencent Music bünyesindeki Lyra Lab tarafından yayımlanan repository, maskelenmiş yüzü dondurulmuş sd-vae-ft-mse VAE ile kodluyor, ses özelliklerini dondurulmuş Whisper-tiny modeliyle çıkarıyor ve bu ikisini Stable Diffusion v1.4'ten alınan bir UNet içindeki cross-attention katmanında birleştiriyor. Model, yinelemeli gürültü giderme döngüsü yerine latent uzayda tek adımlı inpainting yapıyor. Yazarların NVIDIA Tesla V100 üzerinde 30 fps veya daha yüksek hız iddiasının temelinde bu tercih var.
1080p kaynak videoda 256x256 yüz alanı ne anlama geliyor?
256x256 değeri çıktı çözünürlüğünü değil, düzenlenen yüz bölgesinin boyutunu ifade ediyor. 1080p videonuz, orijinal kare hızıyla birlikte yine 1080p olarak çıkıyor; yalnızca 256x256 boyutundaki bir alan yeniden üretilip ağız bölgesine harmanlanıyor. Bu nedenle yüz kadrajda ne kadar küçükse sonuç o kadar zorlanıyor. Yakın planlarda, çevredeki yüz bölümü keskin kaldığında yumuşaklık daha belirgin hale geliyor.
Bu sorunu azaltmanın iki yolu var ve ikisinin de bir bedeli bulunuyor. --use_float16 seçeneğini kaldırmak kaliteyi artırıyor; karşılığında daha fazla VRAM ve daha uzun işlem süresi gerekiyor. Hazırlanan videoyu GFPGAN veya CodeFormer yüz iyileştirme işleminden geçirmek de ağız bölgesini keskinleştiriyor, ancak ek bir işlem adımı getiriyor ve kişinin görünümünü hafifçe değiştirebiliyor.
Rakamlarla kalite: MuseTalk nerede önde, Wav2Lip nerede kazanıyor?
MuseTalk'ın öne çıktığı nokta ham senkron doğruluğundan çok görüntü kalitesi. MuseTalk teknik raporu, HDTF veri setinde FID skorunu MuseTalk için 6.43 olarak veriyor. Bu değer DI-Net'te 7.27, VideoRetalking'de 10.93 ve Wav2Lip'te 11.21.
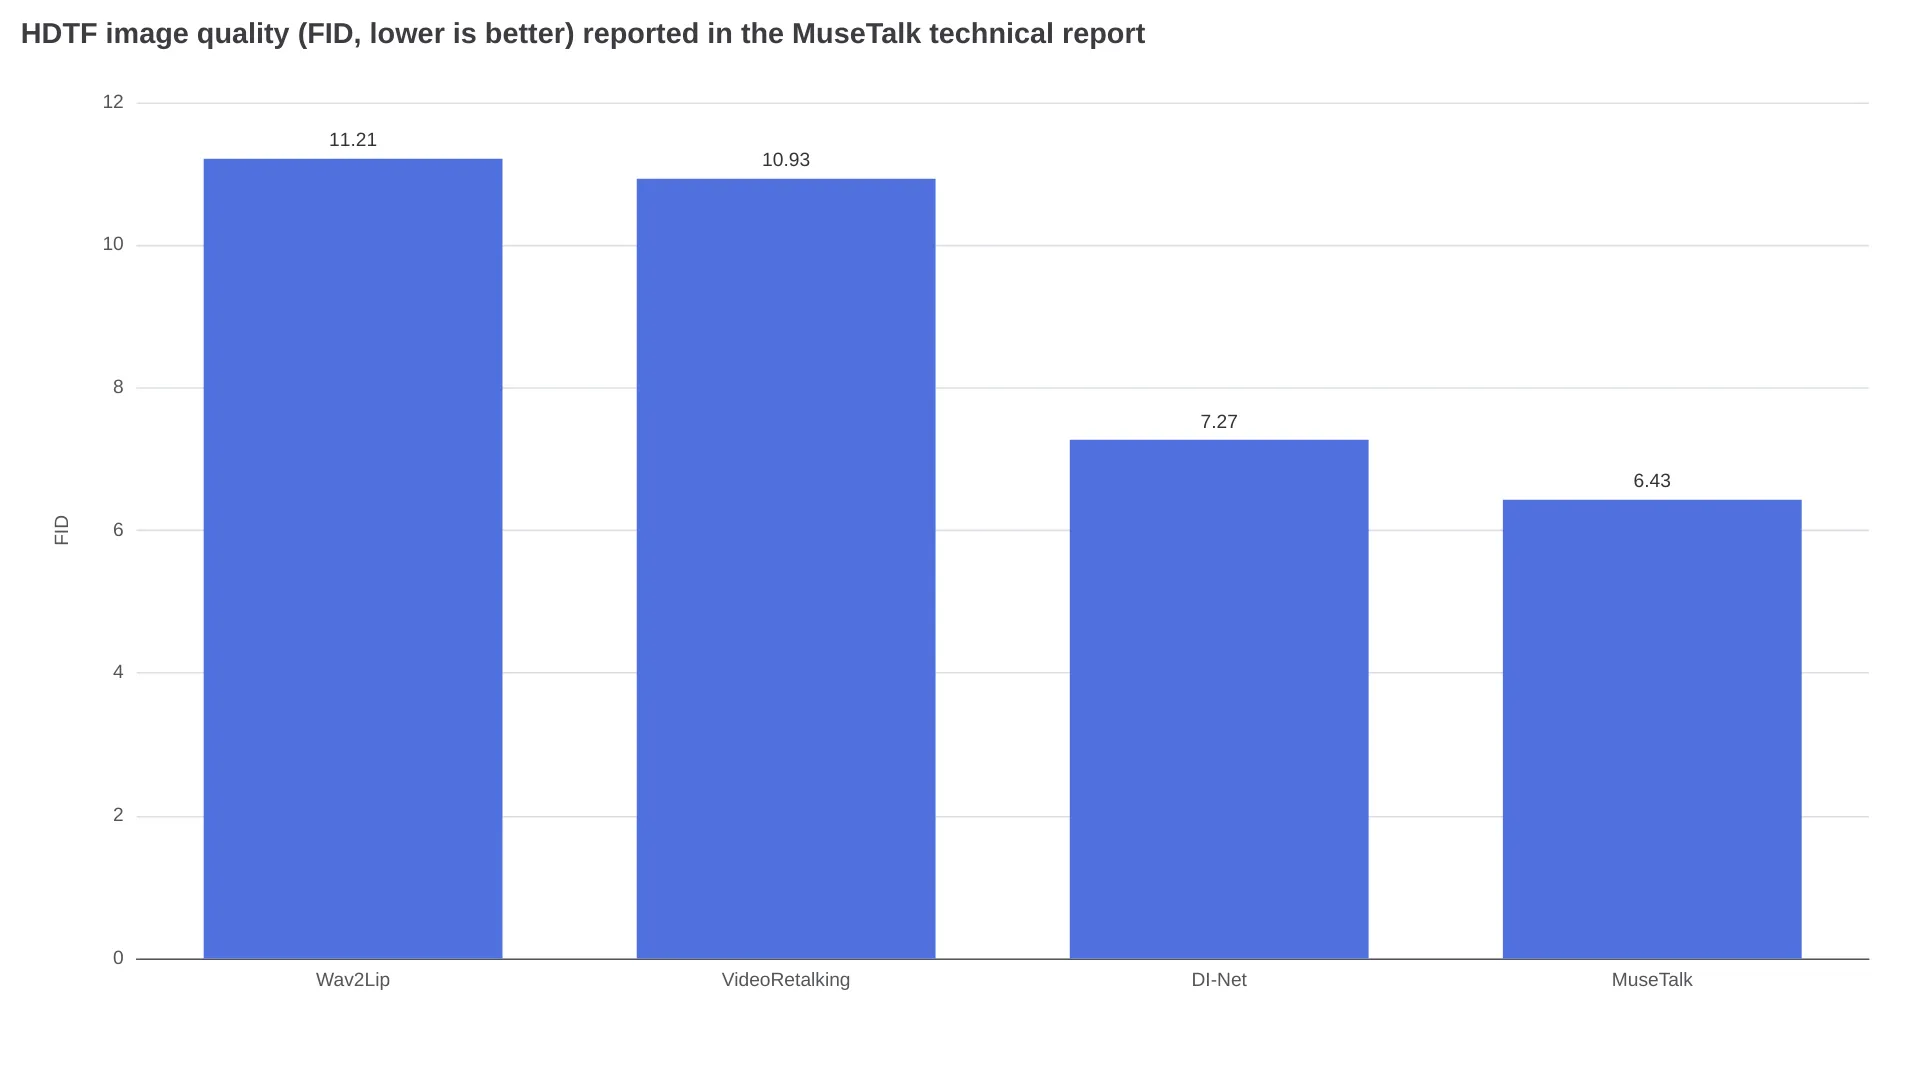
Senkron metriğine geçtiğinizde sıralama değişiyor. Aynı raporda Wav2Lip için LSE-C skoru 7.46, MuseTalk içinse 6.53. Buna karşılık kimlik benzerliğinde MuseTalk, 0.8225 CSIM ile 0.8184 değerindeki Wav2Lip'in biraz önünde. Başka bir deyişle eski GAN modeli dudak takibinde, MuseTalk ise görüntü sadakatinde daha iyi sonuç veriyor. Raporun kullanıcı çalışması da hiçbir başlıkta olağanüstü bir tablo çizmiyor: görsel kalite için 5 üzerinden 3.62, kimlik benzerliği için 3.55, dudak senkronu için 3.41.
Bu sonuçları 256x256 sınırıyla birlikte okumak gerekiyor. MuseTalk, ikna edici orta planlar için uygun; 4K yakın planlarda aynı güveni vermiyor.
Bir dakikalık dudak senkronunun maliyeti
Açık kaynak seçeneği asıl avantajını burada gösteriyor. Barındırılan lipsync modellerinde yayımlanan fiyatlar, çıktı süresinin dakikası başına 1,50 dolar ile yaklaşık 8 dolar arasında değişiyor.
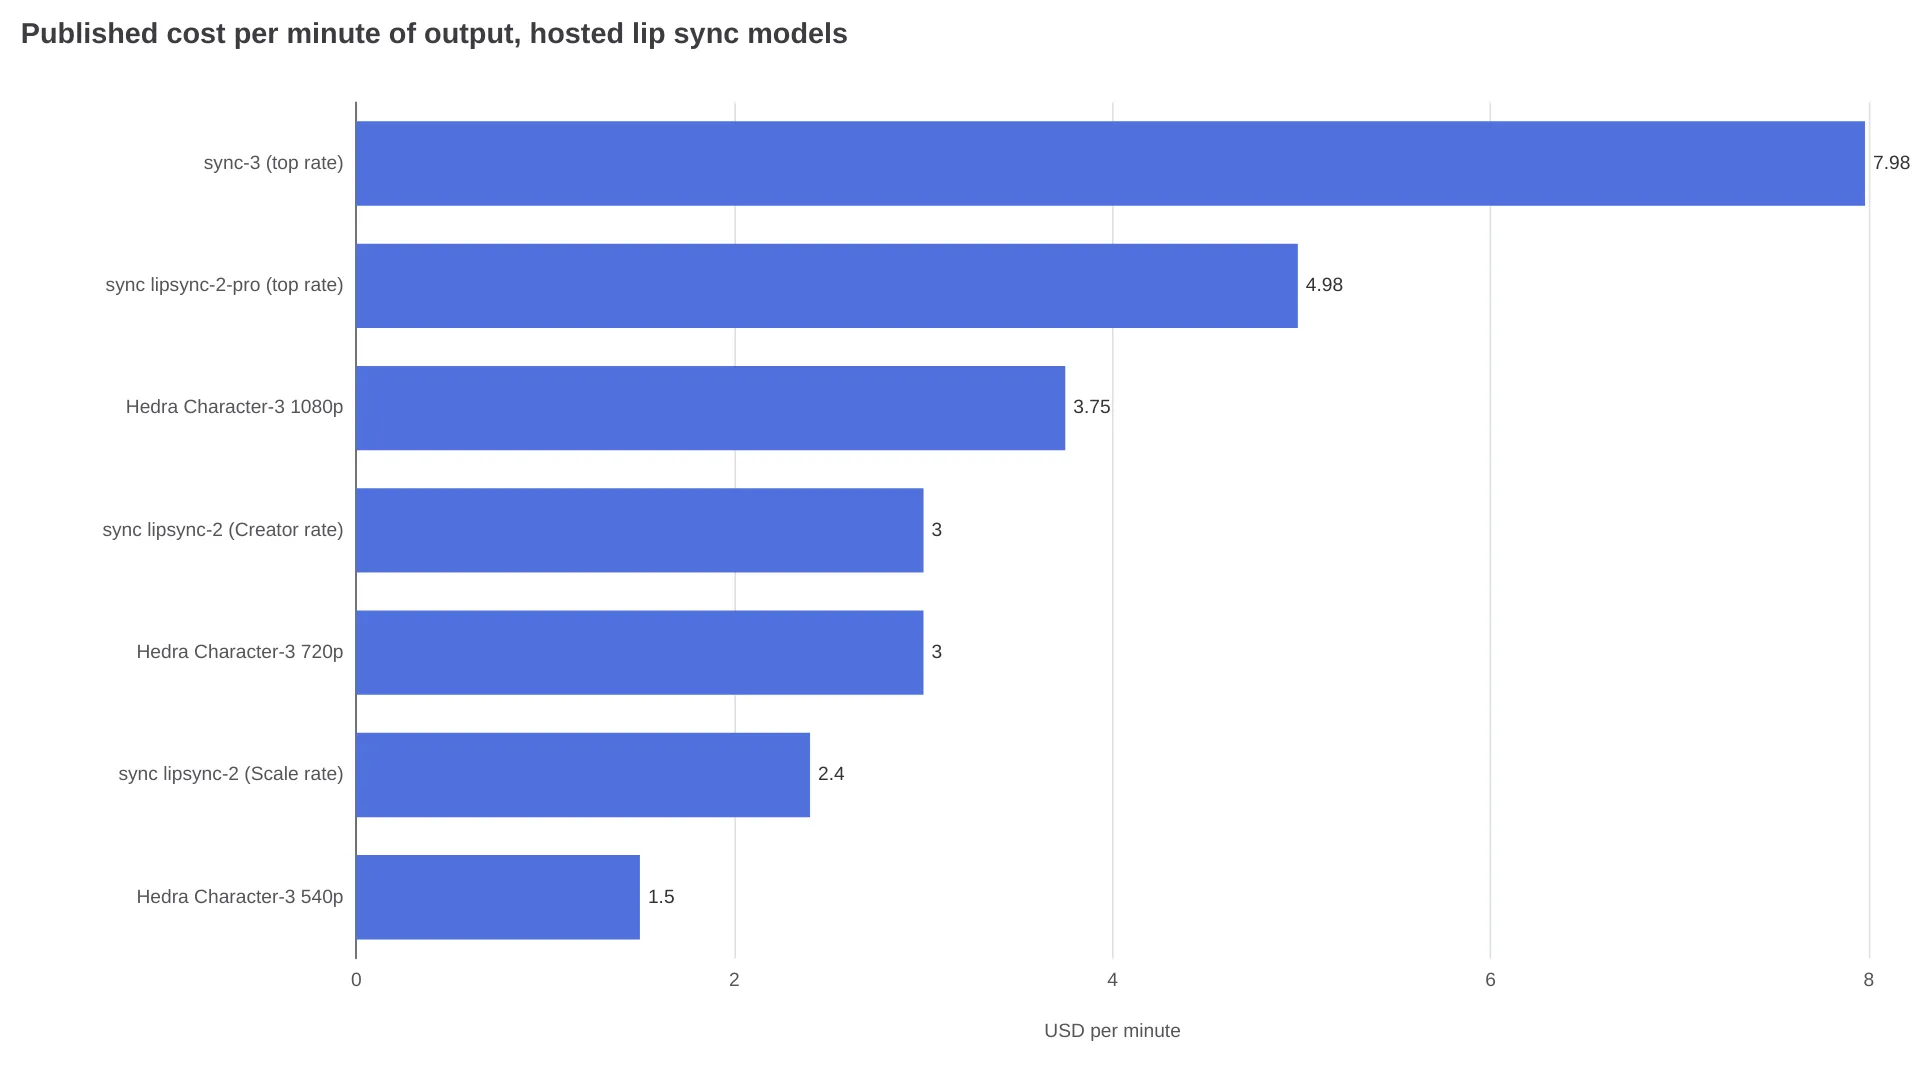
| Yöntem | Yayımlanan ücretlendirme (faturalandırma birimleri farklıdır) | Çıktının dakikası başına | Yüz çözünürlüğü |
|---|---|---|---|
| MuseTalk kendi sunucunuzda, Tesla V100 kiralama | $0.188 / GPU-saat | Klip dakikası başına 2 GPU-dakikası varsayımıyla yaklaşık $0.006 | 256x256 |
| Replicate üzerinde MuseTalk | Çalıştırma başına yaklaşık $0.052; model sayfasına göre tipik çalışma süresi 54 saniye | Dakika başına değil, çalıştırma başına faturalandırılır | 256x256 |
| fal.ai üzerinde MuseTalk | Hesaplama saniyesi üzerinden faturalandırılır | Model sayfasında yayımlanmamış | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — image-to-video; mevcut görüntü için doğrudan alternatif değil | Saniye başına 2,5¢ / 5¢ / 6,25¢ | $1.50 / $3.00 / $3.75 | n/a |
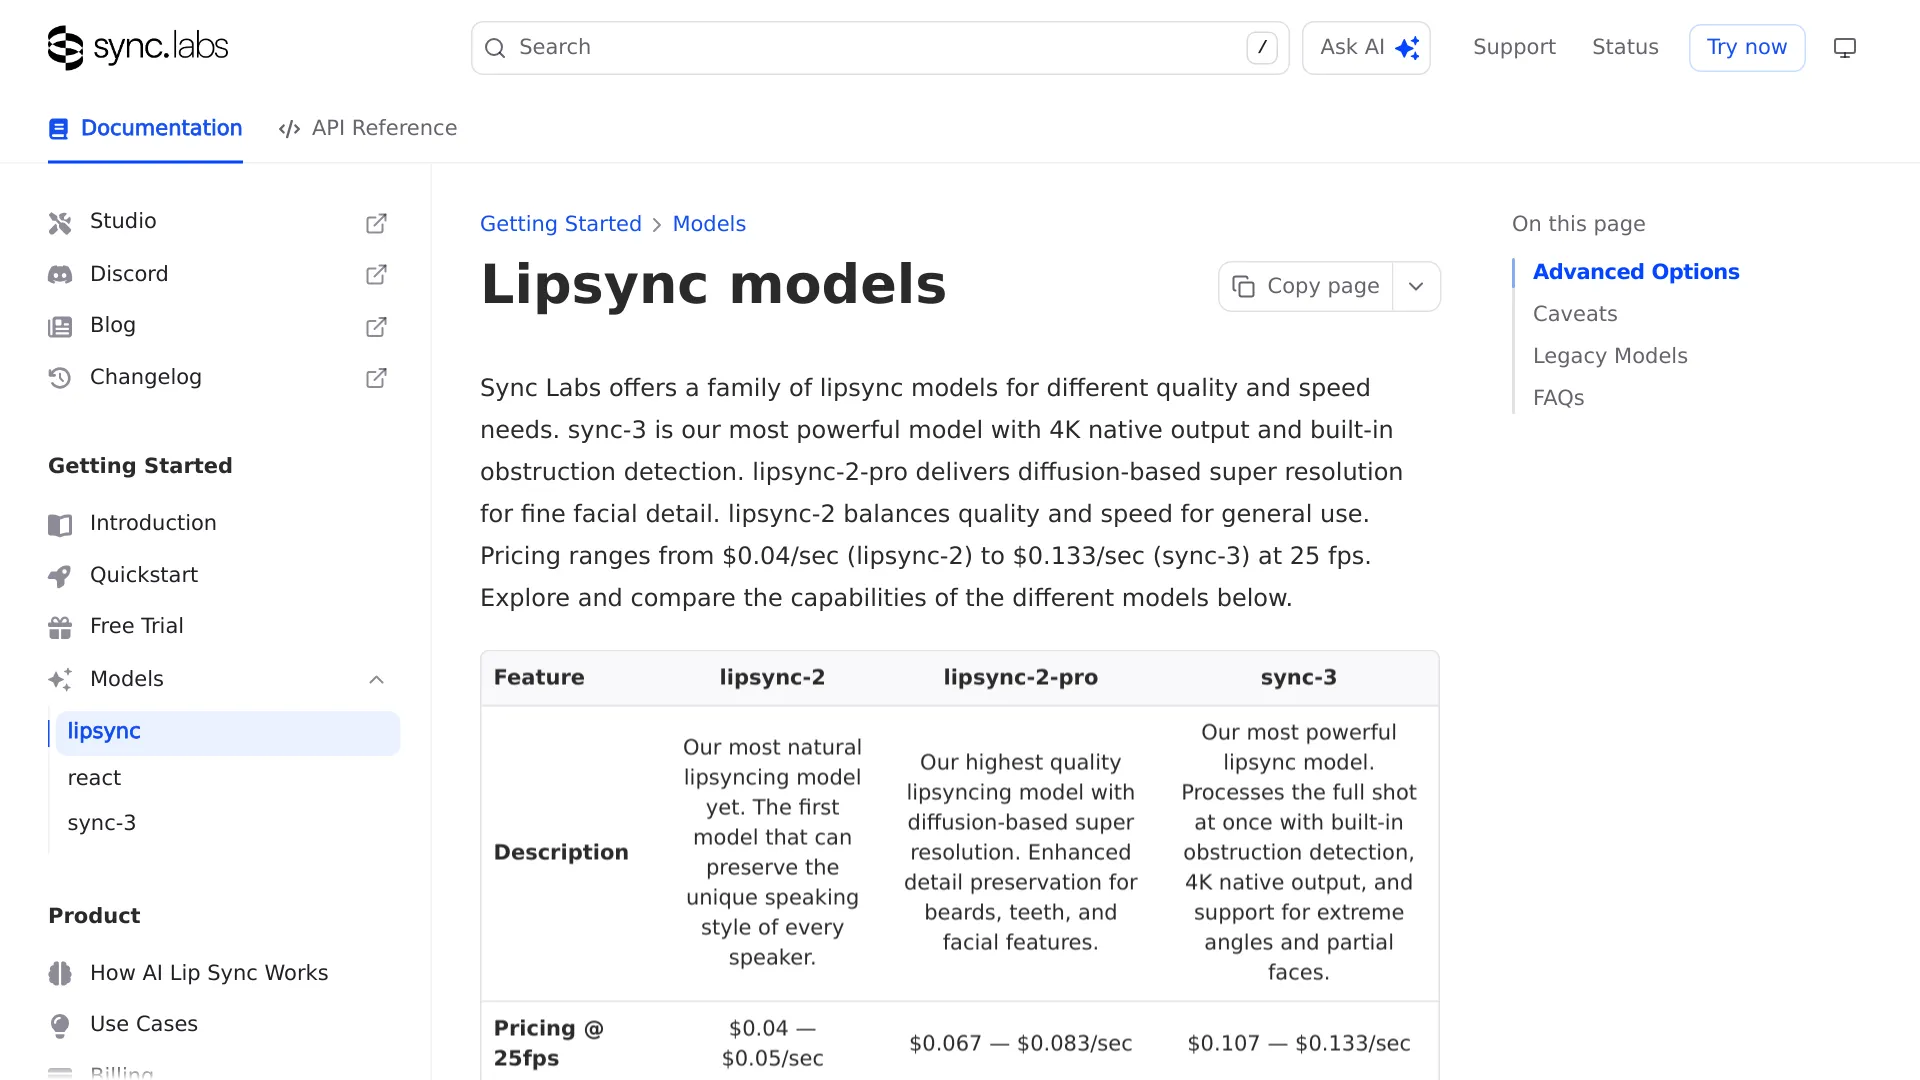
| sync lipsync-2 | 25 fps'te saniye başına $0.04–0.05 | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | Saniye başına $0.067–0.083 | $4.02–$4.98 | 512x512 + detay geçişi |
| sync-3 | Saniye başına $0.107–0.133 | $6.42–$7.98 | Yerel 4K |
Kendi sunucunuzdaki rakam, NexGPU'nun maliyet hesabından geliyor. Bu hesap, bir dakikalık klip için uçtan uca iki dakikalık GPU süresi öngörüyor: inference'ın yanı sıra DWPose tespiti, VAE encode/decode ve FFmpeg mux işlemleri de dahil. V100'ün saatlik fiyatı $0.188 kabul edildiğinde, 100 adet bir dakikalık klip yaklaşık $0.63 GPU maliyeti oluşturuyor; kurulum süresi için de yaklaşık $0.09 ekleniyor. Bunların yalnızca GPU kiralama rakamları olduğunu unutmayın: mühendislik zamanı, depolama ve operasyon giderleri dahil değil.
Bunu bir yerelleştirme iş yüküne uyguladığınızda fark hızla açılıyor. Beş yüz dakikalık dublajlı video, kendi MuseTalk kurulumunuzda yaklaşık $3 GPU kiralama maliyeti çıkarıyor. sync lipsync-2 ile Creator tarifesinde aynı iş yaklaşık $1.200 tutuyor.
Ücretsiz seçenek nerede ücretli hale geliyor?
Dakika başına ödediğiniz ek ücretin karşılığında aldıklarınız oldukça somut:
- Yüz üretim çözünürlüğü. sync model dokümantasyonuna göre lipsync-2 ve lipsync-2-pro, MuseTalk'ın yüz bölgesinin iki katı olan 512x512 çözünürlükte yüz üretiyor. sync-3 ise yerleşik süper çözünürlükle doğrudan 4K çıktı veriyor.
- Zor açılar. Aynı dokümantasyona göre sync-3 profil görünüşlerini, omuz üstü kadrajları ve yüzün kısmen göründüğü sahneleri yerel olarak işleyebiliyor; engelleri de otomatik tespit ediyor. MuseTalk ise her karede yüz tespiti yapıyor. Bu nedenle dönük yüz veya ağzın önündeki el, belgelenmiş sorun noktaları arasında.
- Birden fazla kişinin olduğu videolar. sync'in üç güncel modelinde de aktif konuşmacı tespiti bir seçenek olarak listeleniyor. MuseTalk'ta buna denk bir parametre bulunmuyor.
- Kurulum süresi. Kendi sunucunuzdaki kurulumda bu bedeli bir kez ödüyorsunuz, ancak süre hiç de önemsiz değil.
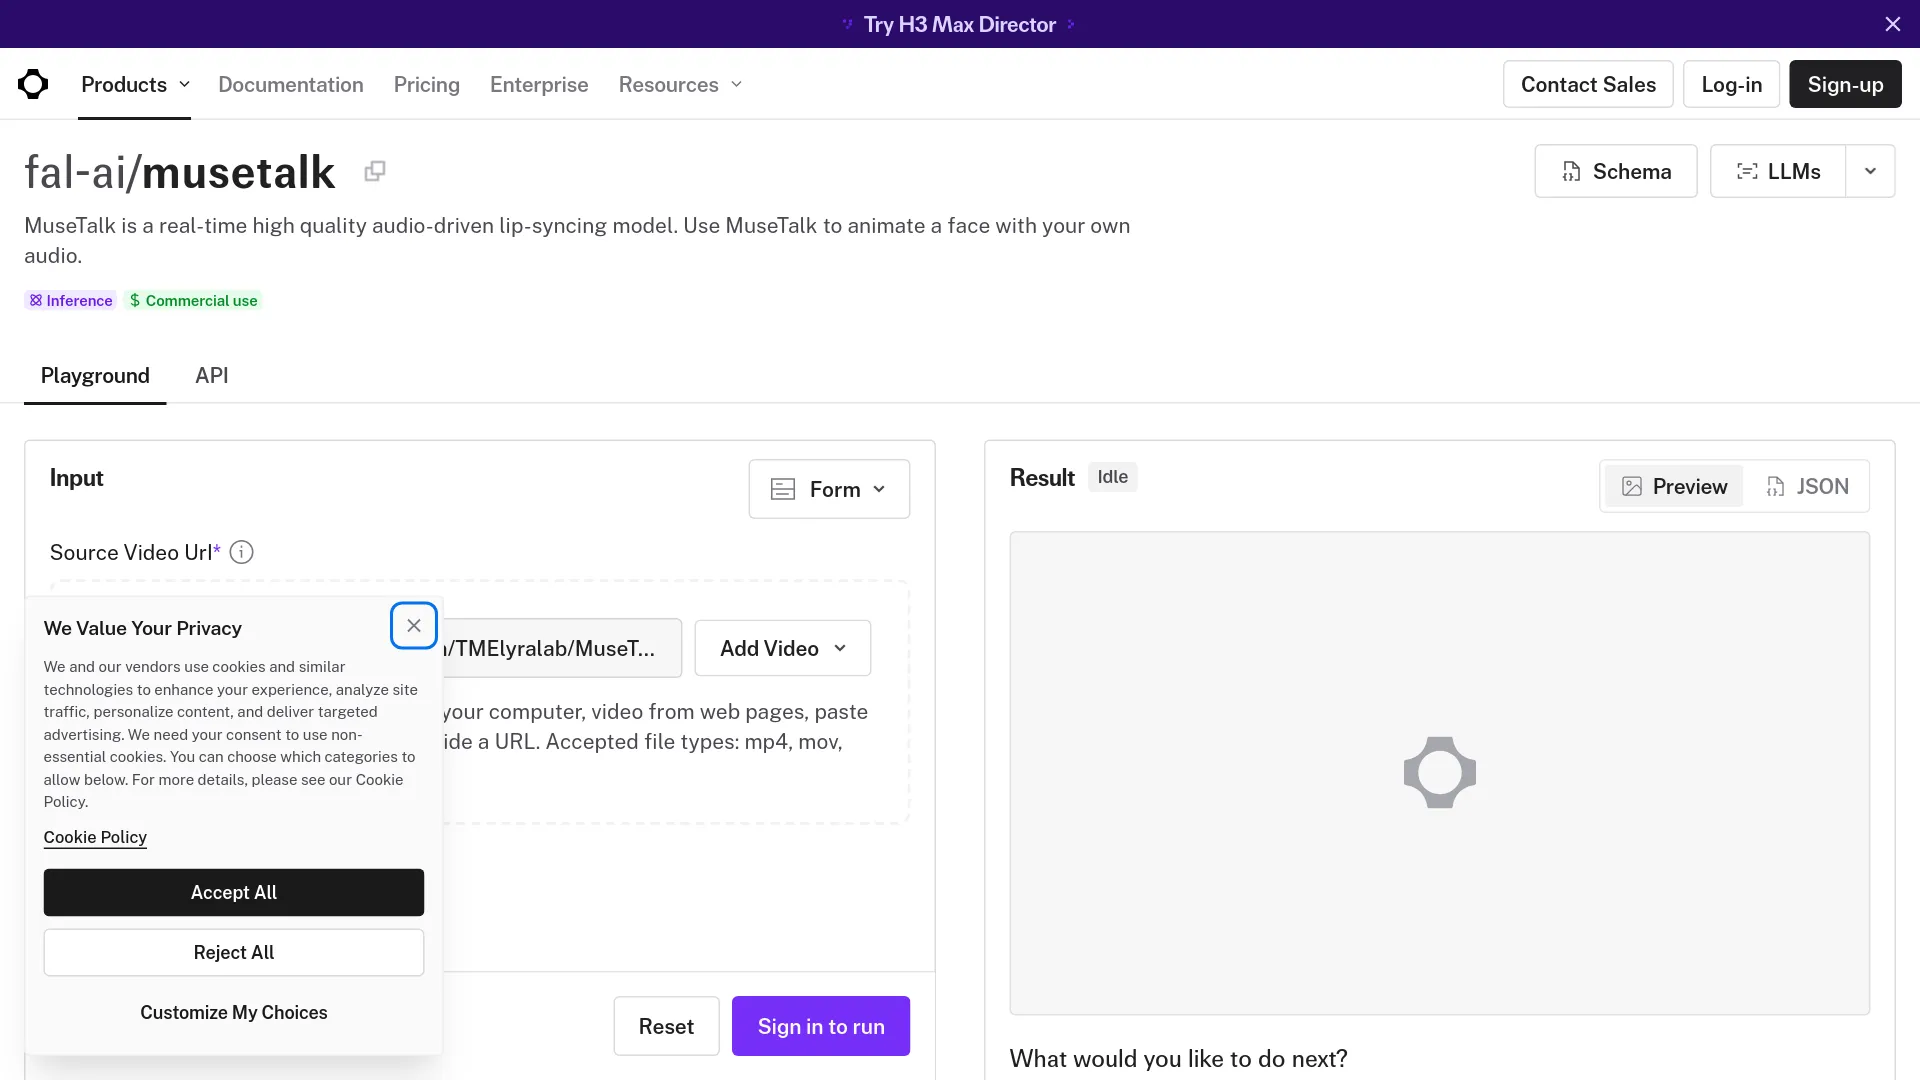
fal.ai MuseTalk sayfası, son maddenin karşılığında ne aldığınızı açıkça gösteriyor: bir kaynak video URL'si, bir ses URL'si ve başka hiçbir şey. Conda ortamı yok, CUDA sürüm sabitlemeleri yok, ağırlık dosyası ağacı yok.
Bağımlılıklarla boğuşmadan MuseTalk kurulumu
Modeli çalıştıranların sık dile getirdiği sorun çıktı kalitesiyle ilgili değil. Asıl problem OpenMMLab yığını. r/StableDiffusion'da iki lipsync modelini karşılaştıran bir kullanıcı, MuseTalk ve LatentSync'i test ettikten sonra durumu şöyle özetlemiş:
"LatentSync ve Musetalk çalışıyor ve performansları benzer... Musetalk'ın kurulumu zahmetli, çünkü OpenMMLab kütüphanelerine bağlı." — u/Traditional_Tap1708, r/StableDiffusion
README'de sabitlenen sürümleri doğrudan pip yerine mim üzerinden kurun:
- Yeni bir conda ortamında Python 3.10 kullanın; PyTorch 2.0.1, torchvision 0.15.2 ve torchaudio 2.0.2 kurulu olmalı.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Daha yeni bir mmcv sürümü, mmdet içe aktarma hatalarının en yaygın nedenidir.- FFmpeg'i
PATHüzerinde bulundurun veffmpeg -versionile doğrulayın. Windows'ta alternatif olarak--ffmpeg_pathparametresini açıkça verebilirsiniz. - Tüm ağırlık ağacını indirmek için
sh download_weights.shçalıştırın. Yalnızca UNet yeterli değil; bu script sd-vae-ft-mse, Whisper, DWPose'undw-ll_ucoco_384.pthdosyasını ve BiSeNet yüz ayrıştırma ağırlıklarını da indiriyor. Eksik bir dosya çoğu zaman anlaşılır bir hata yerine yüz tespiti veya harmanlama sorunu olarak ortaya çıkıyor. - Kaynak videoyu
ffmpeg -i input.mp4 -r 25 output.mp4komutuyla 25 fps'e dönüştürün. Repository, model bu kare hızında eğitildiği için 25 fps girdiyi öneriyor. Zamanlama kaymasının en yaygın nedeni de kare hızındaki uyumsuzluk. configs/inference/test.yamldosyasında video ve ses yollarını belirtin, ardındanpython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15komutunu çalıştırın.
Aynı yüzle tekrar tekrar üretim yapacaksanız configs/inference/realtime.yaml içinde preparation: true değerini bir kez etkinleştirin. coords.pkl, latents.pt ve maske dosyaları results/v15/avatars/ altında önbelleğe alındıktan sonra değeri yeniden false yapın. --skip_save_images seçeneğinin etkisi göründüğünden daha büyük: PNG dosyalarını diske yazmak, bir noktadan sonra modelin kendisi yerine darboğaz haline gelebiliyor.
MuseTalk 1.5 mi, 1.0 mı: hangi ağırlıkları indirmelisiniz?
1.5'i kullanın. Repository, 28 Mart 2025 tarihli en yeni sürüm olarak bunu listeliyor. Ayrıca algısal, GAN ve senkron kayıplarıyla birlikte iki aşamalı eğitimin daha iyi netlik, kimlik tutarlılığı ve dudak-konuşma hizalaması sağladığını belirtiyor.
1.0'ı elde tutmak için tek güçlü neden bbox_shift seçeneği. Bu parametre yalnızca o sürümde bulunuyor ve maske sınırını dikey olarak hareket ettiriyor: pozitif değerler ağzı daha geniş açıyor, negatif değerler kapatıyor.
Önce varsayılan ayarlarla bir kez çalıştırın; script videonuz için kullanılabilir aralığı yazdıracaktır. README'deki örnekte aralık [-9, 9] çıkıyor ve en uygun değer -7 olarak belirleniyor. Daha sonra, elde ettiğiniz aralık içinde yeniden render alın. Ağız fazla abartılı görünüyorsa negatife, neredeyse hiç açılmıyorsa pozitife doğru ilerleyin.
Karşılaşacağınız sorunlar ve ayarlarla çözülebilenler
| Belirti | Neden | Çözülebilir mi? |
|---|---|---|
| İşlem duruyor, yüz bulunamıyor | Dönük, kapalı veya görünmeyen yüzün bulunduğu tek bir kare | Evet. Sorunlu bölümü kırpın veya çıkarın |
| Ağız neredeyse hiç hareket etmiyor | Ses müziğin altında kalıyor veya maske sınırı fazla yukarıda | Evet. Vokali ayırın; v1.0'da pozitif bbox_shift kullanın |
| Video ortasında dudaklar senkronu kaybediyor | Kaynak video 25 fps değil | Evet. İşlemden önce dönüştürün |
| Keskin yüz üzerinde ağız bulanık kalıyor | Yüz, 256x256 bölge için kadrajda fazla küçük | Kısmen. Daha sıkı kırpın, fp16'yı kapatın, yüz iyileştirme ekleyin |
| Belirgin ek yeri, bıyık korunmuyor | Yüzün alt kısmı sentezlenirken kimlik detayları değişiyor | Hayır. Modelin bilinen bir sınırlaması |
| Kareler arasında titreme | Kareler tek tek üretiliyor | Kısmen. Repository, v1.5'in iki aşamalı eğitimiyle tutarlılığın arttığını belirtiyor |
| Çizgi film veya stilize yüz başarısız oluyor | Eğitim dağılımı gerçek yüzlerden oluşuyor | Hayır |
| Sabit konuşmacı üzerinde enerjik ses | MuseTalk kafa hareketine veya yüz ifadesine dokunmuyor | Hayır. Kaynak videoyu yeniden çekin veya konuşmacıyı değiştirin |
Düşük VRAM ile test yapan bir kullanıcı MuseTalk'ın "7 saniyelik ses için 171 saniye" sürdüğünü ve modelin "yalnızca gerçekçi görüntülerle çalıştığını" belirtti (u/Bartholomheow, r/StableDiffusion). Öte yandan "gerçek zamanlı" ifadesi uçtan uca gecikmeyi değil, avatar hazırlığından sonraki sürekli işleme hızını anlatıyor. r/LocalLLaMA'da konuşan kafa uygulaması geliştiren bir kişi de MuseTalk için "hazırlık süresi çok uzun" diyerek (u/lonyPorgrammer) modelin etkileşimli kullanım senaryosuna uymadığını belirtti.
İşinize hangi lipsync yöntemi uyuyor?
| Yöntem | Ne zaman seçilmeli? | Temel ödünleşim |
|---|---|---|
| Kendi sunucunuzda MuseTalk | Yüksek hacim ve uygun kaynak video: yerelleştirme taslakları, binlerce ses klibinde aynı yüzün tekrar kullanıldığı interaktif avatarlar, kurum içi eğitim videoları | Kurulum dakikalar değil saatler alıyor; işlem hızı kiraladığınız GPU'ya bağlı |
| Barındırılan MuseTalk (Replicate, fal.ai) | Az sayıda klip üretirken veya kuruluma yatırım yapmadan önce kendi görüntünüz üzerinde kalite testi yaparken | Aynı 256x256 sınırı, iki endpoint şemasında da avatar önbelleği seçeneği yok, çalıştırma başına faturalandırma |
| Ücretli lipsync modeli (sync-3, lipsync-2-pro) | Müşteriye sunulacak çıktı, büyük yakın planlar, profil açıları, engeller, birden fazla konuşmacı, 4K teslim | İşin dakikası başına $4–$8 ve görüntüler altyapınızın dışına çıkıyor |
Resmî hız değerini tekrarlamak için V100, canlı yayın yapacaksanız 4090 kiralayın. Barındırılan endpoint seçeneğini değerlendirenler için her iki platformu da Replicate incelememizde ve fal.ai incelememizde daha ayrıntılı ele aldık.
MuseTalk lipsync SSS
MuseTalk 6 GB veya 8 GB GPU'da çalışır mı?
Evet. README, FP16 modunda test edilmiş 4 GB RTX 3050 Ti dizüstü GPU'sunu belgeliyor; dolayısıyla temel inference sınırlı VRAM'e sığıyor. Pratikteki daha büyük sorun işlem hızı.
256x256 çıktı çözünürlüğü mü?
Hayır. Bu, kaynak çözünürlüğünü ve kare hızını koruyan videoya geri harmanlanan, düzenlenebilir yüz bölgesinin boyutu.
MuseTalk çizgi film veya anime yüzlerinde çalışır mı?
Güvenilir biçimde çalışmıyor. Model gerçek konuşan kafa videolarıyla eğitildi ve stilize girdileri test eden kullanıcılar tutarsız sonuçlar bildiriyor.
"30 fps gerçek zamanlı" ifadesi ön işleme adımlarını da kapsıyor mu?
Hayır. Bu değer, avatar hazırlığından sonraki Tesla V100 üretim hızını ifade ediyor. Yüz tespiti, latent kodlama ve ilk önbellekleme işlemi daha önce gerçekleşiyor.
MuseTalk mı, LatentSync mi?
Projede gecikme ve hacim belirleyiciyse MuseTalk'ı tercih edin; tek adımlı inference ve önbelleğe alınmış avatarlar klip başına maliyetin büyük bölümünü ortadan kaldırıyor. Yukarıda alıntıladığımız ve iki modeli de deneyen r/StableDiffusion kullanıcısı, performanslarını benzer bulmuş. Bu durumda karar noktası görüntü kalitesinden çok işlem hızı oluyor.
MuseTalk ticari amaçla kullanılabilir mi?
Repository kodu MIT lisansıyla yayımlıyor, ancak bağımlılık zincirindeki lisanslar aynı değil. Whisper, VAE, DWPose, BiSeNet yüz ayrıştırma ve SyncNet kendi lisanslarıyla geliyor; repository örnek veriler için de ayrı kısıtlamalar bulunduğunu belirtiyor. Ürünü yayına almadan önce her birini kontrol edin.
Bu fiyat seviyesinde hâlâ çözülemeyen ödünleşim
MuseTalk, neredeyse hiçbir maliyet ödemeden işin büyük bölümünü hallediyor. Fakat kimlik ayrıntıları zorlandığında modelin sınırları ortaya çıkıyor: bıyıklar, dudakların tam şekli, kadrajı dolduran bir yüz veya cümle ortasında başını çeviren bir konuşmacı.
Çoğu ekip için doğru cevap tek bir araç kullanmak değil. Yüksek hacimli işler için MuseTalk, tam ekran izlenecek sahneler içinse ücretli bir model kullanmak daha mantıklı.
İlgili okumalar
- Higgsfield AI incelemeleri ve API erişimine kıyasla fiyatlandırma
- Kokoro 82M TTS yerel kurulum rehberi; MuseTalk'ın kullandığı ses kaydını üretmek için
- Wan 2.2 Animate rehberi