 AIREITER
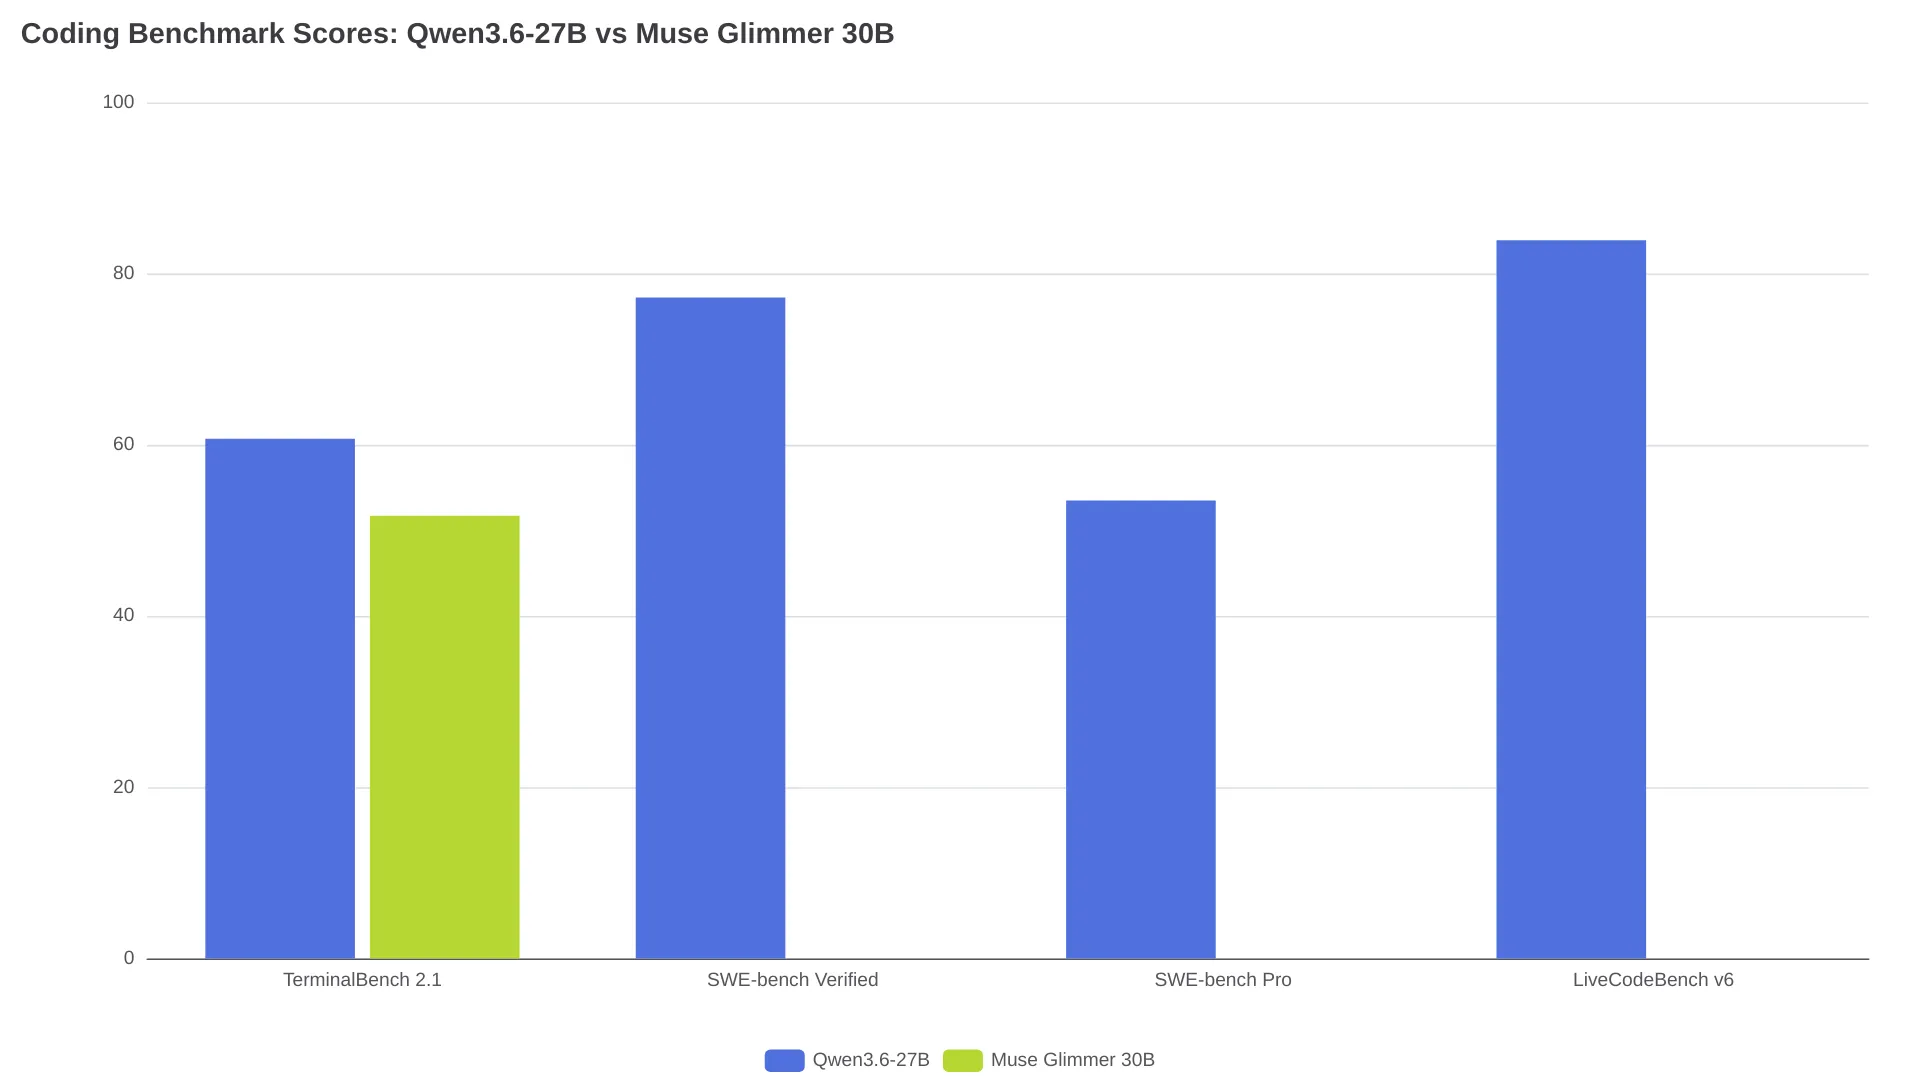
Yerelde çalıştırılabilen kodlama modellerinde seçim yalnızca benchmark puanından ibaret değil: Elinizde tek bir GPU varsa, sığdırabildiğiniz bağlam penceresi sonucu doğrudan değiştirebilir. Qwen3.6-27B, Nisan 2026'da Hugging Face model kartındaki kapsamlı benchmark tablosuyla yayımlandı. Meta'nın açık ağırlıklı Muse Glimmer 30B modeli ise Ağustos 2026'da geldi ve yerel LLM topluluğu kısa süre içinde ikisini karşılaştırmaya başladı. Manşet rakamlar Qwen lehine: TerminalBench 2.1'de 60,7'ye karşı 51,7 alıyor; resmi SWE-bench Verified sonucu da 77,2. Buna karşılık Glimmer'ın tek GPU'da sağladığı VRAM avantajı, hangi modeli çalıştırabileceğinizi belirleyebiliyor.
TerminalBench 2.1'de Qwen'in 9 Puanlık Üstünlüğü
TerminalBench; araç kullanımı ve uzun oturumlarda bağlamı koruma dahil olmak üzere, çok adımlı terminal ajanlarının güvenilirliğini ölçüyor. Bağlantılı topluluk tartışmalarında, iki model için mevcut doğrudan kodlama ajanı karşılaştırması olarak çoğunlukla TerminalBench 2.1 sonuçlarına atıf yapılıyor.
10-11 Ağustos 2026 tarihli r/LocalLLaMA tartışmalarında paylaşılan topluluk kaynaklı TerminalBench 2.1 skorları şöyle:
| Model | TerminalBench 2.1 | Kaynak türü |
|---|---|---|
| Qwen3.6-27B | 60,7 | Topluluk bildirimi |
| Muse Glimmer 30B | 51,7 | Topluluk bildirimi |
| Gemma 4 31B | 43,4 | Topluluk bildirimi |
Burada önemli bir çekince var: TerminalBench yalnızca temel modeli değil, model ve test altyapısı birleşimini değerlendiriyor. Qwen3.6-27B'nin resmi kartında Harbor/Terminus-2 altyapısı; 3 saat zaman aşımı, 32 CPU, 48 GB RAM, 80K maksimum çıktı, 256K bağlam ve beş çalıştırmanın ortalamasıyla belirtiliyor. Glimmer'ın puanı farklı ya da daha az optimize edilmiş bir altyapı yapılandırmasından gelmiş olabilir. Dolayısıyla 9 puanlık fark, kullandığınız ajan kurulumuna göre daralabilir veya büyüyebilir.
Resmi Kodlama Benchmark'ları: Qwen'de Var, Glimmer'da Henüz Yok
Qwen3.6-27B'nin model kartında yayımlanmış resmi benchmark sonuçları bulunuyor. Bu karşılaştırma için incelenen bağlantılı kaynaklarda, Ağustos 2026 itibarıyla Muse Glimmer için resmi bir SWE-bench, LiveCodeBench veya benzer ajan tabanlı kodlama benchmark'ına rastlanmadı. Bu nedenle yayımlanmış kanıtlar Qwen tarafında daha güçlü; ancak iki modelin resmi ve eşdeğer koşullardaki doğrudan karşılaştırması henüz yok.
Qwen'in resmi kodlama benchmark sonuçları:
| Benchmark | Qwen3.6-27B (resmi) |
|---|---|
| SWE-bench Verified | 77,2 |
| SWE-bench Pro | 53,5 |
| SWE-bench Multilingual | 71,3 |
| Terminal-Bench 2.0 | 59,3 |
| LiveCodeBench v6 | 83,9 |
Bunlar üretici tarafından yayımlanan sonuçlar. Model kartına göre SWE-bench değerlendirmelerinde Qwen'in dahili bash/dosya düzenleme iskeleti, 1,0 temperature, 0,95 top-p ve 200K bağlam penceresi kullanılıyor. SWE-bench Pro sonuçları, Qwen'in sorunlu maddeleri düzelttiği iyileştirilmiş bir görev seti üzerinde hesaplanmış; bu yüzden herkese açık liderlik tablosundaki değerlerle bire bir karşılaştırılamayabilir. morphllm tarafından yapılan üçüncü taraf inceleme de sonuçların Qwen'in kendi ajan iskeletine dayandığını ve bağımsız yeniden üretimin sınırlı olduğunu vurguluyor.
Yerel Kodlama Testlerinde Ortaya Çıkanlar
M5 Pro'da OpenCode Q4 Testi
Bir geliştirici, Muse Glimmer'ı Q4 kuantizasyonunda (Unsloth derlemesi) 48 GB RAM'li bir M5 Pro üzerinde OpenCode aracılığıyla çalıştırdı. Model yaklaşık 20 GB RAM kullandı ve saniyede 17 token üretti. Testin sonucu şöyle özetlendi:
"Genel olarak Qwen3.6 27B'nin altında kalıyor" - u/curiousily_
Frontend ve backend kodlama çıktıları Qwen'in gerisinde değerlendirildi. Bununla birlikte yazar olumlu bir noktaya dikkat çekti: Muse Glimmer, test sırasında hiçbir araç çağrısında hata vermedi. Yapılandırmada reasoning döngüleri veya uzun düşünme süreci yoktu; bu durum Glimmer'ın performansını sınırlamış olabilir.
max_tokens Sınırı Beklenenden Daha Kritik
r/LocalLLM üzerindeki başka bir testte, çıktı token bütçesi düşük tutulduğunda Muse Glimmer'ın olduğundan çok daha zayıf görünebildiği fark edildi. Model, görünür çıktıyı üretmeden önce token bütçesini reasoning sürecinde tüketebiliyor; sonuçta boş ya da kesilmiş yanıtlar ortaya çıkıyor. max_tokens değerinin yükseltilmesiyle test altyapısında geçen görev sayısı, model değiştirilmeden 6/13'ten 11/13'e çıktı; yani geçiş oranı neredeyse iki katına ulaştı. Glimmer'ı varsayılan çıktı limitleriyle test ediyorsanız, modeli değil yapılandırmanızı ölçüyor olabilirsiniz.
Hermes ile Terminal Döngüsüne Girme Sorunu
Başka bir kullanıcı, Hermes ajan altyapısıyla birlikte kullanıldığında Muse Glimmer'ın aşırı sayıda terminal komutunda takılı kaldığını bildirdi. Aynı kurulumda Qwen3.6-27B ile böyle bir davranışla karşılaşmadığını belirtti. Bu anekdot, mevcut TerminalBench farkıyla yön olarak tutarlı; ancak sorunu Hermes yapılandırmasından bağımsız biçimde doğrudan modele bağlamıyor.
Token Verimliliğinde Niteliksel Avantaj
u/NoFaithlessness951'in benchmark galerisindeki paylaşımı, verimlilik açısından dikkat çekici bir iddia ortaya koydu:
"Qwen kadar akıllı değil ama görev başına çok daha az token kullanıyor." - u/NoFaithlessness951
Bu, kontrollü bir görev başına token/başarı ölçümü değil; topluluktan gelen niteliksel bir gözlem. Eşleştirilmiş görevler, başarı oranları ve gecikme verileriyle Glimmer'ın Qwen'e karşı token avantajını ölçen doğrudan bir çalışma bulunmuyor. Bu verimlilik iddiasını kanıtlanmış bir gerçek olarak değil, umut vadeden bir işaret olarak görmek daha doğru.
VRAM ve Bağlam Penceresi: Glimmer'ın Donanım Kozu
Muse Glimmer'ın net biçimde öne geçtiği yer burası. r/LocalLLaMA üzerindeki bir testte, Q4_K_XL kuantizasyonlu Muse Glimmer 30B'nin; DFlash speculative decoding, multimodal projector ve tam F16 KV cache ile tek RTX 3090 üzerinde yaklaşık 22-23 GB'a sığdığı gösterildi. Bu yapılandırmada 262.144 tokenlik bağlam penceresi ayarlanmıştı.
Aynı RTX 3090 ve aynı Q4_K_XL kuantizasyonunda tablo şöyle:
| Model | F16 KV Bağlamı | Q8 KV Bağlamı | Kullanılan VRAM |
|---|---|---|---|
| Muse Glimmer 30B | 262.144 | Yok | ~22-23 GB |
| Qwen3.6-27B | 70.000 | 125.000 | 24 GB'a sığıyor |
| Gemma 4 31B | 52.000 | 81.000 | 24 GB'a sığıyor |
Testi yapan kişi, büyük depo bağlamını prompt içine alan iş akışları için Qwen'in 70K F16 bağlamını "sınırda kullanılamaz" olarak nitelendirdi.
Bu RTX 3090 kurulumunda bildirilen Muse Glimmer performansı:
- Üretim: Saniyede 64-124 token; kod ve düz metne göre değişiyor
- Prompt işleme: ~1.400 token/saniye
- Uzun bağlamdan bilgi getirme: İlk denemede ~150K token seviyesinde iki iğneli samanlık testini geçti
Qwen3.6-27B, aynı donanımda daha geniş bağlam için ya Q8 KV cache sıkıştırmasına ihtiyaç duyuyor; bu da çıktı kalitesinden bağlam uzunluğu uğruna ödün vermek anlamına geliyor; ya da daha güçlü bir makineye offload edilmesi gerekiyor. Testi yapan kişi, tam bağlam gerektiğinde Qwen'i çok daha pahalı bir cihaz olan DGX Spark'a taşıdığını bildirdi.
Daha üst seviye donanımda, DGX Spark üzerindeki Qwen3.6-27B NVFP4 derlemesi; kie.ai'nin benchmark analizine göre 128K'ye kadar bağlamlarda tek oturumda saniyede 28-33 token üretti. RTX 5090 üzerindeki Unsloth Muse Glimmer Q5_K_M derlemesinin ise yamalanmış bir llama.cpp DFlash yolu üzerinden kod yaması üretiminde saniyede 220-253 token seviyesine ulaştığı bildirildi.
Hangi Modeli Çalıştırmalısınız?
| Senaryonuz | Tercih | Neden |
|---|---|---|
| Yalnızca kodlama, tek seferlik üretim | Qwen3.6-27B | Daha güçlü yayımlanmış kodlama benchmark kanıtları; mevcut TerminalBench 2.1 topluluk karşılaştırmasında önde |
| Tek 24 GB GPU'da geniş bağlamlı ajan tabanlı kodlama | Muse Glimmer 30B | Aynı donanımda Qwen'in 70K'sine karşı 262K F16 bağlam (Q4_K_XL/DFlash kurulumu) |
| Uzun soluklu terminal görevleri | Qwen3.6-27B | TerminalBench 2.1'de 60,7'ye karşı 51,7; Glimmer için ajan altyapısında döngüye girme topluluk bildirimi |
| Yüksek hacimli, maliyet duyarlı işler | Muse Glimmer 30B (olası) | Bir topluluk raporu görev başına daha az token kullanımına işaret ediyor; başarı başına maliyet için eşleştirilmiş karşılaştırma yok |
| Geniş bağlamla depo düzeyinde kodlama | Muse Glimmer 30B (VRAM sınırlıysa) | Qwen, 24 GB üzerinde geniş bağlam için Q8 KV sıkıştırması veya çoklu GPU gerektiriyor |
| Donanım kısıtı olmadan en yüksek kodlama doğruluğu | Qwen3.6-27B | Daha güçlü yayımlanmış benchmark'lar ve resmi skorlar |
Sık Sorulan Sorular
Muse Glimmer'ın resmi bir SWE-bench skoru var mı?
Hayır. Bu karşılaştırma için incelenen kaynaklarda, Ağustos 2026 itibarıyla Muse Glimmer 30B için resmi SWE-bench, LiveCodeBench veya TerminalBench sonucu bulunamadı. 51,7'lik TerminalBench 2.1 skoru, Meta'nın resmi değerlendirmesinden değil Reddit başlıklarındaki topluluk testlerinden geliyor.
İki model de tek RTX 3090'da çalışır mı?
Evet. Q4_K_XL Muse Glimmer 30B, tam F16 KV cache ve 262K bağlamla ~22-23 GB'a sığıyor. Q4_K_XL Qwen3.6-27B de sığıyor; ancak aynı GPU'da F16 bağlamı 70K ile sınırlı, Q8 KV cache sıkıştırmasıyla ise 125K'ye çıkıyor.
Muse Glimmer kodlama görevlerinde sansürlü mü?
Bir kullanıcı, Muse Glimmer'ın Python fare kontrol kodunda hata ayıklama konusunda yardımcı olmayı reddettiğini ve bunu olası bir güvenlik endişesi olarak çerçevelediğini bildirdi. Bu, sistem promptu ve yapılandırması belirtilmemiş tek bir anekdot. Davranışın modelden mi yoksa çıkarım kurulumundan mı kaynaklandığını belirlemek için yeterli değil.
Ajan tabanlı kodlama iş akışları için hangisi daha iyi?
TerminalBench skorları ve topluluk raporlarına göre Qwen3.6-27B, uzun soluklu terminal ajanı görevlerinde daha güvenilir. Muse Glimmer 30B ise VRAM verimliliği sayesinde kısıtlı donanımda daha uygulanabilir bir seçenek ve görev başına daha az token üretebilir. Bu durum yüksek hacimli ajan döngülerinde maliyet ile gecikmeyi düşürebilir; ancak henüz bunu ölçen kontrollü bir karşılaştırma yok.
Muse Glimmer ile kodlama için hangi max_tokens değerini kullanmalıyım?
Cömert bir çıktı bütçesi belirleyin. Bir testte, düşük max_tokens sınırlarının Glimmer'ın görünür çıktı üretmeden önce reasoning sürecinde bütçesini bitirmesine yol açtığı görüldü. Böylece boş veya kesilmiş yanıtlar, başarısızlık gibi görünüyordu. Limit yükseltildiğinde test altyapısında geçen görev sayısı 6/13'ten 11/13'e çıktı. Qwen3.6-27B model kartı genel sorgular için 32.768, zor benchmark görevleri için 81.920 token öneriyor; Meta kendi rehberini yayımlayana kadar Glimmer için de aynı çıktı bütçesi makul bir başlangıç noktasıdır.