 AIREITER
Modal’da çok düğümlü bir işin fiyatı, ayrı bir küme aboneliğine göre değil, kullanılan toplam kaynaklara göre belirleniyor. Modal Clusters genel kullanıma açık olsa da faturayı oluşturan kalemler her konteynerin tükettiği GPU, CPU, bellek, depolama ve ağ kaynakları.
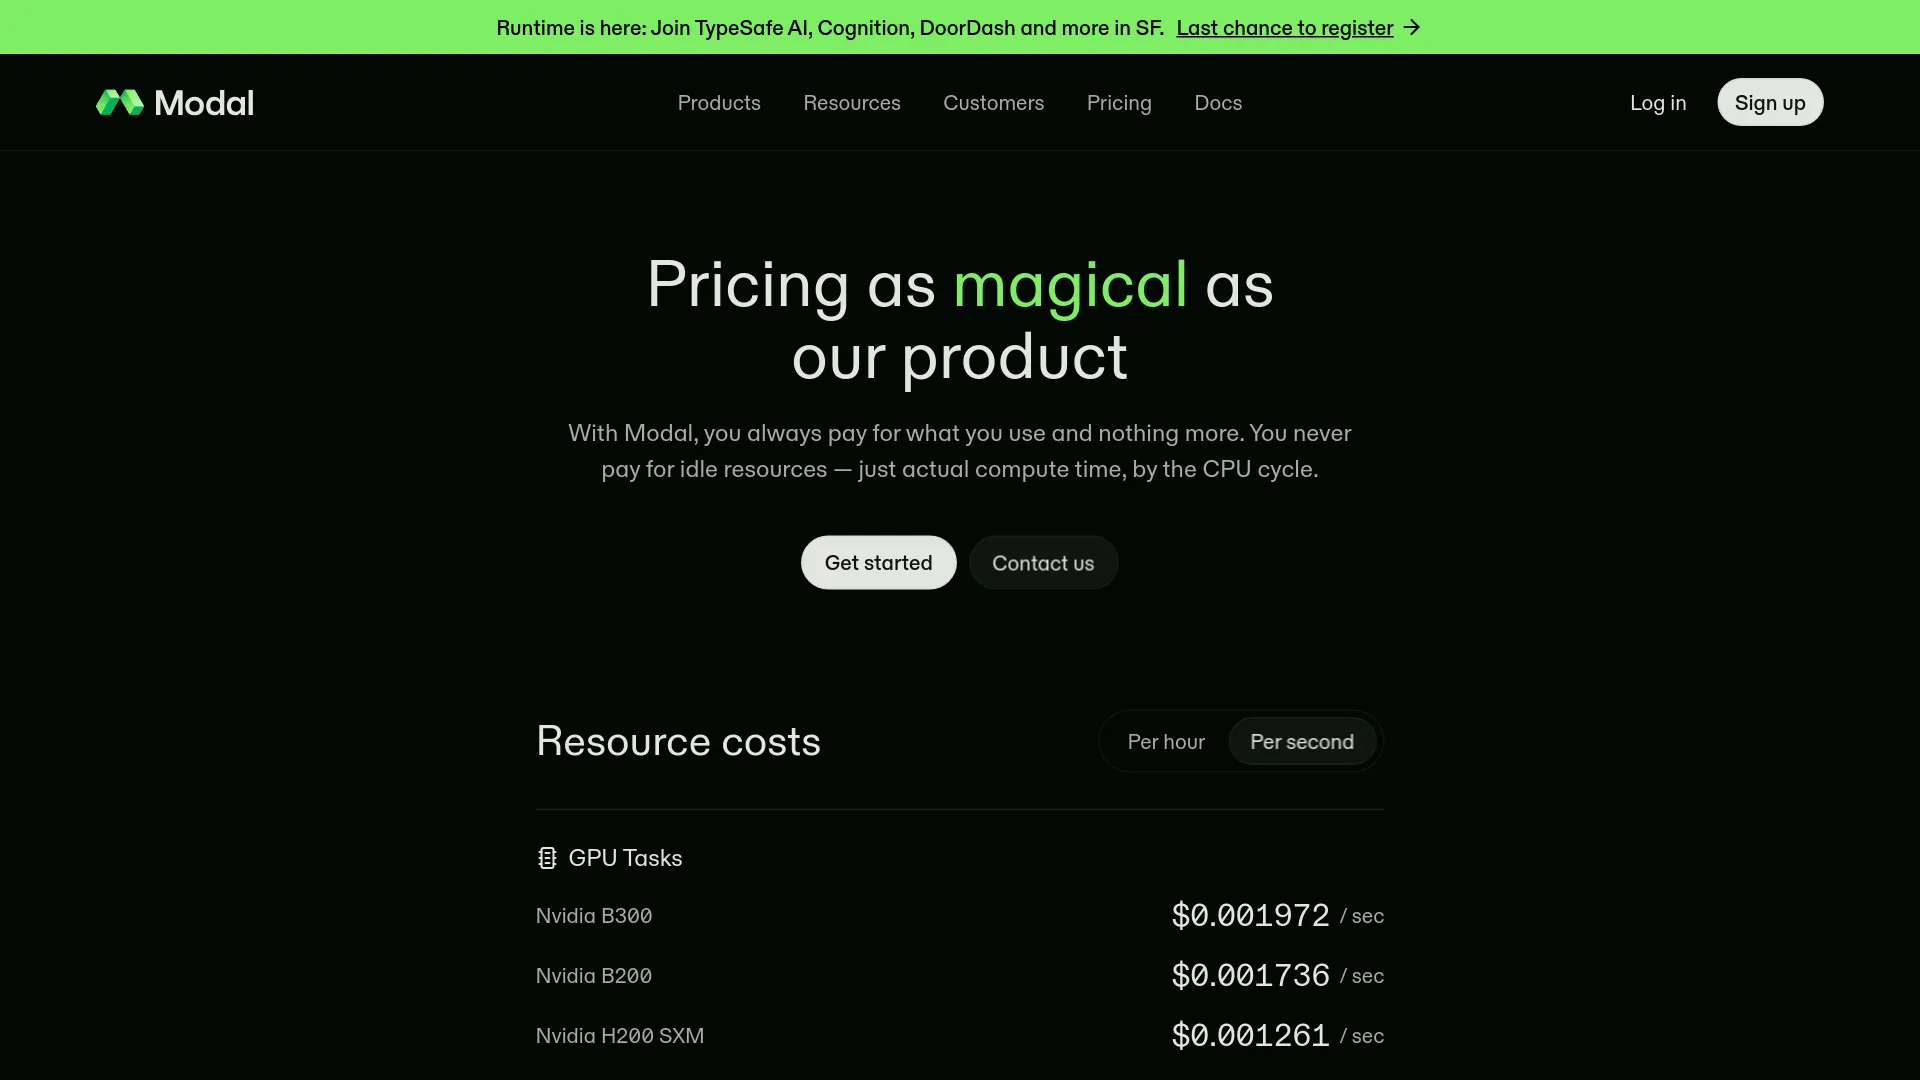
Modal Clusters fiyatlandırması bir dakikada
Resmi Modal fiyatlandırma sayfası ve genel kullanıma sunulma duyurusu, kullanıma dayalı faturalandırmayı ve birden fazla konteyneri birlikte başlatan @modal.clustered giriş noktasını açıklıyor. İsteğe bağlı RDMA, temel fiyatlandırma formülünü değil iletişim yolunu değiştiriyor.
GPU sayısı × GPU saniyesi × GPU ücreti + CPU saniyesi + bellek GiB-saniyesi + depolama + geçerli çıkış trafiği
Bu formül önemli; çünkü küme, her düğümün tam kaynak tahsisini faturaya yansıtıyor. Düğüm başına sekiz H100 GPU içeren dört düğümlü bir iş, bir koordinatör ve “ücretsiz” çalışanlar üzerinden değil, toplam 32 H100 üzerinden ücretlendiriliyor.
Modal Clusters fiyatlandırma kartına ne ekliyor?
Modal’ın 1 Ekim 2026 tarihli GA sürümü, çok düğümlü çalıştırmayı yönetilen bir yapı taşı hâline getiriyor. size konteyner sayısını belirlerken rdma=True, desteklenen ortamlarda yüksek hızlı iletişim yolunu etkinleştiriyor (Modal duyurusu).
Dokümantasyona göre sistem gang scheduling kullanıyor: İlerleyemeyecek kısmi bir işi başlatmak yerine, istenen grubu mümkün olduğunca birlikte yerleştirmeye çalışıyor. Desteklenen iş yükleri arasında dağıtık eğitim, fine-tuning, model paralelliğine dayalı çıkarım ve senkronize GPU iletişimi gerektiren prefill/decode tasarımları bulunuyor.
Küme dokümantasyonu pratik sınırları da netleştiriyor: GPU tahsisi tam düğüm üzerinden yapılıyor, yalnızca CPU kullanan kümeler desteklenmiyor ve başarısız olan ya da preempt edilen bir konteyner kümelenmiş çağrının tamamını başarısız kılabiliyor. Yalnızca rank 0’ın çıktısı döndürüldüğü için uzun süren işlerde konteyner dışına checkpoint almak gerekiyor.
Modal Clusters faturasının temelindeki GPU ücretleri
Aşağıdaki herkese açık ücretler, tahmin yapmak için iyi bir başlangıç noktası. Saatlik değerler saniyelik fiyatlardan hesaplandı; CPU, bellek, depolama ve olası bölgesel çarpanlar dahil değil.
| GPU | Saniye başına | Yaklaşık GPU-saat başına |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal ayrıca CPU için fiziksel çekirdek-saniye başına $0.0000131, bellek için GiB-saniye başına $0.00000222 ücret listeliyor. Volume’lar GiB başına aylık $0.09; ilk 1 TiB ücretsiz. Ağ çıkış trafiği ise dahil edilen kullanımın üzerindeki miktar için GiB başına $0.04 olarak belirtiliyor. Büyük bir işi başlatmadan önce güncel rakamları resmi fiyatlandırma kartından kontrol edin.
Örnek hesaplama: sekiz H100 içeren dört düğüm
Dağıtık bir eğitim işinin her düğümde size=4 ve H100:8 istediğini varsayalım.
- Dört düğüm × sekiz GPU = 32 H100 GPU.
- 32 × saat başına $3.95 = GPU maliyeti olarak saatte yaklaşık $126.40.
- $126.40 yalnızca GPU maliyeti için alt sınırdır; CPU, bellek, depolama ve çıkış trafiği ayrıca ücretlendirilir.
Karşılaştırmanız gereken temel rakam bu. Sunucuz yapının avantajı, yoğun kullanım sona erdiğinde kümenin küçülebilmesi; tamamen dolu bir kümeyi otomatik olarak ucuz hâle getirmesi değil.
Plan sınırları, fiyat listesinden daha belirleyici olabilir
Bir özelliğin genel kullanıma açılması, kapasitenin sınırsız olduğu anlamına gelmiyor. Modal’ın yayınladığı çalışma alanı katmanları, fiyat sorun hâline gelmeden önce büyük bir kümeyi durdurabilecek eşzamanlılık ve platform kısıtları içeriyor.
| Plan | Platform ücreti | Dahil hesaplama kredisi | Yayınlanan GPU eşzamanlılığı |
|---|---|---|---|
| Starter | $0/month | $30/month | 10 GPU |
| Team | $250/month | $100/month | 50 GPU |
| Enterprise | Custom | Custom | Custom / higher limits |
32 H100’lü bir deneme zaten 32 GPU kullanıyor. Bu nedenle Starter katmanı, 10 GPU’luk eşzamanlılık sınırı altında yukarıdaki örneği destekleyemiyor. Team planı kâğıt üzerinde GPU sayısını karşılayabilir; ancak gerçek kapasite, bölge seçimi ve istenen donanım yine de zamanlamayı etkiler.
$30’lık Starter kredisini 30 ücretsiz GPU-saatle karıştırmayın. Listelenen H100 ücreti üzerinden bu kredi, işin diğer kaynakları hesaba katılmadan yaklaşık 7,6 H100 GPU-saatine karşılık geliyor.
Modal Clusters ekonomik olarak ne zaman mantıklı?
Modal Clusters; büyük, aralıklı çalışan ve sürekli hazır tutması operasyonel açıdan yorucu olan işler için öne çıkıyor. Birkaç saat çalışan ve ardından kapanan eğitim işi, haftalarca kesintisiz çalışan bir kümeye kıyasla sıfıra ölçeklenmeden çok daha fazla fayda sağlar.
Şu durumlarda tercih edilebilir:
- Tüm düğümlerin birlikte başlamasını gerektiren dağıtık fine-tuning işleri.
- Pahalı GPU kapasitesi gerektiren kısa eğitim süreçleri.
- RDMA veya model paralelliği isteyen çok düğümlü çıkarım.
- Aksi durumda Kubernetes, SLURM veya manuel RDMA kurulumunu yönetecek Python ekipleri.
Model tek bir makineye sığıyorsa tek düğümlü bir Modal function daha uygun seçimdir. Kullanım oranı öngörülebiliyorsa, iş yükü sabit bir SLA gerektiriyorsa veya temel hedef sürekli GPU-saat maliyetini en aza indirmekse özel ya da rezerve altyapıyı mutlaka karşılaştırın.
Gerçek kullanıcıların deneyimleri de önemli bir sınır çiziyor. Bir bilgisayarlı görü başlığında u/Substantial_Camel735, vektör aramayı Modal worker’larında çalıştırmak yerine VPS üzerinde tutmayı önerdi (Reddit tartışması). Bunu platform genelinde geçerli bir kıyaslama değil, tek bir uygulayıcının mimari tercihi olarak değerlendirmek gerekir.
“Modal’dan uzaklaşmak üzereyiz ama bu tasarım kulağa doğru geliyor; yine de aramayı Modal worker’larında çalıştırmazdım. VPS’in üzerinde, kendi vector db’nize karşı çalıştırın.” — u/Substantial_Camel735, r/computervision
Büyük bir çalıştırmadan önce kontrol edilmesi gerekenler
- Toplam kaynak tahsisini çarpın. Önce
size × düğüm başına GPUhesabını yapın, ardından toplamı çalışma alanının eşzamanlılık sınırıyla karşılaştırın. - Anlamlı olabilecek en küçük kümeyle başlayın. İki düğümlü bir test; imaj, NCCL, rank ve rendezvous sorunlarını, 32 GPU’luk bir çalıştırmanın faturayı katlamasından önce ortaya çıkarabilir.
- RDMA’yı uygulama hata ayıklamasından ayırın. İş yükü izin veriyorsa önce dağıtık işi RDMA olmadan doğrulayın. Ardından
rdma=Trueseçeneğini etkinleştirip iletişime duyarlı bölümü ölçün. - Checkpoint’leri kalıcı depolamaya alın. Başarısız olan ya da preempt edilen tek bir rank, çağrının tamamını başarısız kılabilir. Checkpoint olmadan yapılacak yeniden deneme, pahalı çalıştırmanın tamamını tekrarlayabilir.
- CPU, bellek ve çıkış trafiğini bütçeye katın. Özellikle veri kümeleri veya çıktılar bölgeler arasında taşınıyorsa GPU hesabı faturanın yalnızca ilk satırıdır.
- Bölgesel sabitlemenin gerekli olup olmadığına karar verin. Yerleşimi daraltmak, kullanılabilir zamanlama havuzunu ve fiyat çarpanını değiştirebilir. Bölgesel kısıtlamayı ölçülebilir bir gereksinim olarak ele alın ve güncel bölgesel fiyatlandırma dokümantasyonuyla doğrulayın.
Modal’ın resmi fiyatlandırmasında RDMA için ayrı bir ücret listelenmiyor. RDMA’nın değeri performans tarafında: senkronize eğitim ve büyük KV-cache transferleri, standart TCP üzerinde ağ darboğazına takılabilir. Bunun karşılığında RDMA destekli donanım ve yerleşim seçenekleri kullanılabilirliği daraltabilir.
Modal Clusters SSS
Modal Clusters için ayrı bir API ücreti var mı?
Yayınlanmış ayrı bir küme ek ücreti yok. Modal, her konteynerin kullandığı GPU, CPU, bellek, depolama ve geçerli ağ kaynaklarını faturalandırıyor.
Maksimum küme boyutu nedir?
GA materyallerinde, herkese açık kümeler için 32 düğüme veya 256 GPU’ya kadar destekten söz ediliyor. Daha büyük gereksinimler Modal ile görüşülüyor (GA duyurusu). Çalışma alanı eşzamanlılığı ve mevcut kapasite yine geçerli.
Modal Clusters ile çıkarım yapılabilir mi?
Evet; ancak iş yükünün kümelenmiş çalıştırma modeline uygun olması gerekiyor. Çok düğümlü veya model paralelliğine dayalı çıkarım, standart bir HTTP endpoint’ine kıyasla daha güçlü bir kullanım alanı. Kümelenmiş web function’larında bazı sınırlamalar var; bunlardan biri trafiğin rank 0’a iletilmesi (küme dokümantasyonu).
Pratik karar rehberi
| İş yükünüz | Başlangıç için en uygun seçenek |
|---|---|
| Model tek bir GPU’ya veya düğüme sığıyor | Standart Modal function |
| Kısa süreli, senkronize çok düğümlü eğitim işi | Küçük bir testin ardından Modal Clusters |
| Uzun süre çalışan, öngörülebilir ve tam kapasite kullanılan iş | Özel veya rezerve GPU kapasitesini karşılaştırın |
| GPU çıkarımının yanında arama/veritabanı işi | Ölçümler birlikte konumlandırmayı haklı çıkarmıyorsa veri servisini ayrı tutun |
| Sıkı özel ağ veya kendi altyapısında barındırma gereksinimi | Farklı bir dağıtım modelini değerlendirin |
Modal Clusters, çok düğümlü GPU orkestrasyonuna başlamayı kolaylaştırıyor; ancak bunu doğrudan daha ucuz hâle getirmiyor. Sunucusuz yerleştirme ve Python odaklı kullanım, mühendislik zamanından tasarruf sağlayabilir. Öte yandan sürekli kullanım oranı, bölgesel kısıtlamalar ve tüm kümenin yeniden çalıştırılması faturayı belirleyebilir. Önce toplam düğüm sayısını hesaplayın; kolaylığın getirdiği ek maliyeti ancak bundan sonra özel kapasiteyle karşılaştırın.