 AIREITER
FinanceBench'te (368 SEC dosyası, yaklaşık 53.900 sayfa ve 150 soru) Mistral'in yeni Agentic Search katmanı, yalnızca arama yapan döngüyle çalışan tek geçişli RAG'e kıyasla yanıt doğruluğunu 47 ila 53 puan artırdığını söylüyor. Tam gezinme döngüsünde kazanım 59 puana kadar çıkıyor; token kullanımı da üçte bire varan oranda azalıyor. Ancak bunun bir bedeli var: tam döngüde p90 gecikme hâlâ 154 saniye, ortalama gecikme ise 71 saniye.
Mistral Agentic Search, 20 Ağustos 2026'da duyurulan ve dosyalar, sözleşmeler, taranmış PDF'ler gibi zorlu kurumsal veri kümeleri için tasarlanan bir erişim katmanı. Bu, web aramasını geliştiren bir ürün değil. Dakikalar sürebilen döngü, daha yüksek doğruluk için ödenen bedel.
Mistral Agentic Search tam olarak ne yapıyor?
Mistral Agentic Search, 20 Ağustos 2026'da kullanıma sunulan ve mevcut bir indeksi beş araçtan oluşan çok adımlı bir döngüyle kullanan bir erişim katmanı: search, open, navigate, read ve grep. Sistem, Mistral Search Toolkit üzerinden erişilebiliyor; Studio ve Vibe içindeki Libraries yapısına da entegre edilmiş durumda. İndeks sizin kontrolünüzde kalıyor ve ince ayar gerekmiyor. Ajan döngüsü, yalnızca parça tabanlı erişimin cevaplayamadığı soruların peşine düşüyor.
Beş araçlı döngü nasıl çalışıyor?
Mistral'in verdiği örnek, mekanizmayı iyi özetliyor: 1953 takvim yılında ABD'nin ulusal savunma harcamaları. Tek bir arama çağrısı ocak-haziran rakamlarını buluyor, ancak temmuz-aralık dönemini atlıyor. Agentic Search ise iki arama yapıyor, treasury_bulletin_1954_02.pdf dosyasını tespit ediyor, ardından 15. sayfadaki 3 numaralı tabloyu okuyor ve yılın 12 aylık verisini eksiksiz biçimde döndürüyor. Toplam harcama 44.463 milyon dolar.
| Araç | Görevi |
|---|---|
search | Olası kaynakları bulmak için indeksi sorgular |
open | Bulunan belgeyi yükler |
navigate | Belge içindeki sayfa, tablo veya bölümlere gider |
read | Belirli konumdaki içeriği çıkarır |
grep | Kesin ifadeleri, kodları veya tanımlayıcıları desen üzerinden bulur |
Tek geçişli RAG, sabit sayıda parçayı getirip tek seferde yanıt üretmek zorunda. İlk sonuçlar yetersiz kaldığında yeni bir belge isteyemiyor. Agentic Search ise kaynakları karşılaştırabiliyor, dipnot ve tabloların peşinden gidebiliyor, eksik sonuçları tamamlayabiliyor. Mistral'e göre kazanç, daha fazla deneme ve dönüş yapmak değil; boşa giden tekrarları azaltmak.
Benchmark sonuçları gerçekte ne gösteriyor?
Duyuruda iki benchmark yer alıyor. Her ikisi de herhangi bir ayar yapılmadan, Search Toolkit'in varsayılan yapılandırmasıyla ve Mistral tarafından raporlanmış. Mistral'in ifadesiyle bunlar “tavan değil, taban sonuçlar”. FinanceBench (Islam ve diğerleri, 2023; açık sürümü GitHub'da) 368 SEC 10-K, 10-Q ve 8-K dosyasından oluşuyor. Mistral'in hesaplamasına göre belgeler ortalama yaklaşık 147 sayfa uzunluğunda ve veri kümesinde 150 soru bulunuyor. Mistral'in kurulumunda sorular, insan etiketleriyle kalibre edilmiş bir LLM tarafından değerlendiriliyor.
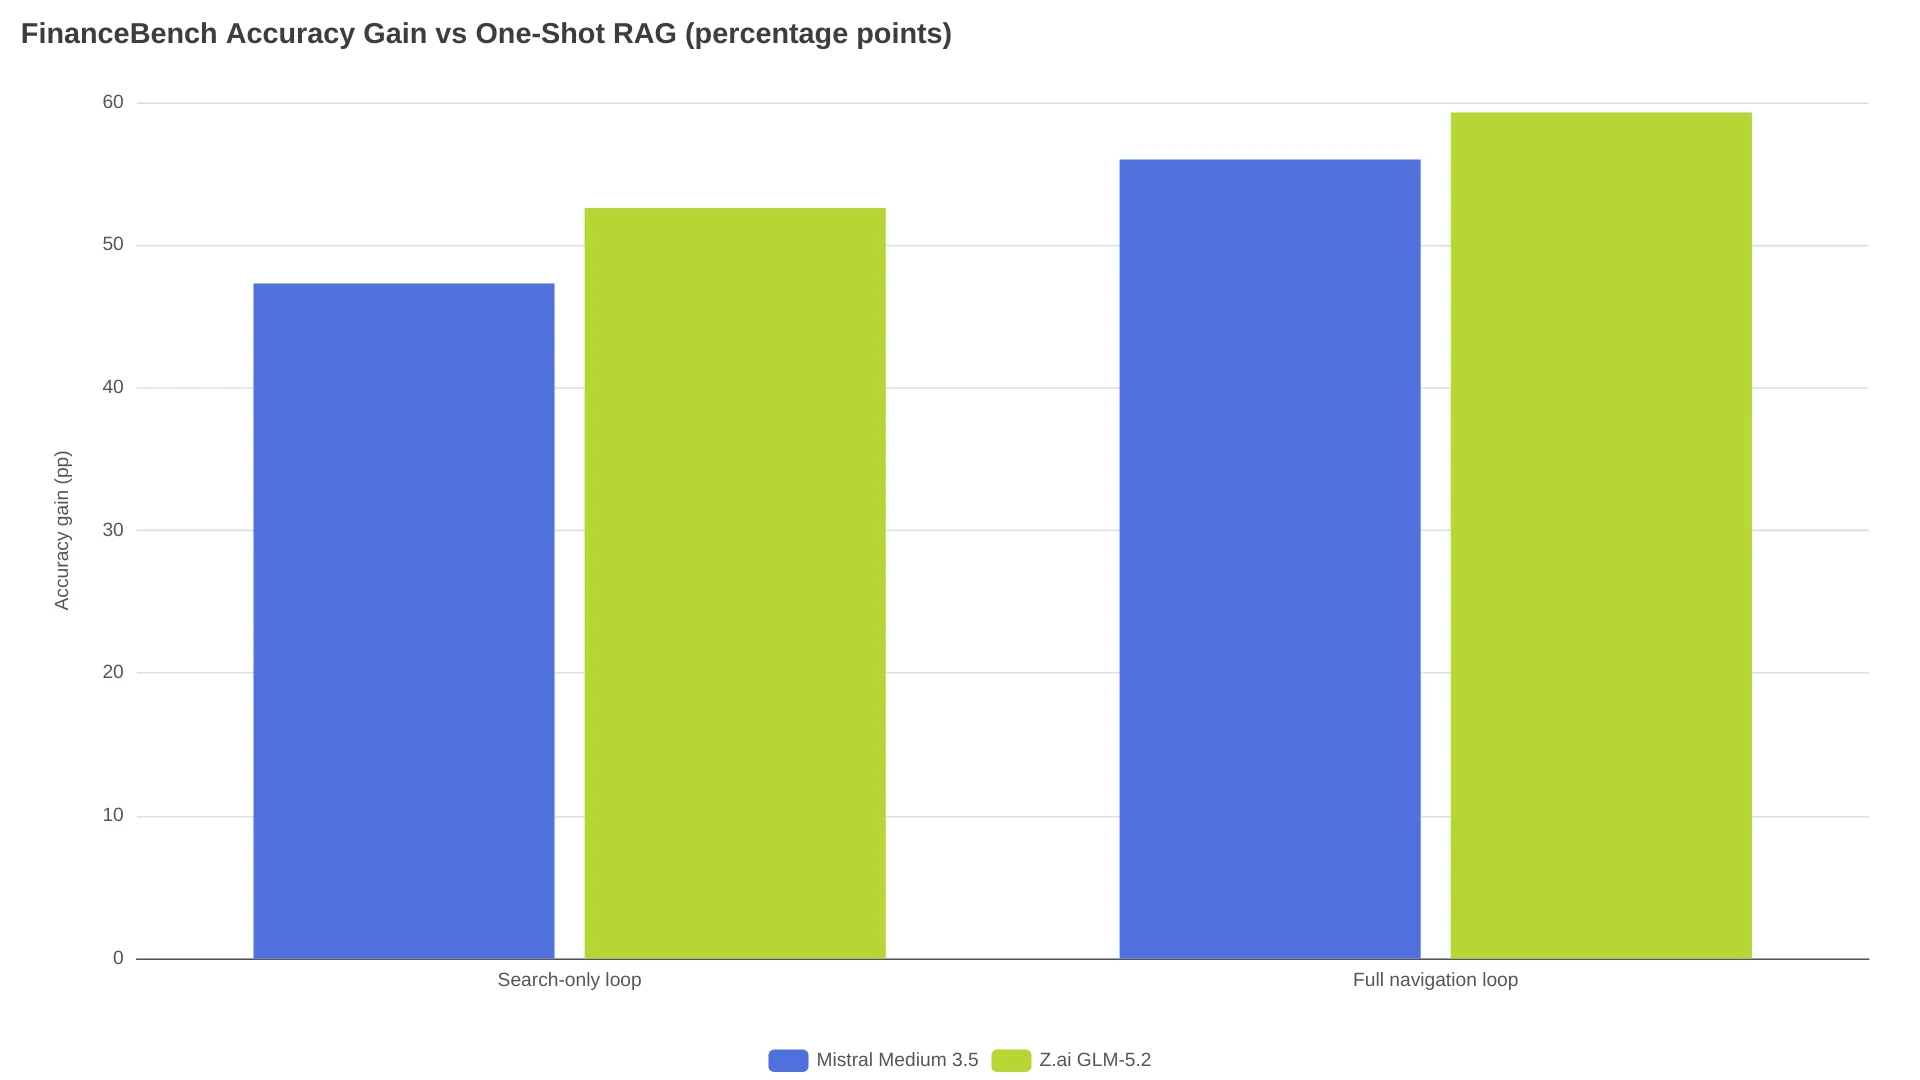
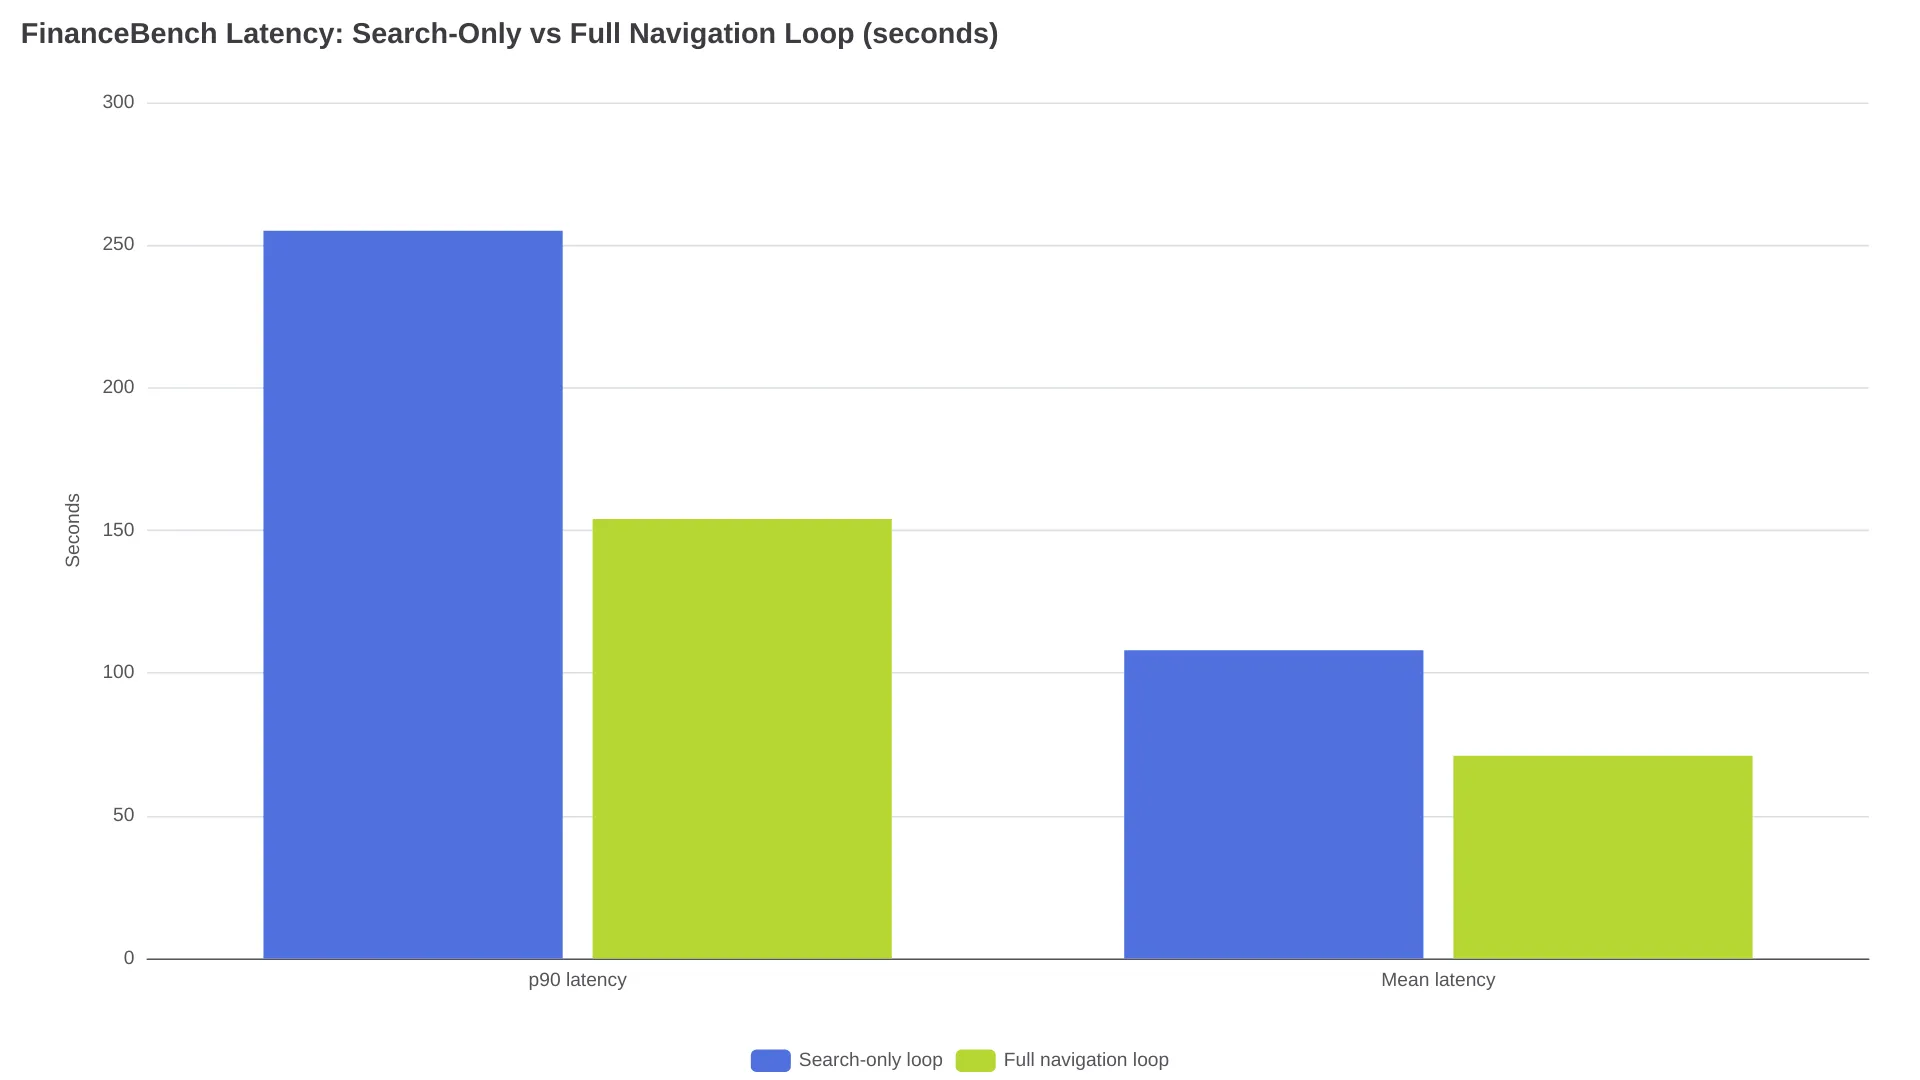
Arama döngüsüne gezinme araçlarının (open, navigate, read, grep) eklenmesi, Mistral Medium 3.5'te 8,7 puan, GLM-5.2'de ise 6,7 puan daha kazandırıyor. Tam gezinme döngüsü, yalnızca arama yapan döngüye göre Mistral Medium 3.5 ile %23,9, GLM-5.2 ile %33,7 daha az token kullanıyor. Gecikme de iyileşiyor: p90 değeri 255 saniyeden 154 saniyeye, ortalama ise 108 saniyeden 71 saniyeye düşüyor. Buradaki kıyas noktasına dikkat etmek gerek: token tasarrufu tek geçişli RAG'e göre değil, yalnızca arama yapan agentic döngüye göre ölçülmüş.
OfficeQA Pro daha zorlu bir test. Veri kümesinde 696 tarihî ABD Hazine Bülteni, yaklaşık 89.000 sayfa taranmış ve tablo ağırlıklı kamu PDF'i ile 133 soru bulunuyor. GLM-5.2 tam döngüyle %51,9 doğruluğa ulaşıyor; bu, %45,6 puanlık bir artış ve tek geçişli tabanın %6,3 olduğu anlamına geliyor. Mistral Medium 3.5 ise 27,1 puan iyileşiyor. Gezinme araçları dönüş sayısını %7,0'a kadar azaltıyor.
Mistral testlerde kendi Mistral Medium 3.5 modelini ve üçüncü taraf Z.ai GLM-5.2'yi kullandı; iki model de aynı yönde kazanım elde etti. Duyuruda ayrıca Kimi'nin araştırmasına atıf yapılıyor: GLM-5.2, Claude Code altyapısıyla OfficeQA Pro'da %41,4, Mistral'in altyapısıyla ise %51,9 sonuç vermiş. Ancak birincil Kimi kaynağına bağlantı bulunmadığı için 10,5 puanlık altyapı farkı Mistral'in yorumu olarak değerlendirilmeli. Mistral'in “erişim kalitesi model kapasitesiyle birlikte ölçeklenir” çıkarımı, darboğazın modelden çok kullanılan altyapı olduğunu ima ediyor.
Tek geçişli RAG hangi durumlarda hâlâ daha iyi?
Mistral de indeksli erişimin temel yapı taşı olduğunu, agentic döngünün ise ilk sonuçlar yetersiz kaldığında devreye girmesi gerektiğini söylüyor. Seçim büyük ölçüde belgelerin yapısına ve kabul edilebilir gecikmeye bağlı:
| İş yükünüz | Başlamak için doğru seçenek |
|---|---|
| Kısa ve düzenli belgelerde doğrudan bilgi arama | Tek geçişli RAG |
| Yüksek hacimli anahtar kelime veya anlamsal arama | Tek geçişli RAG |
| Yanıtların bilinen konumlarda yer alması | Tek geçişli RAG |
| Tablo ve dipnot içeren dosya, sözleşme ve kılavuzlar | Agentic Search |
| Taranmış, tablo ağırlıklı PDF'ler | Agentic Search |
| Birden fazla belgeye yayılan ve uzlaştırma gerektiren yanıtlar | Agentic Search |
| Etkileşimli gecikme beklentisi (saniyeler) | Tek geçişli RAG |
Ürününüz için 154 saniyelik p90 gecikme kabul edilemezse, daha yüksek doğruluk bunu telafi edemez. Finansal tabloların toplu olarak analiz edilmesi ise bambaşka bir kullanım senaryosu.
Agentic Search, web_search aracı değil
Bu ürünü ararken Google'ın Mistral'in websearch dokümantasyonunu öne çıkarması kafa karıştırabilir; ancak bunlar farklı ürünler. web_search ve web_search_premium, Agents API'ye ait araçlar. Canlı web araması yapıyor, kaynak gösteriyor ve Mistral'in API fiyatlandırma sayfasında model token ücretlerine ek olarak sırasıyla 1.000 çağrı başına 30 ve 50 dolar olarak fiyatlandırılıyor. Agentic Search ise ters yönde çalışıyor: açık web'i taramak yerine kendi indekslediğiniz veri kümesinin derinliklerine iniyor. İki araç farklı sorunları çözüyor ve fiyatı açıklanan da yalnızca biri. Agentic Search için duyuruda herhangi bir ücret bilgisi yer almıyor.
Başlamak için iki seçenek
- Search Toolkit. Veri alma, embedding ve indeksleme için açık modüller sunuyor; bulut veya şirket içi ortamlarda çalıştırılabiliyor. Ayrıştırıcılar, parçalara bölme, embedding modelleri, Vespa şemaları, sıralama profilleri ve hibrit erişim yapılandırılabiliyor.
- Studio ve Vibe Libraries. Yönetilen seçenek bu. Search Starter App, varsayılan ayarlarla veri kümeniz üzerinde yerel bir indeks oluşturabiliyor. Herhangi bir ince ayara geçmeden benchmark kurulumunu yeniden üretmenin en hızlı yolu bu.
Hangi yolu seçerseniz seçin, karar vermeden önce temsili sorularınızı hem tek geçişli RAG'e hem de tam döngüye yöneltin. Yanıt kalitesini, token kullanımını ve p90 gecikmeyi aynı koşullarda karşılaştırın.
Çıkışta hâlâ bilinmeyenler
Mistral, Agentic Search fiyatlandırmasını açıklamadı. Benchmark sonuçları da şirketin kendi raporları; ürün çıkarken bağımsız bir uygulamalı doğrulama bulunmuyordu. İlk kamuya açık tepkiler şimdilik ilk izlenimlerle sınırlı:
“mistral'ın API'sine agentic search eklemesi doğru hamle. Perplexity tarzı aramayı yerel bir ajan aracına dönüştürmek, kırılgan web kazıma süreçleri yazma ve proxy rotasyonunu kendimiz yönetme derdinden kurtarıyor.” — @AbdoKerdawy, yapay zekâ ürün geliştiricisi (X)
Token iddiaları ise Mistral'in duyurusunun tam olarak yanıtlamadığı bazı sorularla birlikte eleştirilmeye başladı:
“Mistral'in agentic search erişim aracı, tek geçişli aramadaki hataları %40'tan fazla azaltabileceğini söylüyor. Veritabanı sorgularını atlıyorsa, harcamanız gereken token sayısını da azaltacak mı?” — @therawlogs, bağımsız blog yazarı (X)
Resmî yanıt, yalnızca arama yapan döngüye kıyasla bildirilen %24-34 token azalması. Bunun benchmark veri kümeleri dışında da geçerli olup olmadığı ise ancak açık FinanceBench setinde yapılacak bağımsız bir çalışmayla netleşebilir.
Benzer ürünler de aynı fiziksel sınırlamayla karşı karşıya: Mixedbread Toast-1 agentic search modunda döngüyü dört tur ve sekiz paralel erişim çağrısıyla sınırlıyor. Şirketin dokümanları da bunun tek bir aramadan daha yavaş olduğunu açıkça belirtiyor. Bu kategorideki araçların doğruluk karşılığında ödediği vergi, gecikme.
Kısa yanıtlar
Mistral Agentic Search, Agents API üzerinden kullanılabiliyor mu?
Hayır. Ürün Mistral Search Toolkit ve Studio ile Vibe içindeki Libraries üzerinden sunuluyor. Agents API'deki web_search aracı ise ayrı fiyatlandırılan, canlı web araması yapan farklı bir ürün.
Agentic Search gerçekten token kullanımını azaltıyor mu?
Resmî benchmark sonuçlarına göre tam gezinme döngüsü, FinanceBench'te yalnızca arama yapan agentic döngüye kıyasla %23,9-33,7 daha az token kullanıyor. Ancak bağımsız bir doğrulama henüz yayımlanmadı.
Agentic Search hangi modellerle çalışıyor?
Mistral, Mistral Medium 3.5 ve Z.ai GLM-5.2'yi test etti ve iki modelde de benzer kazanımlar gördü. Şirket katmanı modelden bağımsız olarak tanımlıyor; ince ayar gerekmiyor.
Mistral Agentic Search ne kadar?
Agentic Search'in kendisi için herhangi bir fiyat açıklanmadı. Mistral'in fiyatlandırma sayfasındaki 1.000 çağrı başına 30 dolar ücreti, eski web_search ajan aracına ait.
Ortada çözülmemiş bir denge var: Burada doğruluk, dakikalarla satın alınıyor. Dosya, sözleşme ve taranmış kamu kayıtlarını toplu olarak işlerken OfficeQA Pro ve FinanceBench tam döngü sonuçlarında görülen +45 ila +59 puanlık doğruluk artışı, daha yavaş bir döngü karşılığında token kullanımını üçte bire kadar azaltıyorsa makul bir takas sayılabilir. Kullanıcıya doğrudan yanıt veren uygulamalarda ise ortalama 71 saniyelik gecikme hâlâ kabul edilemez. Üstelik Mistral dışından biri FinanceBench'i yeniden çalıştırana kadar sayfadaki en güçlü rakamlar şirketin kendi sonuçları olarak kalacak.
İlgili içerikler: GLM-5.2 API rehberi ve GLM-5.2 incelemesi, Mistral'in testlerinde kullandığı ikinci benchmark modeli hakkında daha fazla bilgi sunuyor.