 AIREITER
Для передачи интонации берите Claude Sonnet 5, для массового перевода — DeepSeek V4 Flash примерно за $0.10 на 1 000 задач, а если важнее всего скорость и универсальность — GPT-5.6 Terra. К такому выводу мы пришли, протестировав шесть моделей 17 июля 2026 года.
Каждой API-модели мы отправили три идентичных запроса и сравнили сырые результаты. Качество не стало сюрпризом: все шесть корректно перевели технический текст на немецкий, а пять из шести без единой ошибки разобрались с японским диалогом, где опущены подлежащие. Неожиданной оказалась экономика. Две «дешёвые» модели тратили на каждый запрос столько reasoning-токенов, что один перевод в итоге обходился в 8–10 раз дороже Claude — почти как у DeepL с его тарификацией по символам.
В 2026 году выбор лучшей LLM для перевода уже не сводится к вопросу «какая умеет переводить». Умеют все. Гораздо важнее подобрать модель под тип контента и объём, не переплачивая незаметно в процессе.
Какую модель выбрать под конкретную задачу
| Ваш сценарий | Выбор | Почему | Замеренная стоимость 1 000 задач |
|---|---|---|---|
| Маркетинговые тексты, голос бренда | Claude Sonnet 5 | Звучит так, будто текст изначально написали на целевом языке, а не перевели | ~$1.06 |
| Большие объёмы: товарные фиды, документация, субтитры | DeepSeek V4 Flash | Корректно справился со всеми тремя тестами и оказался самым дешёвым с большим отрывом | ~$0.10 |
| Смешанные нагрузки, минимальная задержка | GPT-5.6 Terra | Ответы за 3.0–4.3 с, самое аккуратное форматирование | ~$0.88 |
| Строгое соблюдение глоссариев, процессы с CAT-инструментами | DeepL | Терминологические базы и интеграции, которых нет у LLM API | $27.50 за 1 млн символов |
Стоимость — средняя по трём задачам из нашего теста: выходные токены умножены на официальные тарифы июля 2026 года и пересчитаны на 1 000 коротких переводов. Полная таблица замеров — ниже. За рамками теста остался отдельный сценарий: для живого голосового общения Google продаёт специализированную версию Gemini 3.5 Live Translate за $3.50/$21 за миллион токенов. Мы её упоминаем, но не тестировали.
Методика тестирования
Три запроса, шесть моделей, одинаковые формулировки и по одному запуску каждой модели 17 июля 2026 года. Проверяли английский→японский на маркетинговом тексте — это тест на тон; английский→немецкий на API-документации — на терминологию; японский→английский на разговорном диалоге — на понимание контекста и опущенных подлежащих, классической проблеме для пар с CJK-языками. CJK — сокращение для китайского, японского и корейского: именно на этих трёх языках чаще всего концентрируются жалобы на качество машинного перевода.
В тест вошли GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 и Kimi K2.6. Все запросы шли через один аккаунт шлюза с настройками по умолчанию. Поэтому задержки сопоставимы между собой, хотя в вашем регионе и при другой нагрузке провайдера цифры могут отличаться.
Вот исходные тексты дословно — их можно использовать для собственного прогона:
EN→JA (маркетинг): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (технический текст): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (диалог): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Все замеры по моделям и задачам: задержка в секундах реального времени / выходные токены из объекта usage.
| Модель | EN→JA | EN→DE | JA→EN | Средняя цена задачи |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
Цена одной задачи = выходные токены × официальная цена выходных токенов у провайдера. На вход приходится 60–110 токенов на задачу; даже по тарифам GPT-5.6 Terra это добавляет менее $0.0003. В диаграмме ниже, где расчёт идёт на миллион символов, входные токены уже учтены. Все цены — официальные прайс-листы на 17 июля 2026 года, а не скидочные ставки, по которым списывали средства с нашего аккаунта.
Три теста не позволяют ранжировать модели по сотне языковых пар — мы и не утверждаем обратного. Но даже небольшая выборка помогает увидеть устойчивые различия. В нашем случае они оказались весьма заметными.
Тест 1: маркетинговый текст с английского на японский
Мы попросили естественно и вежливо перевести на японский строку для SaaS-лендинга: "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
Claude Sonnet 5 выдал такой вариант:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
Именно так мог бы написать японский копирайтер. Стилизованное カタチ — катакана для «формы» — и ритм с запятыми характерны для лендингов, а не для учебников грамматики. Ненамного отстали GPT-5.6 Terra и DeepSeek V4 Pro: у них получились чистые, деловые варианты вроде 「アイデアを、より迅速に形に。」.
DeepSeek V4 Flash оказался самым буквальным из шести: 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」 Грамматически всё в порядке, но текст ощущается именно как перевод. Для продуктовой страницы ему стоило бы добавить человеческую редактуру. Для справочных статей или внутренней документации это вполне рабочий результат.
Разрыв есть, но он небольшой: все шесть моделей выдали пригодный японский текст. В задачах, где важен голос бренда, дополнительные ~$1 за 1 000 задач у Claude себя оправдывают; ни в одном другом нашем тесте разница не была настолько значимой.
Тест 2: техническая документация с английского на немецкий
Мы перевели две фразы из API-документации: про ограничения частоты запросов, HTTP 429, экспоненциальный backoff и ключи идемпотентности. Все шесть моделей правильно передали термины и использовали естественные для немецкой технической документации формулировки: Ratenlimit, Statuscode 429, exponentielles Backoff, Idempotenzschlüssel.
Единственное заметное отличие: GPT-5.6 Terra оформил Retry-After как код — так же, как в реальной немецкой API-документации обычно набирают имена заголовков. Приятная деталь, но не разница в качестве.
В стандартной документации между хорошо обеспеченными европейскими языками ни одна модель из выборки не допустила ошибки. На этом поколении различия в качестве оказались слишком малы, чтобы их увидеть. Если это весь ваш рабочий поток, выбирайте по цене и скорости, а не по качеству. По этому критерию DeepSeek V4 Flash становится вариантом по умолчанию: $0.14 за входной и $0.28 за выходной миллион токенов.
Тест 3: японско-английский диалог с опущенными подлежащими
В японском подлежащее регулярно опускают, и переводчику приходится восстанавливать, кто именно что делает. В диалоге из теста также встречается 根回し (nemawashi) — культурно обусловленный термин, означающий неформальную подготовку консенсуса перед официальным решением и не имеющий точного английского эквивалента.
Пять из шести моделей справились со всем. Подлежащие были определены верно, а nemawashi передавалось как "lay the groundwork", "sound him out beforehand" или "give him a heads-up" — все варианты можно обосновать. У Claude получился самый естественный разговорный английский: "he's probably gonna chew me out".
Единственная настоящая ошибка среди 18 результатов была у DeepSeek V4 Pro. Совет 「先に根回ししといたほうがいい」 о том, что следует сделать дальше, модель перевела как "You should've laid the groundwork first" — сожаление в прошедшем времени о том, что возможность уже упущена. Разница в нескольких словах, но смысл противоположный. Услышав от коллеги одно вместо другого, вы поступили бы иначе.
Одна ошибка времени в одном запуске — это наблюдение, а не окончательный вердикт модели. Два уровня DeepSeek мы подробнее сравниваем в материале DeepSeek V4 Flash vs Pro comparison. Но этот пример хорошо напоминает: беглость и точность — не одно и то же. Фраза может звучать безупречно, но означать не то. Для договоров, медицинских материалов и любых текстов, где ошибка во времени стоит денег, закладывайте проверку человеком независимо от выбранной модели.
Ловушка расхода токенов: почему прайс-лист вводит в заблуждение
Вот результат, который меняет решение о покупке. За миллион выходных токенов GLM-5.2 просит $4.40, а Kimi K2.6 — $4.00: меньше половины от $10 у Claude Sonnet 5. Но по фактической цене одного перевода они оказались в 8–10 раз дороже.
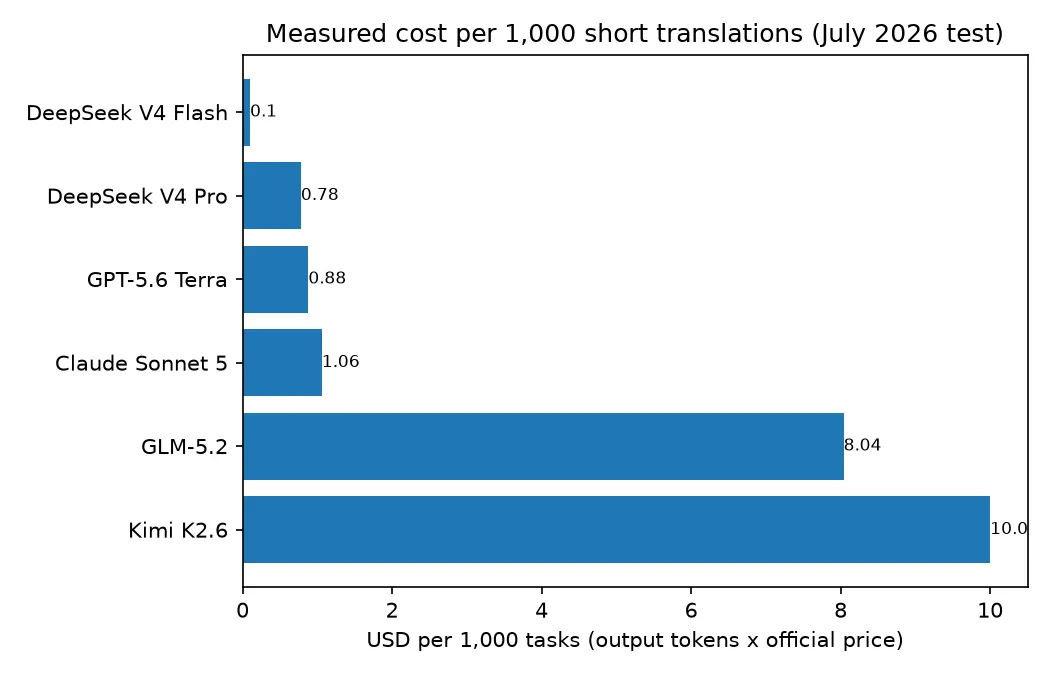
Причина в том, что обе модели перед ответом строят видимую цепочку рассуждений, а reasoning-токены тарифицируются как выходные. На перевод одного маркетингового предложения Kimi K2.6 выдал 2 849 выходных токенов, GLM-5.2 — 1 906, хотя сам перевод занимал 40–60 токенов. Claude Sonnet 5 потратил на ту же задачу 60 токенов, GPT-5.6 Terra — 46.
Ту же картину показала и задержка. GPT-5.6 Terra и Claude Sonnet 5 отвечали за 3–4 секунды на всех трёх задачах. DeepSeek V4 Flash требовал 4–5 с, DeepSeek V4 Pro — 16–20 с, а GLM-5.2 и Kimi K2.6 тратили на один запрос от 20 до 48 секунд.
Из этого следуют два практических правила. Во-первых, для коротких массовых задач вроде перевода сравнивайте модели по замеренной цене одной задачи, а не по тарифу за миллион токенов: сделайте 20 запросов и посмотрите поле usage. Во-вторых, отключайте или снижайте reasoning для перевода. DeepSeek разделяет thinking- и non-thinking-endpoint'ы, а GLM и Kimi позволяют настраивать thinking в теле запроса. В трёх наших задачах цепочка рассуждений не дала ничего заметного с точки зрения качества.
Во сколько обходится перевод в большом объёме
Если пересчитать измеренный расход токенов на миллион символов английского исходного текста — примерно 250 000 токенов, — разница становится особенно наглядной:
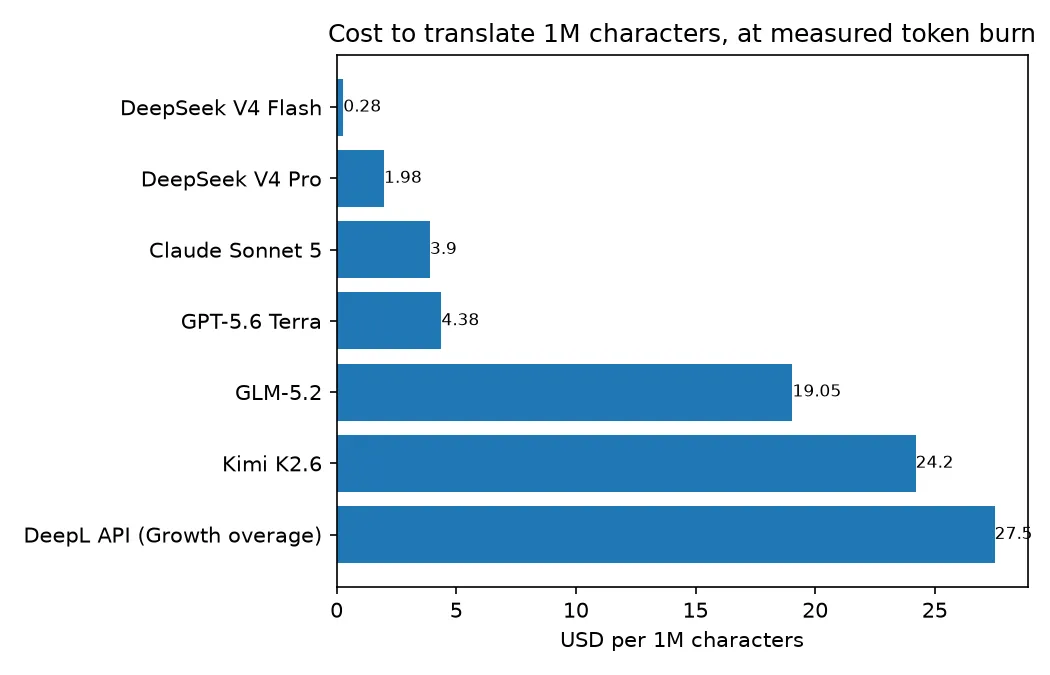
DeepSeek V4 Flash переведёт объём примерно с целый роман всего за $0.28. Такой же объём через API DeepL обойдётся в $27.50 по ставке сверх включённого лимита тарифа Growth — разница в 98 раз. Направление совпадает с выводами широко разошедшегося разбора на r/LocalLLaMA под заголовком "LLMs are 800x cheaper for translation than DeepL"; там множитель был выше за счёт более компактных self-hosted-моделей.
Обратите внимание на верхнюю часть диаграммы: при фактическом расходе токенов open-weight-модели с тяжёлым reasoning почти догоняют DeepL по стоимости. Тариф за единицу без замера токенов — это не оценка реальных затрат.
Перед выбором сервиса стоит знать три факта о тарифах — все проверены 17 июля 2026 года:
- Бесплатный уровень DeepL изменился. Тариф API Developer теперь даёт разовый кредит на 1 000 000 символов, а не ежемесячные 500 000 символов, которые всё ещё цитируют старые документы и ответы на форумах. Growth стоит $26 в месяц при годовой оплате и включает 12 млн символов в год; дальше — $27.50 за каждый дополнительный миллион.
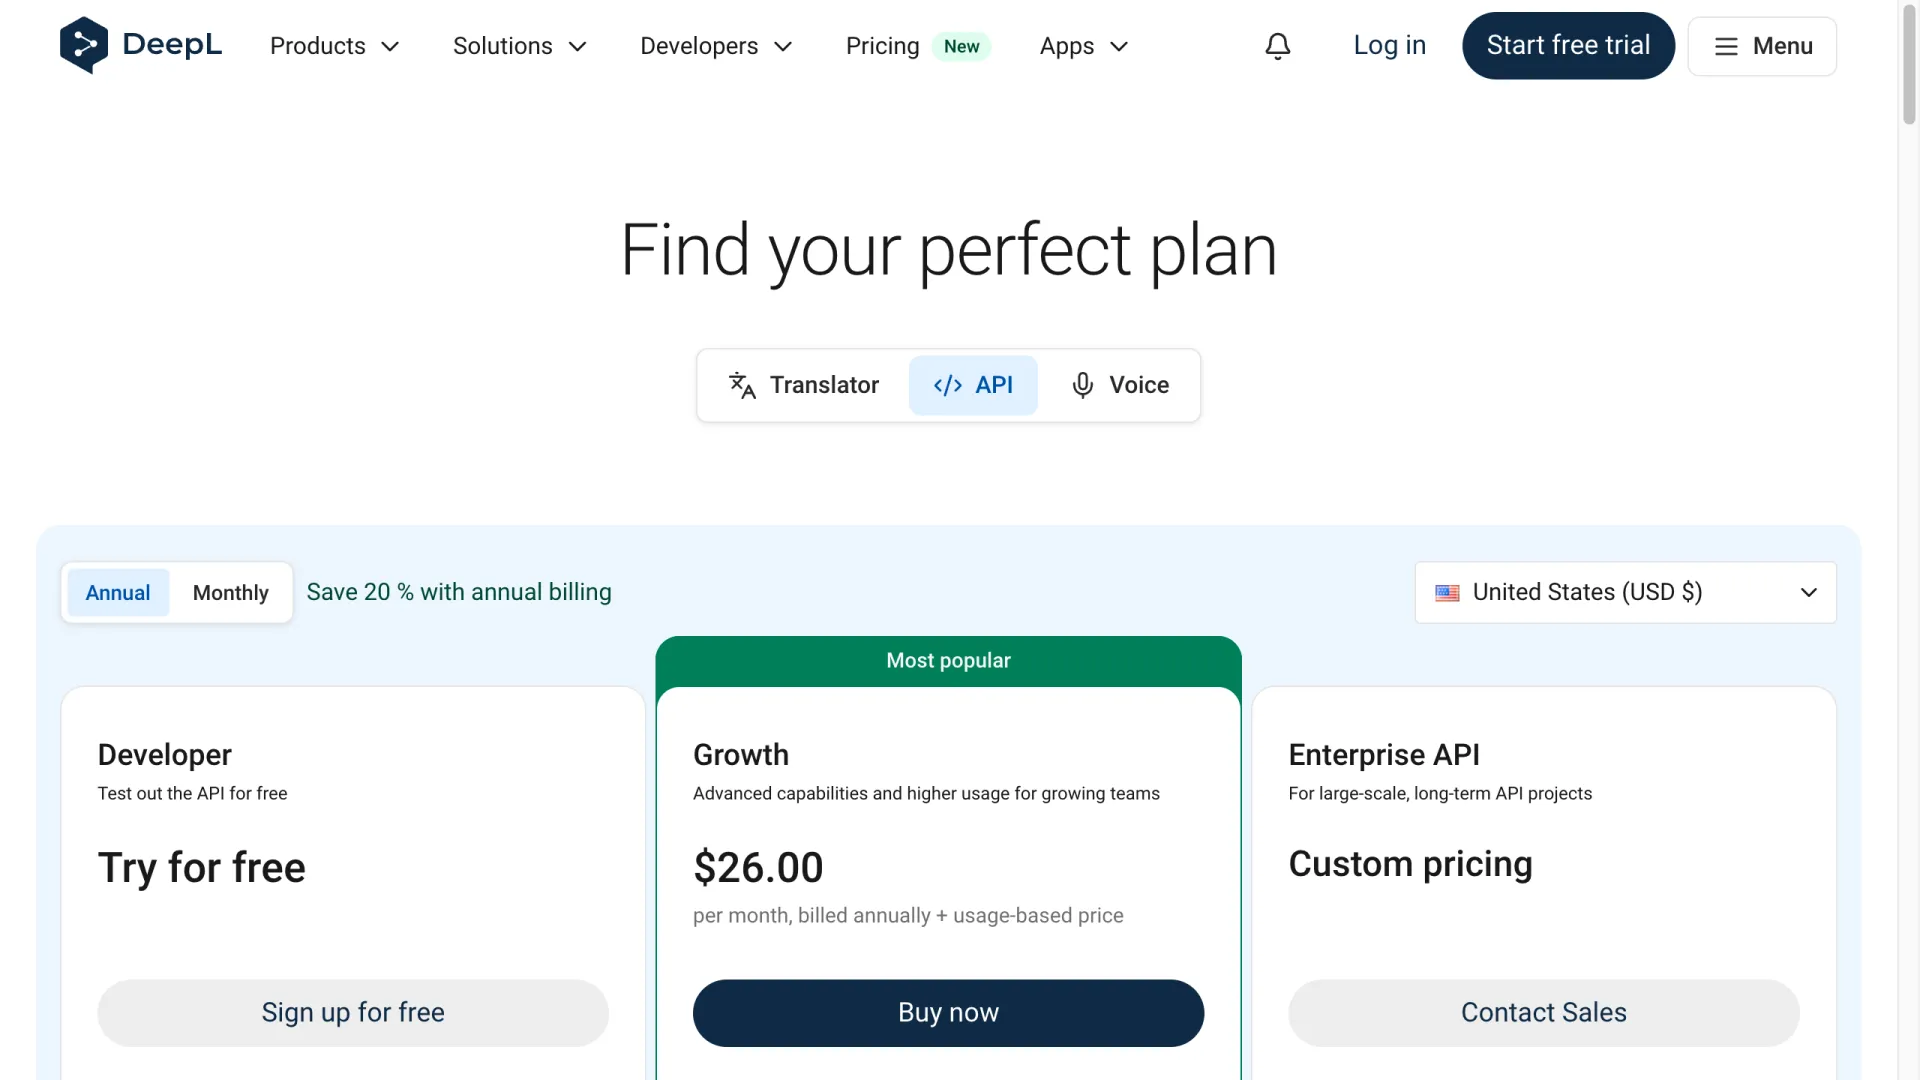
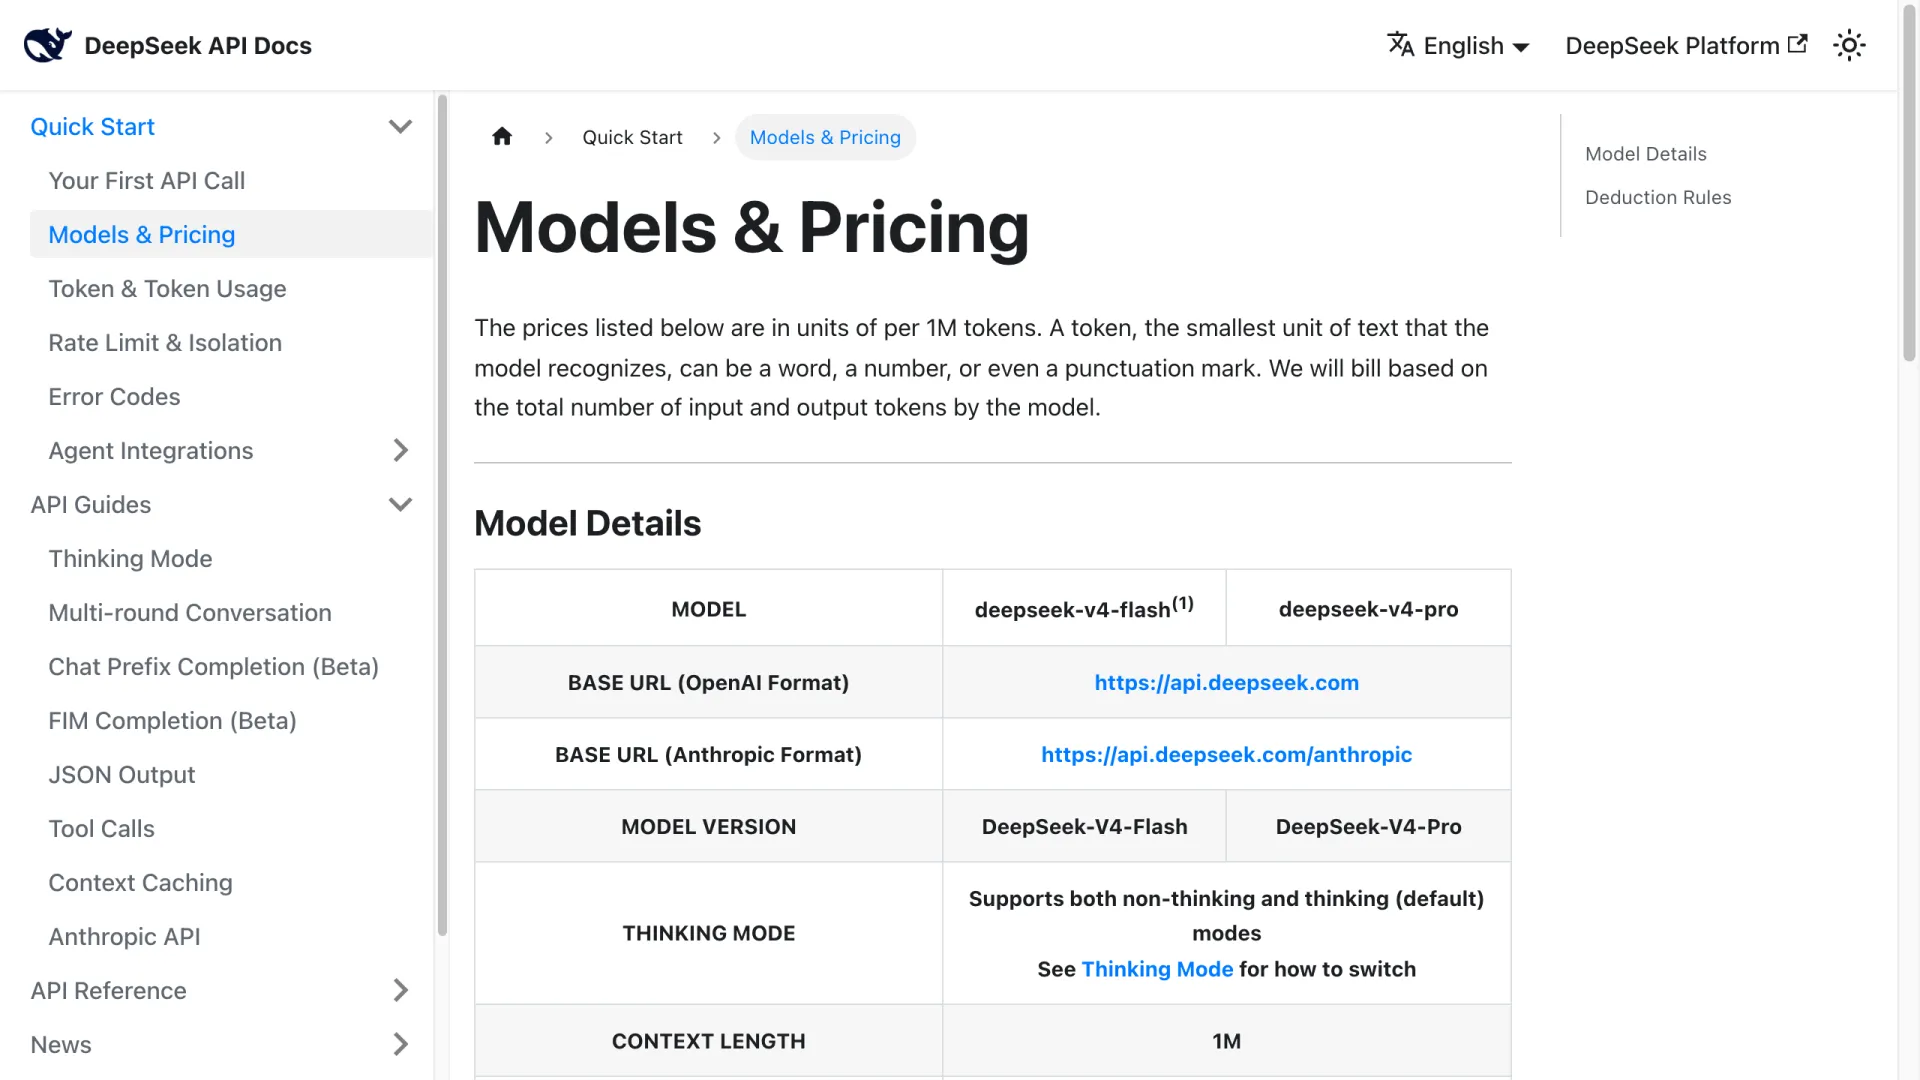
- DeepSeek берёт лишь малую долю от цен конкурентов. Для V4 Flash это $0.14 за входной и $0.28 за выходной миллион токенов, а входной токен из cache hit стоит $0.0028. Старое имя модели deepseek-chat перестанет использоваться 24 июля 2026 года.
- У Claude Sonnet 5 действуют вводные цены. До 31 августа 2026 года — $2/$10 за миллион токенов, затем — $3/$15. Новый токенизатор модели также производит примерно на 30% больше токенов для того же текста; это учтено в наших расчётах. Если планируете расходы после сентября, учитывайте оба фактора.
- Batch API сокращают счёт вдвое. OpenAI, Anthropic и Google дают скидку около 50% для асинхронной пакетной обработки. Перевод обычно не критичен к задержке, поэтому это фактически бесплатная экономия: batch-тариф снижает цену GPT-5.6 Terra примерно до $2.19, а Claude Sonnet 5 — до ~$1.95 за миллион символов.
В каких случаях DeepL или Google Translate всё ещё лучше
По цене за символ LLM выгоднее, но в трёх сценариях выбор остаётся за традиционными сервисами:
- Строгое соблюдение терминологии. DeepL предлагает глоссарии и терминологические базы, которые гарантируют одинаковый перевод термина каждый раз. LLM можно дать такое указание в промпте и затем проверять результат, но это вероятностный подход, а не жёсткое правило.
- Интеграции с CAT-инструментами и пайплайнами. Если ваша память переводов хранится в CAT-инструменте, коннекторы DeepL подключаются напрямую.
- Задержка менее секунды в масштабе. Классические нейросетевые MT-движки обычно отвечают быстрее универсальных LLM. Для перевода прямо в интерфейсе это важно.
Для живой речи ни классический NMT, ни чат-LLM не подходят по своей природе. Google оценивает специализированную версию Gemini 3.5 Live Translate в $3.50/$21 за миллион токенов с поминутными ставками за аудио; мы разбирали её в статье Gemini 3.5 Live Translate breakdown.
Для редких языков и языков с ограниченными ресурсами покрытие важнее рейтингов качества. Прежде чем сравнивать что-либо ещё, убедитесь, что нужная языковая пара вообще поддерживается. DeepL работает примерно с 30 языками, тогда как крупные LLM справляются более чем со ста, хотя к концу этого списка качество снижается.
Open-source и локальные модели
GLM-5.2 и модели Kimi K-series публикуют открытые веса. Поэтому проблему с расходом токенов можно решить при self-hosting: вы контролируете параметры сэмплирования и можете полностью отключить цепочки рассуждений.
Для локального перевода на одной GPU в обсуждениях r/LocalLLaMA threads on local translation models постоянно рекомендуют Qwen3-30B-A3B — для перевода европейских языков на английский. Чем экзотичнее языковая пара, тем более крупные модели советует сообщество. Обычно причина выбора — приватность для договоров и ещё не анонсированных продуктов либо нулевая предельная стоимость, а не лучшее качество: в тех же обсуждениях говорят, что облачные frontier-модели пока переводят лучше.
Стоит следить за Kimi K3: на этой неделе модель вышла с открытыми весами, а в хостинговом варианте стоит $3/$15 за миллион токенов. Мы тестировали K2.6, поскольку API-доступ к K3 ещё разворачивался. Если K3 унаследует аппетит K-series к токенам, к ней будет применима та же оговорка о замеренной стоимости.
Как повторить сравнение на своих данных
Всё описанное выше можно воспроизвести примерно за 20 API-вызовов. Возьмите две фразы из собственных материалов, отправьте их каждой модели-кандидату и посмотрите объект usage в ответе — там будут реальные числа токенов. Весь наш тест из 18 запросов обошёлся дешевле $0.15.
Самая неудобная часть — держать шесть API-ключей от пяти провайдеров. Мы запускали все шесть моделей через один аккаунт AIReiter, который перепродаёт доступ к API крупных моделей — ключи семейства Claude примерно за пятую часть прайс-листа — через единый Anthropic-совместимый endpoint. Один ключ и одинаковый формат запросов для всех моделей из статьи.
Если объём переводов у вас действительно значительный, час точечной проверки на собственном контенте полезнее любого рейтинга, включая этот. Модели достаточно близки по качеству, поэтому решающими должны стать ваша языковая пара, требования к тону и реальные замеры токенов.
FAQ
Что лучше для перевода — ChatGPT или Gemini?
В наших тестах GPT-5.6 Terra оказался быстрым, точным и аккуратным в форматировании на всех трёх задачах. Gemini мы напрямую не сравнивали — его не было в нашем шлюзе, — но опубликованные тарифы конкурентоспособны: $1.50/$9 за миллион токенов для 3.5 Flash. Кроме того, это единственный провайдер со специализированной моделью для перевода живой речи.
Какой ИИ-переводчик сейчас самый точный?
Для популярных языковых пар разница в точности между frontier-моделями невелика: все шесть протестированных моделей без ошибок перевели технический текст на немецкий. Основные различия проявляются в тоне — Claude лидировал на японском маркетинговом тексте — и в пограничных случаях с опущенными подлежащими и временем, где DeepSeek V4 Pro допустил единственную существенную ошибку в выборке.
Какая open-source LLM лучше всего подходит для перевода?
GLM-5.2 и Kimi K2.6 публикуют веса и корректно перевели наши тестовые тексты. При self-hosting можно отключить цепочки рассуждений, из-за которых их хостинговые API дороги в пересчёте на задачу. Для потребительского железа наиболее распространённая рекомендация сообщества — Qwen3-30B-A3B.
Может ли LLM заменить переводчика-человека?
Для внутренней документации, материалов поддержки и массовых товарных текстов — в значительной степени да: стоимость составляет 1–16% цены DeepL за символ в зависимости от модели: DeepSeek V4 Flash ~1%, Claude Sonnet 5 ~14%, GPT-5.6 Terra ~16%. Но для договоров, медицинских текстов и бренд-кампаний ошибка времени из третьего теста — показательный сигнал. Беглый перевод всё ещё может исказить смысл, поэтому там, где неверное прочтение обходится дорого, нужна проверка человеком.
Стоит ли по-прежнему пользоваться DeepL в 2026 году?
Да, в трёх случаях: если нужны строгие глоссарии, интеграции с CAT-инструментами или задержка менее секунды. За пределами этих сценариев экономику по цене за символ трудно оправдать. И помните: бесплатный уровень теперь даёт разовый кредит на 1 млн символов, а не ежемесячный лимит.