 AIREITER
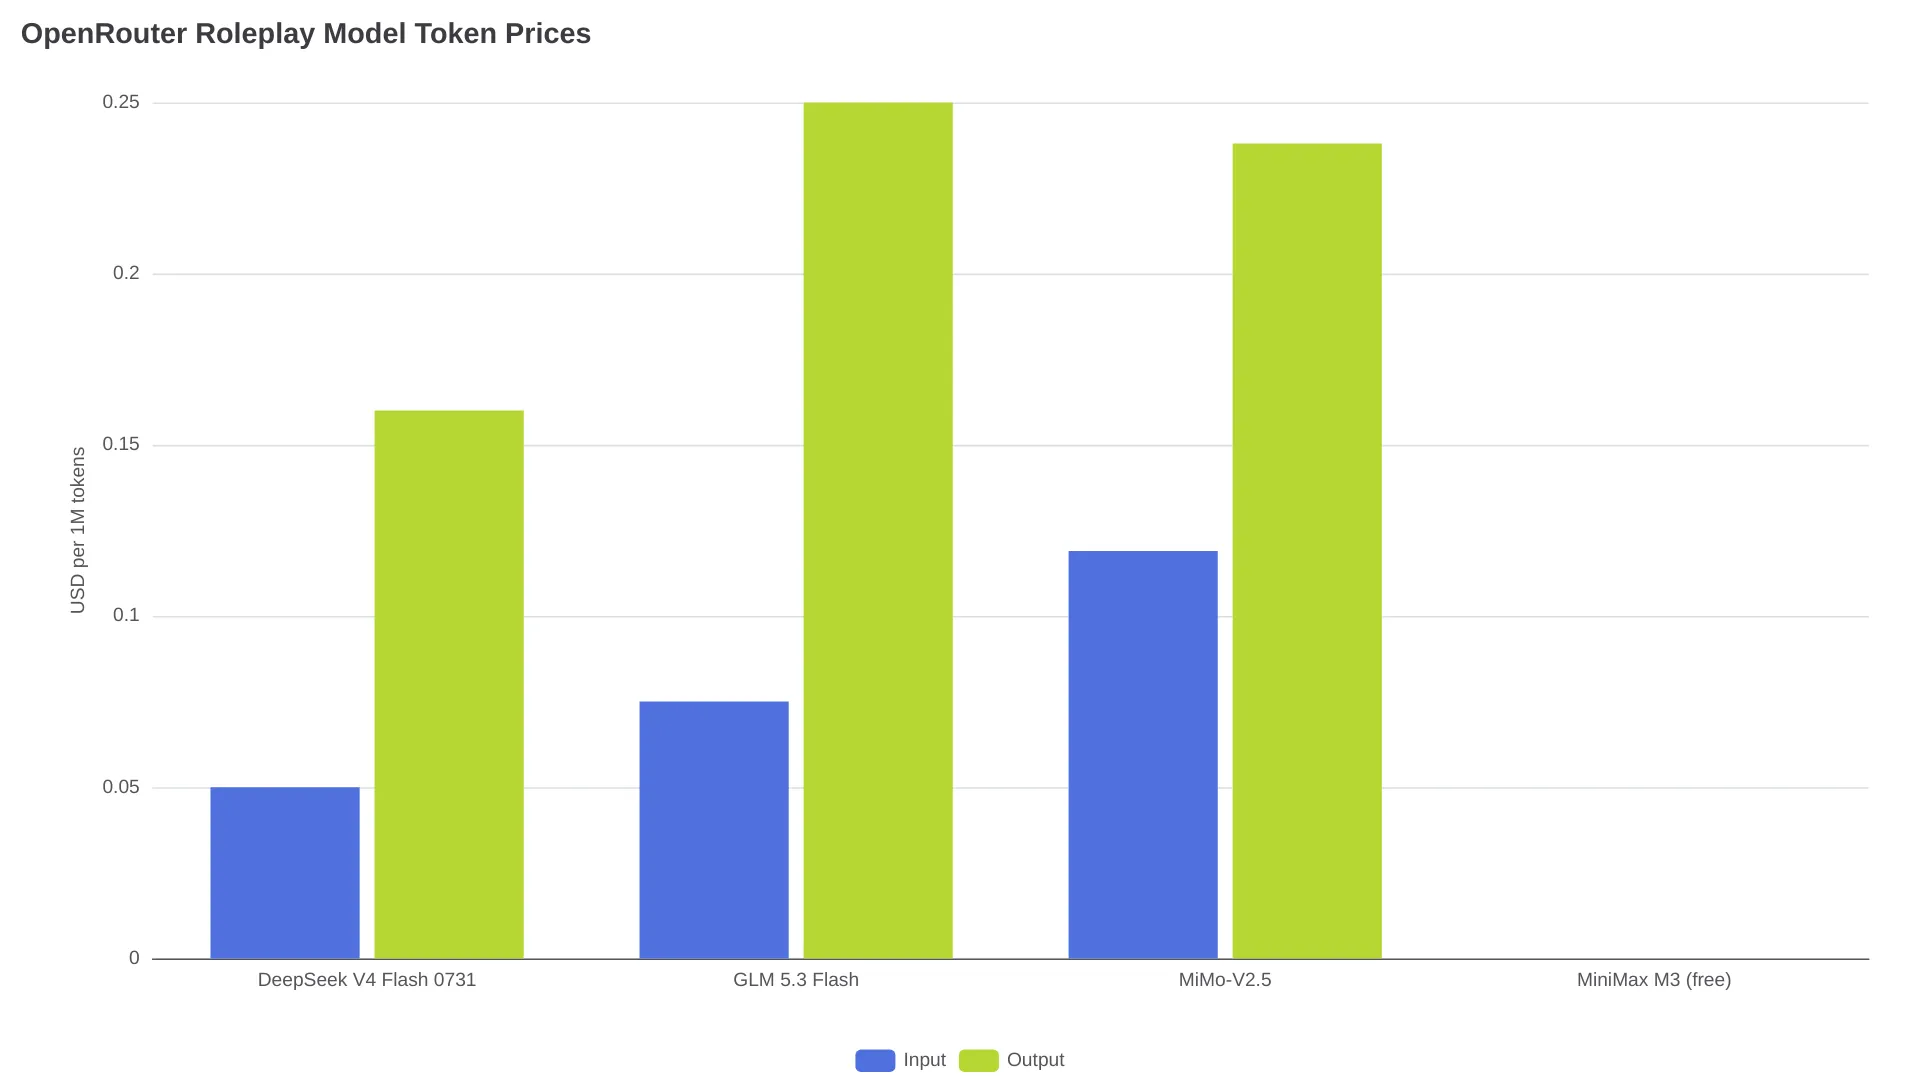
Para roleplay no OpenRouter, a escolha muda conforme sua prioridade: manter uma voz consistente, sustentar um contexto longo ou fazer uma sessão sem gastar nada. No retrato de 2 de setembro de 2026, o DeepSeek V4 Flash 0731 é o primeiro modelo pago a testar como referência de custo e contexto: o OpenRouter informa contexto na faixa de 1M e cobra $0.05 por milhão de tokens de entrada e $0.16 por milhão de tokens de saída. Rotas gratuitas ajudam nos testes, mas capacidade e disponibilidade podem mudar.
Este guia trata do comportamento técnico e dos custos em roleplay ficcional não explícito. Ele não aponta um vencedor universal entre modelos “uncensored” nem publica percentuais de recusas sem um teste controlado e comparável.
Qual modelo de roleplay do OpenRouter usar em 2026?
Defina um modelo pago e uma alternativa gratuita disponível no momento; use o ranking de uso como sinal para montar a lista inicial, não como nota de qualidade.
| Cenário de uso | Primeiro modelo para conferir | Por que considerar | Principal ressalva |
|---|---|---|---|
| Referência paga de custo e contexto | DeepSeek V4 Flash 0731 | Contexto na faixa de 1M, $0.05/$0.16 por 1M tokens e tráfego atual de roleplay no OpenRouter | Uso não equivale a teste controlado de RP |
| Teste priorizando o grátis | MiniMax M3 (free) | Aparece na coleção gratuita ativa do OpenRouter com contexto de aproximadamente 1M | Capacidade, limites e disponibilidade do gratuito podem mudar |
| Comparação paga de baixo custo | GLM 5.3 Flash | Contexto na faixa de 1M, 22 provedores listados e preço temporário de $0.075/$0.25 | O desconto tem prazo; o modelo é posicionado para trabalho agêntico |
| Comparação de preço intermediário | MiMo-V2.5 na coleção de roleplay do OpenRouter | $0.119/$0.238 por 1M tokens e contexto de 1.05M na listagem atual | A página citada traz dados de catálogo e uso, não uma nota controlada de RP |
| Alternativa gratuita automática | openrouter/free | Escolhe uma rota gratuita disponível sem fixar um slug | O modelo por trás da rota pode mudar entre requisições |
Comece pelo DeepSeek como referência paga, confirme o endpoint gratuito atual do MiniMax M3 antes de depender dele e use o GLM 5.3 Flash como segundo controle pago. A seleção se baseia em dados atuais de uso, preço, contexto e roteamento, não em um ranking universal de qualidade de escrita.
O que o ranking de roleplay do OpenRouter realmente mostra
A coleção Roleplay and Creative Writing do OpenRouter é uma página dinâmica de descoberta baseada em uso. Na captura de 2 de setembro de 2026, o DeepSeek V4 Flash aparece em primeiro lugar.
Esse ranking mede uso, não fidelidade ao card do personagem, retenção de nomes, qualidade da prosa ou taxa de recusas. Um modelo popular pode ser apenas barato, rápido, amplamente disponível ou fácil de rotear.
Monte uma lista inicial a partir da coleção e depois rode o mesmo card seguro e a mesma cena de abertura em dois IDs de modelo fixados. Assim você responde a uma questão mais objetiva: qual rota funciona melhor para seu prompt, suas configurações e seu orçamento?
Modelos em foco: contexto, preço e disponibilidade
Os números abaixo vêm das páginas de roleplay, modelos gratuitos e modelos individuais do OpenRouter verificadas em 2 de setembro de 2026. Preços e status gratuito são retratos operacionais daquele momento.
| ID do modelo | Contexto exibido | Preço de entrada / saída por 1M | Rota grátis identificada? | O que os dados indicam |
|---|---|---|---|---|
deepseek/deepseek-v4-flash-0731 | 1,310,720 | $0.05 / $0.16 | Consulte o catálogo ao vivo | Preço pago listado baixo, 30 provedores e failover automático |
minimax/minimax-m3 | 1,048,576 | $0.23 / $0.96 pago | Sim, listado como MiniMax M3 (free) | Contexto amplo e testes sem custo quando o endpoint gratuito está disponível |
z-ai/glm-5.3-flash | 1,310,720 | $0.075 / $0.25 promocional | Consulte o catálogo ao vivo | 22 provedores e 99.89% de disponibilidade em três dias no retrato analisado |
xiaomi/mimo-v2.5 | 1.05M | $0.119 / $0.238 | Não confirmado pela página citada | Sinal de uso na coleção de roleplay e preço pago moderado |
openrouter/free | Página do roteador: 200K | $0 | Roteador, não um modelo fixo | Prático para experimentar; a seleção aleatória reduz a reprodutibilidade |
DeepSeek V4 Flash 0731: referência de custo e contexto
O DeepSeek V4 Flash 0731 tem contexto de 1,310,720 tokens, até 393,216 tokens de conclusão e preço listado de $0.05 por milhão de tokens de entrada / $0.16 por milhão de tokens de saída. A página do OpenRouter lista 30 provedores e descreve os modos de roteamento Balanced, Nitro e Exacto.
Antes de iniciar uma campanha longa, faça o teste com o mesmo card, pois a página do modelo não divulga uma métrica de consistência de personagem.
MiniMax M3: candidato para testar de graça
A coleção de modelos gratuitos do OpenRouter lista o MiniMax M3 por $0 para entrada e saída, com contexto exibido de 1.05M. Já a página paga do MiniMax M3 informa contexto de 1,048,576, entrada de texto/imagem/vídeo, saída de texto e preços pagos de $0.23 por milhão de tokens de entrada / $0.96 por milhão de tokens de saída.
A documentação sobre Free Variant do OpenRouter informa que uma rota :free pode ter disponibilidade e limites de taxa diferentes do modelo pago. Quando a reprodutibilidade for importante, escolha o slug gratuito exato exibido no catálogo ao vivo; use openrouter/free somente se a seleção automática for aceitável.
GLM 5.3 Flash: opção com mais diversidade de provedores
O GLM 5.3 Flash tem janela de contexto de 1,310,720 tokens e aparece com preço de $0.075 por milhão de tokens de entrada / $0.25 por milhão de tokens de saída graças a um desconto promocional de 50% via Z.ai até 9 de setembro de 2026 às 16:00 UTC. A página do OpenRouter lista 22 provedores e 99.89% de disponibilidade em três dias.
A página posiciona o GLM 5.3 Flash para programação eficiente e tarefas agênticas de longo horizonte, não especificamente para roleplay. Avalie a adequação ao RP usando o mesmo prompt, em vez de deduzi-la pela descrição do produto.
MiMo-V2.5 e outras alternativas
O MiMo-V2.5 aparece na coleção de roleplay do OpenRouter com contexto de 1.05M e preços de $0.119 por milhão de tokens de entrada / $0.238 por milhão de tokens de saída. Ele é um controle razoável na faixa intermediária de preço, mas a página citada não publica um resultado controlado de roleplay. Salve um segundo slug exato antes de uma sessão falhar; uma alternativa pré-definida é mais previsível que uma troca aleatória de modelo.
Teste de custo em 1.000 rodadas: gerir o contexto muda a conta
Uma rodada de roleplay corresponde a uma mensagem do usuário e uma resposta do assistente. O OpenRouter cobra por tokens, portanto não existe um preço universal para 1.000 rodadas: boa parte do custo depende de quanto histórico o frontend reenvia.
Este modelo de planejamento considera 1.000 rodadas, 200 novos tokens do usuário por rodada, 500 tokens de saída do assistente por rodada e um prompt fixo de personagem/sistema com 2.000 tokens. No cenário de histórico completo, as 1.000 requisições reenviam a conversa em crescimento, totalizando cerca de 351.85M tokens de entrada e 0.5M tokens de saída.
| Modelo | Cenário de histórico compacto: 4M de entrada + 0.5M de saída | Cenário de histórico completo: 351.85M de entrada + 0.5M de saída |
|---|---|---|
| DeepSeek V4 Flash 0731 ($0.05/$0.16) | $0.28 | $17.67 |
| GLM 5.3 Flash ($0.075/$0.25) | $0.43 | $26.51 |
| MiMo-V2.5 ($0.119/$0.238) | $0.60 | $41.99 |
| MiniMax M3 pago ($0.23/$0.96) | $1.40 | $81.41 |
| MiniMax M3 grátis | $0.00, sujeito a limites | $0.00, sujeito a limites |
A coluna de histórico compacto usa uma média de 4.000 tokens de entrada por requisição. No histórico completo, as mesmas mensagens iniciais são reenviadas repetidamente; por isso, uma janela de contexto ampla não torna automaticamente barata uma campanha de 1.000 rodadas.
Nessas premissas, o prompt final com histórico completo chega a aproximadamente 701,500 tokens de entrada, antes de formatação e metadados extras. Uma janela de 1M de contexto comporta esse exemplo, mas respostas mais longas, cards maiores, lorebooks ou templates ocultos podem ultrapassar o limite. Capacidade de contexto não é memória automática.
O cache de prompt pode reduzir o custo de entradas repetidas quando o provedor e o caminho da requisição oferecem suporte. Consulte a página Activity do OpenRouter em vez de presumir que todos os frontends recebem o mesmo tratamento de cache. O guia de preços do OpenRouter explica o modelo mais amplo de cobrança por tokens.
O que um teste seguro de consistência revela — e o que não revela
Uma comparação não explícita pode usar um personagem adulto fictício, uma cena inofensiva e configurações idênticas para todos os modelos:
- Inclua três fatos duradouros no card do personagem, como profissão, localização e um objetivo não sensível.
- Exija narração em terceira pessoa ou um ponto de vista claramente definido.
- Faça 20 turnos com a mesma abertura e limite de saída entre 400 e 600 tokens.
- Nos turnos 5, 10 e 20, peça ao personagem que aja com base em um fato anterior sem repeti-lo.
- Registre mudanças de nome, fatos contraditórios, troca indesejada de ponto de vista, repetição, respostas vazias e recusas.
Isso compara seu prompt e sua rota, não uma qualidade universal dos modelos. Uma recusa pode vir do modelo, do provedor, do classificador do frontend ou do prompt; por isso, este guia não informa taxa de recusas. Para velocidade, registre a latência até o primeiro token e os tokens gerados por segundo em três execuções idênticas, anotando o modelo e a rota do provedor.
Por quanto tempo o plano grátis do OpenRouter sustenta roleplay?
O guia oficial do SillyTavern do OpenRouter informa que contas com menos de $10 em créditos comprados recebem 50 requisições diárias para modelos gratuitos. Após comprar pelo menos $10 em créditos, a franquia passa para 1.000 requisições por dia. O guia também indica um limite de 20 requisições por minuto.
Se cada geração do assistente representar uma rodada, isso equivale a aproximadamente 50 rodadas iniciais ou 1.000 rodadas iniciais por dia. Regenerações, tentativas novamente, requisições com falha e fluxos com várias mensagens também consomem requisições, então o número de cenas concluídas pode ser menor.
As duas opções gratuitas se comportam de maneiras diferentes:
model-name:freefixa a variante gratuita de um modelo nomeado. É mais reproduzível, mas o endpoint pode desaparecer ou sofrer limitação de taxa.openrouter/freeseleciona automaticamente um modelo gratuito elegível. A documentação do Free Models Router do OpenRouter diz que a escolha é aleatória após a filtragem de capacidades, e a resposta identifica o modelo utilizado. É prático para experimentar, mas a voz do personagem pode mudar entre requisições.
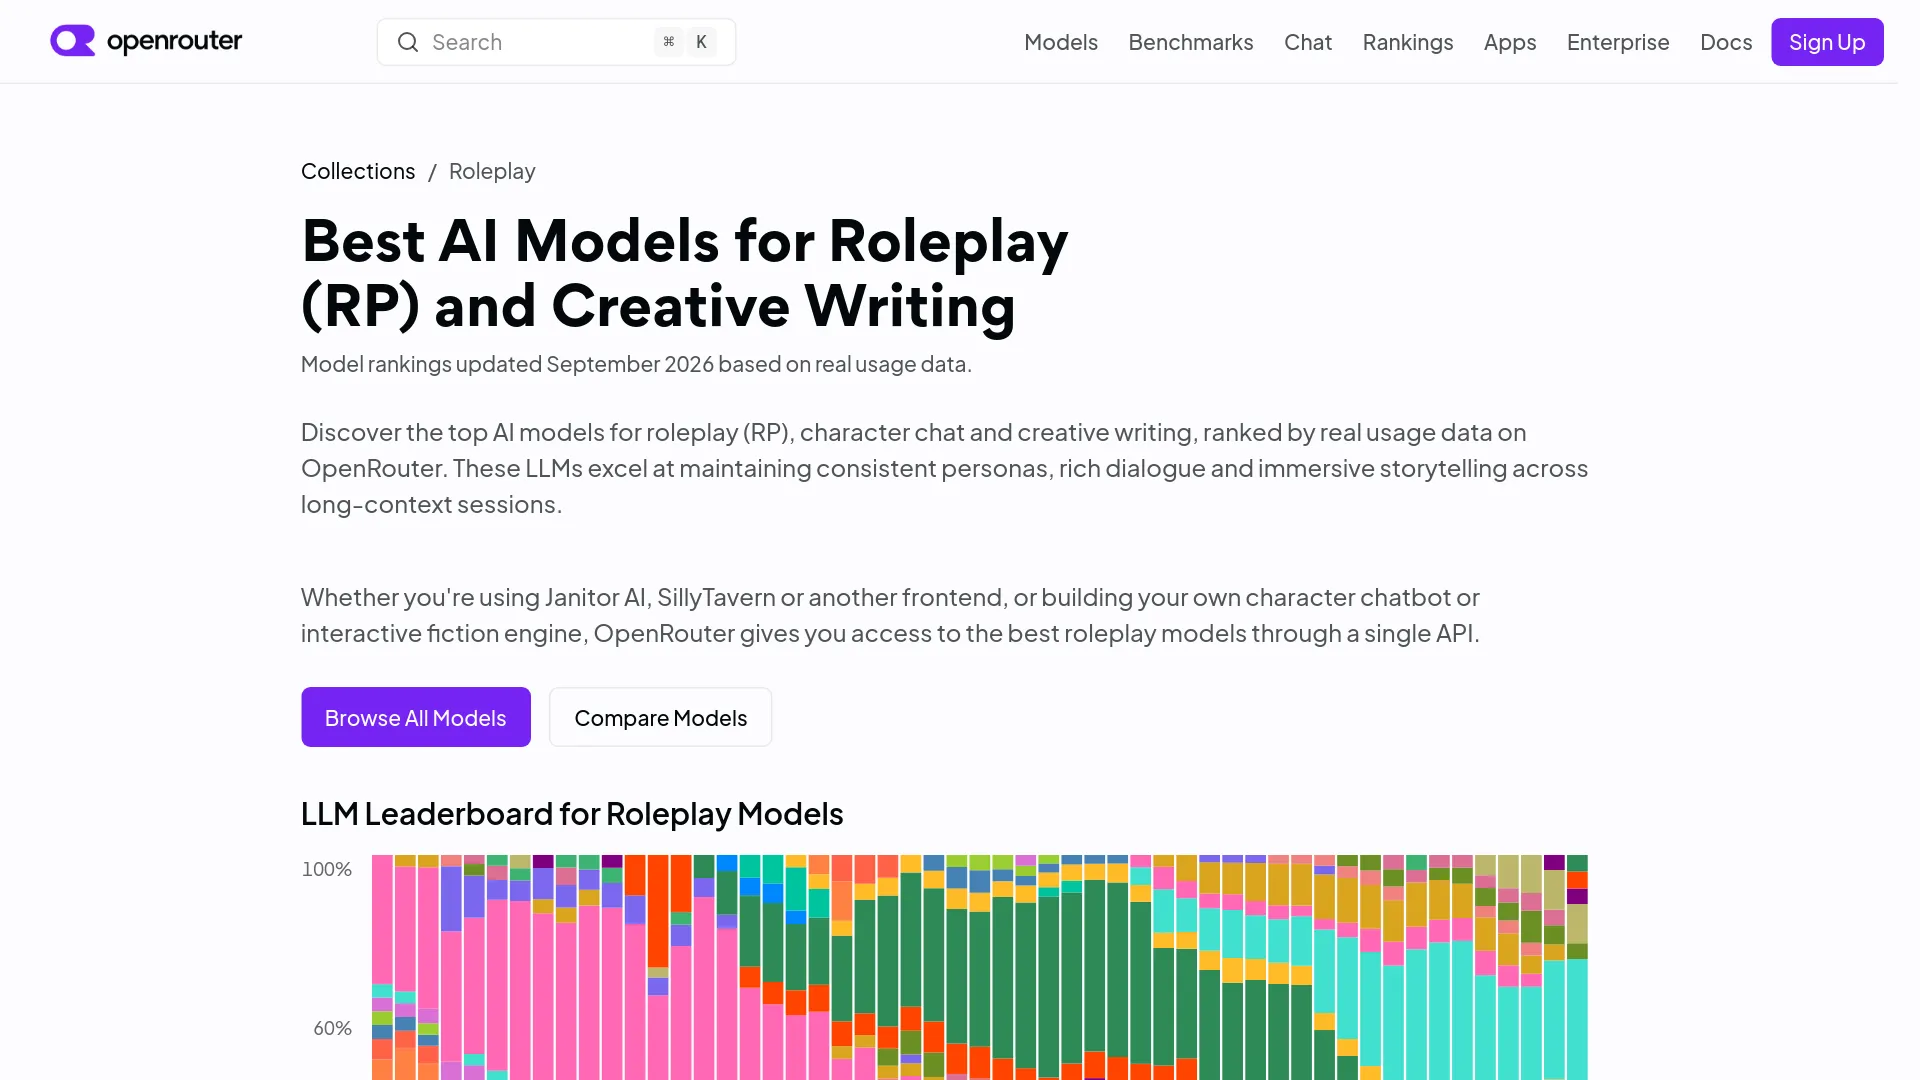
Confira a coleção de modelos gratuitos ao vivo do OpenRouter antes de configurar um frontend. Não monte uma campanha longa em torno de um slug gratuito copiado de um guia antigo.
Como configurar o SillyTavern para uma sessão estável no OpenRouter
O fluxo oficial do OpenRouter usa Chat Completion, e não Text Completion. Uma conexão bem-sucedida com a chave ainda não garante que o modelo escolhido, a rota do provedor ou o tamanho de contexto selecionado consigam gerar uma resposta.
- Abra o painel API Connections do SillyTavern.
- Selecione API Type: Chat Completion.
- Selecione Source: OpenRouter.
- Autorize pelo fluxo disponível ou cole uma chave de API criada nas configurações de chaves do OpenRouter.
- Clique em Connect, escolha o slug exato do modelo e envie uma Test Message.
- Salve um perfil de conexão para o modelo pago e outro para a alternativa gratuita.
Comece com um tamanho de contexto aceito pelo endpoint exato, streaming ativado e um limite moderado de saída. Mantenha o card do personagem enxuto e resuma turnos antigos antes que o prompt se aproxime do limite do endpoint. Teste as configurações de sampling separadamente, pois elas podem alterar o tamanho e o ritmo das respostas.
Se a lista suspensa estiver vazia, reconecte e atualize a lista de modelos. Se a conexão funcionar, mas a geração falhar, verifique o slug, os créditos, a disponibilidade do provedor e o estouro de contexto antes de reescrever o prompt.
Configuração do JanitorAI e correção de erros
A API do OpenRouter é compatível com OpenAI. O endpoint padrão de chat completions documentado no Quickstart do OpenRouter é:
https://openrouter.ai/api/v1/chat/completionsO artigo não se baseia em uma captura atual da interface do JanitorAI. Portanto, use o processo abaixo como padrão genérico para integração compatível com OpenAI e confirme os campos disponíveis na tela atual do JanitorAI:
- Crie uma chave de API do OpenRouter e mantenha-a privada.
- Escolha a opção atual de API compatível com OpenAI ou API personalizada, se estiver disponível.
- Informe a URL completa de chat completions quando o campo solicitar um endpoint de conclusão.
- Cole o ID atual e exato do modelo no OpenRouter, incluindo
:freepara uma variante gratuita. - Salve, atualize o JanitorAI e teste com uma mensagem curta e não explícita.
| Sintoma | Causa provável | Primeira correção |
|---|---|---|
| 401 ou token inválido | A chave está errada, expirou ou foi colada com caracteres extras | Gere uma nova chave e cole-a novamente; não use uma chave pública compartilhada |
| 404 ou endpoint inexistente | O slug do modelo ou a URL está desatualizado | Copie o slug atual do OpenRouter e confira o endpoint completo |
| 429 | Limite diário/por minuto do modelo gratuito ou sobrecarga do provedor | Aguarde, reduza as tentativas, troque para a alternativa fixada ou use uma rota paga |
| Resposta vazia | Rota não suportada, limite de saída ou estouro de contexto | Reduza as configurações de contexto/saída e teste o modelo diretamente no OpenRouter |
| O bot esquece o início | O frontend truncou o histórico antigo | Reduza o prompt, resuma os turnos mais antigos e ajuste o contexto ao endpoint |
| Recusa ou mudança repentina de estilo | Política do provedor ou uma rota alternativa diferente | Confira o modelo/provedor efetivo e use um prompt neutro de teste; “uncensored” não é garantia |
Privacidade, roteamento por provedores e conformidade
O FAQ do OpenRouter informa que o serviço registra metadados básicos das requisições, como horários, modelo e contagem de tokens, enquanto prompts e conclusões não são registrados por padrão, a menos que o usuário opte por isso. Os provedores upstream podem ter suas próprias políticas de retenção e treinamento.
Zero Data Retention pode restringir o roteamento a provedores que atendam à política de retenção selecionada, mas isso pode remover algumas rotas gratuitas. Acesso gratuito não é garantia de privacidade, e “uncensored” não é uma característica técnica estável: provedores podem aplicar suas próprias políticas, e o roteamento pode alterar qual provedor atende a requisição.
Use prompts ficcionais não explícitos e não tente contornar as proteções dos provedores.
Perguntas frequentes
Qual é o melhor modelo do OpenRouter para roleplay neste momento?
Neste retrato, o DeepSeek V4 Flash 0731 é a referência paga para comparação de custo e contexto. Ele reúne evidências de uso atual em roleplay no OpenRouter, contexto na faixa de 1M e preços de $0.05/$0.16 por milhão de tokens, mas não representa uma nota universal de qualidade obtida em teste controlado.
Qual é o melhor modelo gratuito do OpenRouter para roleplay?
Não há um vencedor permanente: o MiniMax M3 é o candidato inicial gratuito na coleção ao vivo verificada aqui, enquanto openrouter/free é mais prático, mas menos reproduzível.
Quanto custam 1.000 rodadas de roleplay?
Com as premissas deste guia, o uso com histórico compacto custa cerca de $0.28 no DeepSeek V4 Flash 0731 e $0.43 no GLM 5.3 Flash; o modelo de histórico completo chega a $17.67 e $26.51, respectivamente.
Uma janela de contexto maior impede o modelo de esquecer?
Não. Contexto é o máximo que o endpoint aceita, não uma garantia de que todos os detalhes serão usados corretamente; resumos e limites para turnos recentes continuam importantes.
Por que meu modelo de roleplay recusou ou mudou de comportamento?
O provedor, a rota alternativa, o endpoint gratuito ou o limite prático de contexto podem ter mudado. Portanto, confirme o ID e a rota efetivos do modelo antes de tratar uma recusa isolada como característica geral do modelo.
Rode o mesmo card seguro de 20 turnos no DeepSeek V4 Flash 0731 e em um endpoint gratuito atual, depois salve ambos como perfis nomeados. A rota paga oferece preços e disponibilidade mais previsíveis; a gratuita permite experimentar em troca de capacidade e identidade do modelo variáveis.