 AIREITER
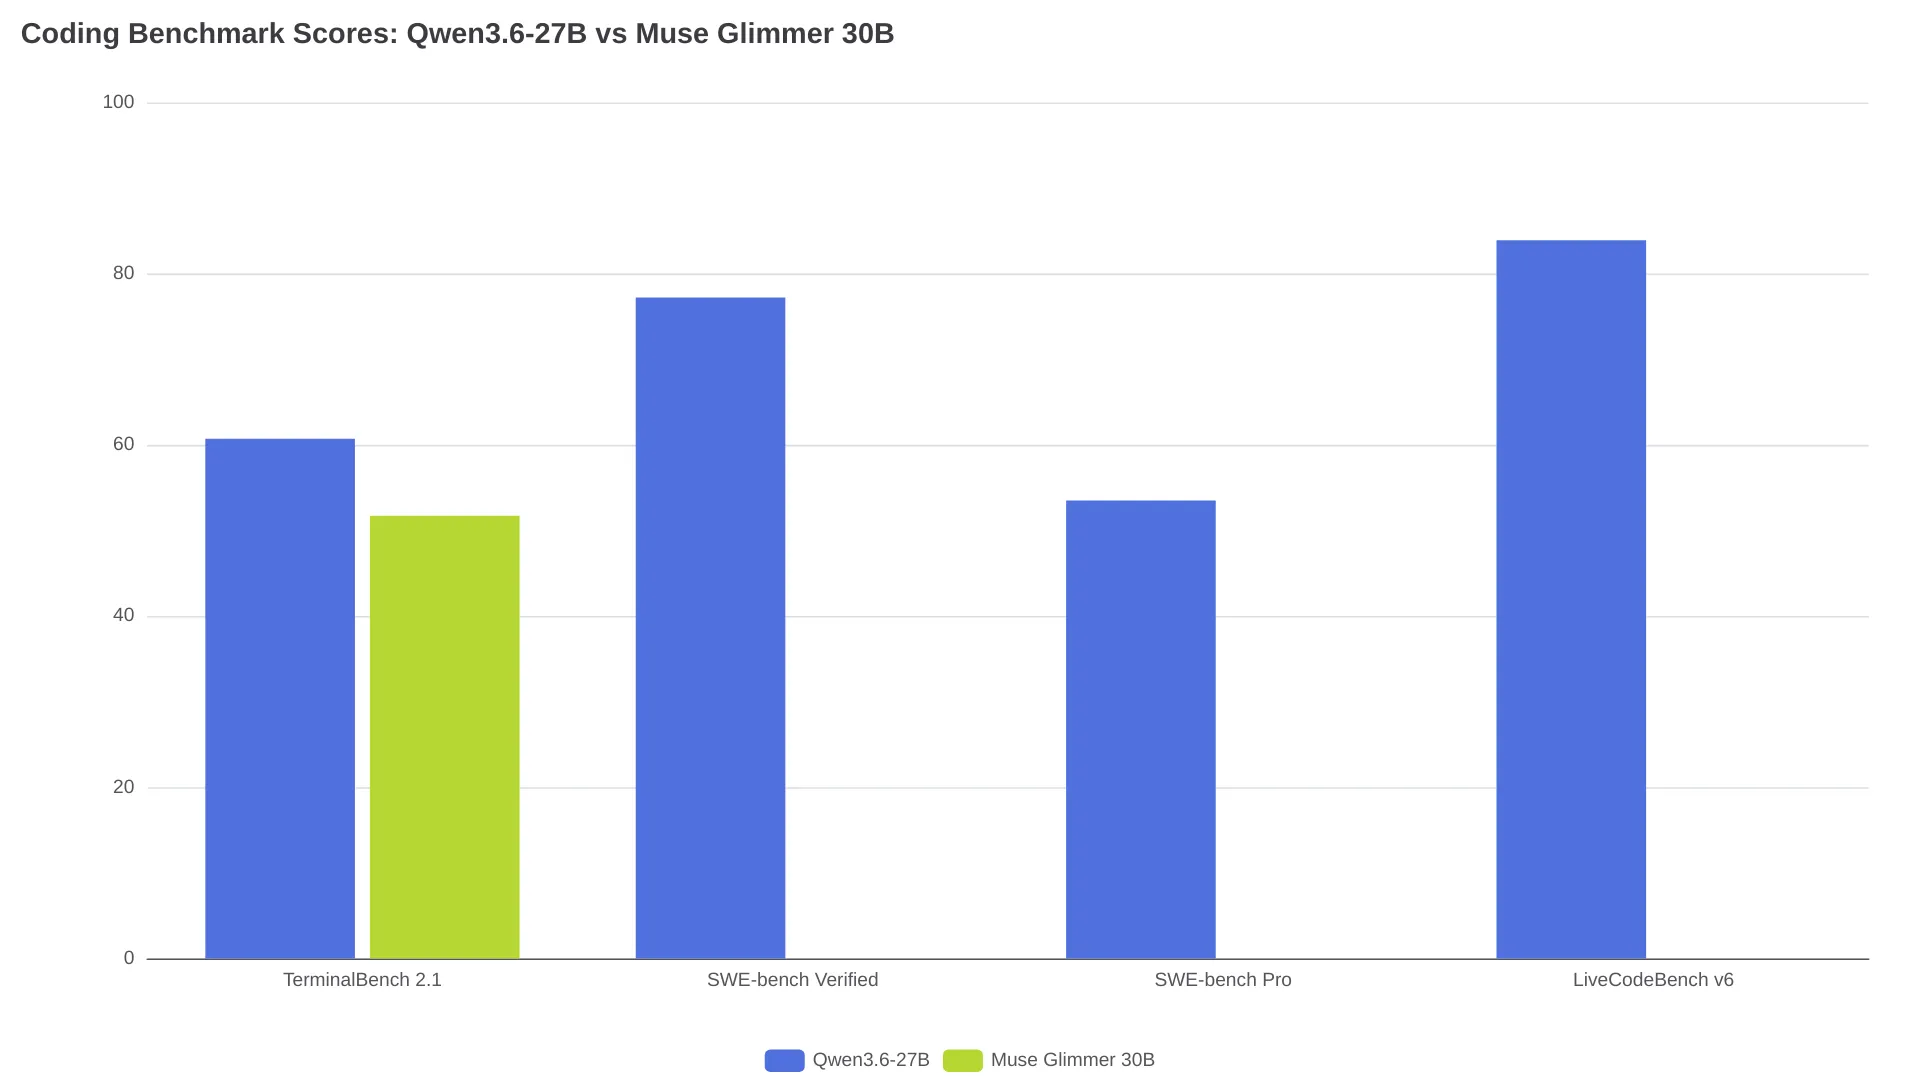
Para quem roda modelos localmente, a escolha entre Muse Glimmer 30B e Qwen3.6-27B depende tanto da GPU quanto da capacidade de programar. O Qwen3.6-27B chegou em abril de 2026 com uma tabela completa de benchmarks em seu model card no Hugging Face. O Muse Glimmer 30B veio depois, em agosto de 2026, como um lançamento de pesos abertos da Meta, e a comunidade de LLMs locais logo colocou os dois frente a frente. Nos números principais, o Qwen sai na frente: 60,7 contra 51,7 no TerminalBench 2.1 e 77,2 no SWE-bench Verified oficial. Mas o Glimmer tem uma vantagem de VRAM que muda bastante o que é possível rodar em uma GPU só.
TerminalBench 2.1: vantagem de 9 pontos para o Qwen
O TerminalBench mede a confiabilidade de agentes que trabalham em terminal ao longo de várias etapas, incluindo uso de ferramentas e manutenção de contexto em sessões extensas. Nas discussões da comunidade vinculadas abaixo, o TerminalBench 2.1 aparece com frequência como o resultado disponível para comparar os dois em tarefas de agentes de programação.
Pontuações do TerminalBench 2.1 relatadas pela comunidade, reunidas em discussões no r/LocalLLaMA entre 10 e 11 de agosto de 2026:
| Modelo | TerminalBench 2.1 | Tipo de fonte |
|---|---|---|
| Qwen3.6-27B | 60.7 | Relatado pela comunidade |
| Muse Glimmer 30B | 51.7 | Relatado pela comunidade |
| Gemma 4 31B | 43.4 | Relatado pela comunidade |
Há uma ressalva importante: o TerminalBench avalia o conjunto formado pelo modelo e pelo harness, não apenas o modelo-base. O card oficial do Qwen3.6-27B especifica um harness Harbor/Terminus-2 com timeout de 3 horas, 32 CPUs, 48 GB de RAM, saída máxima de 80K, contexto de 256K e média de cinco execuções. A nota do Glimmer pode refletir uma configuração diferente ou menos otimizada do harness. Por isso, a diferença de 9 pontos pode diminuir ou aumentar conforme a configuração do seu agente.
Benchmarks publicados de código: o Qwen tem dados, o Glimmer ainda não
O Qwen3.6-27B tem resultados oficiais de benchmark publicados no model card. Nas fontes consultadas para esta comparação, não foram encontrados resultados oficiais de SWE-bench, LiveCodeBench ou benchmark comparável de programação com agentes para o Muse Glimmer até agosto de 2026. Na prática, o Qwen tem uma base de evidências publicadas mais sólida, mas ainda não existe um confronto oficial diretamente comparável.
Benchmarks oficiais de programação do Qwen:
| Benchmark | Qwen3.6-27B (oficial) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
São resultados publicados pelo fornecedor. O model card informa que as avaliações do SWE-bench usam o scaffold interno de bash e edição de arquivos do Qwen, com temperatura 1.0, top-p de 0.95 e janela de contexto de 200K. Os resultados do SWE-bench Pro foram calculados sobre um conjunto refinado de tarefas, no qual o Qwen corrigiu itens problemáticos; portanto, a comparação direta com valores de rankings públicos pode não ser equivalente. A análise de terceiros da morphllm observa que esses resultados dependem do scaffold de agente do próprio Qwen e têm reprodução independente limitada.
Testes locais de programação: o que os usuários encontraram
Teste com OpenCode em um M5 Pro
Um desenvolvedor executou o Muse Glimmer em quantização Q4, na build da Unsloth, em um M5 Pro com 48 GB de RAM via OpenCode. O modelo usou aproximadamente 20 GB de RAM e gerou 17 tokens por segundo. A conclusão foi:
"No geral, fica abaixo do Qwen3.6 27B" - u/curiousily_
As respostas para programação de frontend e backend foram avaliadas como inferiores às do Qwen. Por outro lado, o autor destacou um ponto positivo: o Muse Glimmer não falhou em nenhuma chamada de ferramenta durante o teste. Não foram configurados loops de raciocínio nem pensamento estendido, o que pode ter limitado o desempenho do Glimmer.
A armadilha do max_tokens
Outro usuário, no r/LocalLLM, descobriu que o Muse Glimmer pode parecer muito pior do que realmente é quando o orçamento de tokens de saída é pequeno demais. O modelo consome esse orçamento no raciocínio antes de gerar uma resposta visível, levando a respostas vazias ou truncadas. Ao aumentar max_tokens, o usuário elevou o resultado de seu harness de teste de 6/13 para 11/13 tarefas aprovadas, quase dobrando a taxa de aprovação sem mudar o modelo. Se você testar o Glimmer com limites padrão de saída, talvez esteja medindo sua configuração, não o modelo.
Loops no terminal com Hermes
Outro usuário relatou que o Muse Glimmer ficou preso em comandos excessivos de terminal ao ser usado com o framework de agentes Hermes, comportamento que ele não havia encontrado com o Qwen3.6-27B na mesma configuração. O relato anedótico segue a mesma direção da diferença observada no TerminalBench, embora não permita separar o efeito do modelo da configuração do Hermes.
Eficiência de tokens: uma vantagem ainda qualitativa
Uma publicação com galeria de benchmarks feita por u/NoFaithlessness951 levantou, no Reddit, uma questão de eficiência:
"Um pouco menos inteligente que o Qwen, mas usa muito menos tokens por tarefa." - u/NoFaithlessness951
Essa é uma observação qualitativa da comunidade, não uma medição controlada de tokens por tarefa concluída com sucesso. Nenhum estudo frente a frente quantificou a vantagem de tokens do Glimmer sobre o Qwen usando tarefas, taxas de sucesso e dados de latência equivalentes. Vale tratar essa alegação como um indício promissor, não como um fato estabelecido.
VRAM e contexto: onde o Glimmer leva clara vantagem
É neste ponto que o Muse Glimmer se destaca de forma decisiva. Um usuário no r/LocalLLaMA demonstrou que o Muse Glimmer 30B em Q4_K_XL, com decodificação especulativa DFlash, projetor multimodal e cache KV completo em F16, cabe em aproximadamente 22-23 GB de uma única RTX 3090, com uma janela de contexto configurada para 262.144 tokens.
Na mesma RTX 3090 e com a mesma quantização Q4_K_XL:
| Modelo | Contexto KV em F16 | Contexto KV em Q8 | VRAM usada |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | Cabe em 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | Cabe em 24 GB |
O autor classificou o contexto F16 de 70K do Qwen como "no limite do inutilizável" para fluxos de trabalho que carregam no prompt o contexto de repositórios grandes.
Desempenho relatado do Muse Glimmer nessa RTX 3090:
- Geração: 64-124 tokens por segundo, variando entre código e prosa
- Processamento de prompt: ~1.400 tokens por segundo
- Recuperação em contexto longo: passou em um teste haystack de duas agulhas com ~150K tokens na primeira tentativa
Na mesma máquina, o Qwen3.6-27B exige compressão do cache KV em Q8, sacrificando fidelidade de saída em troca de mais contexto, ou offload para uma máquina mais potente. O usuário relatou mover o Qwen para seu DGX Spark quando precisava do contexto completo, um equipamento significativamente mais caro.
Em hardware mais avançado, uma build NVFP4 do Qwen3.6-27B em um DGX Spark chegou a 28-33 tokens por segundo em sessão única, em contextos de até 128K, segundo a análise de benchmarks da kie.ai. Já uma build Unsloth Muse Glimmer Q5_K_M em uma RTX 5090 teria alcançado 220-253 tokens por segundo ao gerar patches de código, por meio de um caminho DFlash corrigido do llama.cpp.
Qual modelo faz mais sentido para você?
| Seu cenário | Escolha | Motivo |
|---|---|---|
| Programação isolada, geração em uma única tentativa | Qwen3.6-27B | Evidências mais fortes em benchmarks publicados de programação; lidera na comparação comunitária disponível do TerminalBench 2.1 |
| Programação com agentes e contexto grande em uma única GPU de 24 GB | Muse Glimmer 30B | 262K de contexto F16 contra 70K do Qwen no mesmo hardware, usando a configuração Q4_K_XL/DFlash |
| Tarefas longas de terminal | Qwen3.6-27B | 60.7 contra 51.7 no TerminalBench 2.1; há relato comunitário de loop em framework de agentes com o Glimmer |
| Alto volume com sensibilidade a custo | Muse Glimmer 30B (possivelmente) | Um relato da comunidade sugere menos tokens por tarefa; não há comparação equivalente de custo por sucesso |
| Programação em nível de repositório com contexto grande | Muse Glimmer 30B (se a VRAM for limitada) | Para contexto grande em 24 GB, o Qwen precisa de compressão KV em Q8 ou de múltiplas GPUs |
| Máxima precisão em programação, sem limite de hardware | Qwen3.6-27B | Benchmarks publicados mais fortes e pontuações oficiais |
Perguntas frequentes
O Muse Glimmer tem uma pontuação oficial no SWE-bench?
Não. Nas fontes consultadas para esta comparação, não foi encontrada nenhuma pontuação oficial de SWE-bench, LiveCodeBench ou TerminalBench para o Muse Glimmer 30B até agosto de 2026. A pontuação de 51.7 no TerminalBench 2.1 vem de testes da comunidade em tópicos do Reddit, não de uma avaliação oficial da Meta.
Os dois modelos rodam em uma única RTX 3090?
Sim. O Muse Glimmer 30B em Q4_K_XL cabe com contexto de 262K e cache KV completo em F16 usando ~22-23 GB. O Qwen3.6-27B em Q4_K_XL também cabe, mas fica limitado a 70K de contexto F16 ou 125K com compressão de cache KV em Q8 na mesma GPU.
O Muse Glimmer é censurado em tarefas de programação?
Um usuário relatou que o Muse Glimmer se recusou a ajudar a depurar código Python de controle de mouse, tratando-o como uma possível preocupação de segurança. Trata-se de um único relato anedótico, com prompt de sistema e configuração não especificados. Isso não é suficiente para determinar se o comportamento vem do próprio modelo ou do ambiente de inferência.
Qual é melhor para fluxos de programação com agentes?
O Qwen3.6-27B é mais confiável para tarefas longas de agentes no terminal, com base nas pontuações do TerminalBench e em relatos da comunidade. O Muse Glimmer 30B é mais viável em hardware limitado graças à eficiência de VRAM e pode usar menos tokens por tarefa, o que talvez reduza custo e latência em loops de agentes de alto volume. Ainda assim, nenhuma comparação controlada quantificou isso.
Que valor de max_tokens devo usar para programar com o Muse Glimmer?
Defina um orçamento generoso de saída. Um usuário observou que limites apertados de max_tokens faziam o Glimmer esgotar seu orçamento no raciocínio antes de produzir uma resposta visível, resultando em respostas vazias ou truncadas que pareciam falhas. Ao elevar o limite, ele melhorou seu harness de teste de 6/13 para 11/13 tarefas aprovadas. O model card do Qwen3.6-27B recomenda 32,768 tokens para consultas gerais e 81,920 para tarefas difíceis de benchmark; usar o mesmo orçamento de saída é um ponto de partida razoável para o Glimmer até que a Meta publique sua própria orientação.