 AIREITER
Lançado em 10 de agosto de 2026, o Muse Glimmer colocou uma questão interessante para quem roda IA localmente: um modelo multimodal denso de 30B consegue tomar o lugar do Qwen 3.6 27B em hardware de consumo? Em parte, sim. Ele cabe em uma única RTX 3090 com os 262K de contexto completos e chega a 236 tok/s em uma RTX 5090 com DFlash. Por outro lado, fica 9 pontos abaixo do Qwen 3.6 27B no TerminalBench 2.1 e tende a recusar tarefas de automação no nível do sistema operacional.
O que é o Muse Glimmer 30B?
O Muse Glimmer é um modelo multimodal denso de 30B de parâmetros, lançado pela Meta Superintelligence Labs sob licença Apache 2.0. O foco está em fluxos de trabalho locais com agentes residentes, e não em liderar rankings de programação. Sua arquitetura reúne um decodificador de texto de 27,9B, um encoder visual ViT de 1,9B e um projetor multimodal baseado em GELU, o que permite compreender texto e imagens. Os detalhes de arquitetura abaixo vêm do post sobre o suporte Day-0 do SGLang.
Arquitetura em números
| Especificação | Detalhe |
|---|---|
| Total de parâmetros | 30B |
| Decodificador de texto | 27,9B denso |
| Encoder visual | ViT de 1,9B |
| Camadas Transformer | 52 |
| Atenção | Grouped-query (32 cabeças de query, 2 cabeças KV - GQA 16:1) |
| Feed-forward | SwiGLU |
| Janela de contexto | 128K+ (testado até 262K) |
| Licença | Apache 2.0 |
A arquitetura combina dois tipos de atenção: a cada quatro etapas, há três camadas de sliding-window attention com janelas de 2.048 tokens, seguidas por uma camada de atenção sobre a sequência inteira. Nas camadas de janela local, o modelo usa RoPE; nas de atenção total, NoPE. Essa abordagem permite estender o contexto além do limite de treinamento. A proporção 16:1 de grouped-query attention também reduz o cache KV: uma medição da comunidade aponta cerca de 1,8 GiB para 131K tokens em F16. É por isso que o modelo mantém o contexto completo em uma GPU de 24 GB, enquanto o Qwen 3.6 27B chega a 70K tokens na mesma configuração F16.
Seu hardware consegue rodar o Muse Glimmer?
Isso depende bastante da quantização escolhida. O SGLang disponibiliza checkpoints oficiais em BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic e MLX de 4 bits. Testadores da comunidade também levaram o modelo a GGUF de 2 bits, voltado a máquinas com VRAM extremamente limitada.
VRAM exigida em cada configuração
| Configuração | VRAM aproximada | Hardware indicado |
|---|---|---|
| BF16 | ~60 GB | Uma H100 |
| NVFP4 + MXFP8 | ~19,5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB para speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + contexto de 262K | ~22-23 GB | RTX 3090 (24 GB) |
| GGUF de 2 bits | ~14 GB | RTX 4060 Ti / hardware de entrada |
| MLX Q4 (Apple Silicon) | Memória unificada | Mac mini / MacBook Pro |
Um usuário do Reddit demonstrou que o Muse Glimmer em Q4_K_XL, com decodificação especulativa DFlash, arquivo de projeção multimodal e cache KV em F16, ocupa confortavelmente 22-23 GB em uma RTX 3090. E isso com o contexto total de 262.144 tokens ativado. No primeiro teste, foram encontrados dois needles em um haystack de aproximadamente 150K tokens.
Como comparação, o Qwen 3.6 27B, na mesma RTX 3090, alcança apenas 70K tokens com cache KV F16, ou 125K com cache KV Q8. O Gemma 4 31B chega a 52K em F16 ou 81K em Q8. A eficiência do cache KV, resultado da proporção GQA de 16:1 do Muse Glimmer, é o principal motivo para ele sustentar mais contexto no mesmo hardware.
Caminhos para instalar: Em GPUs NVIDIA, use SGLang ou llama.cpp com o checkpoint NVFP4 ou GGUF e ative --speculative-algorithm DFLASH. No Apple Silicon, use o backend MLX, pois o DFlash não está disponível. Um usuário de M3 Max com 96 GB de memória unificada relatou 17 tokens/s e disse que o Muse Glimmer foi mais rápido que Qwen e Gemma naquele sistema.
Qual é a velocidade do Muse Glimmer?
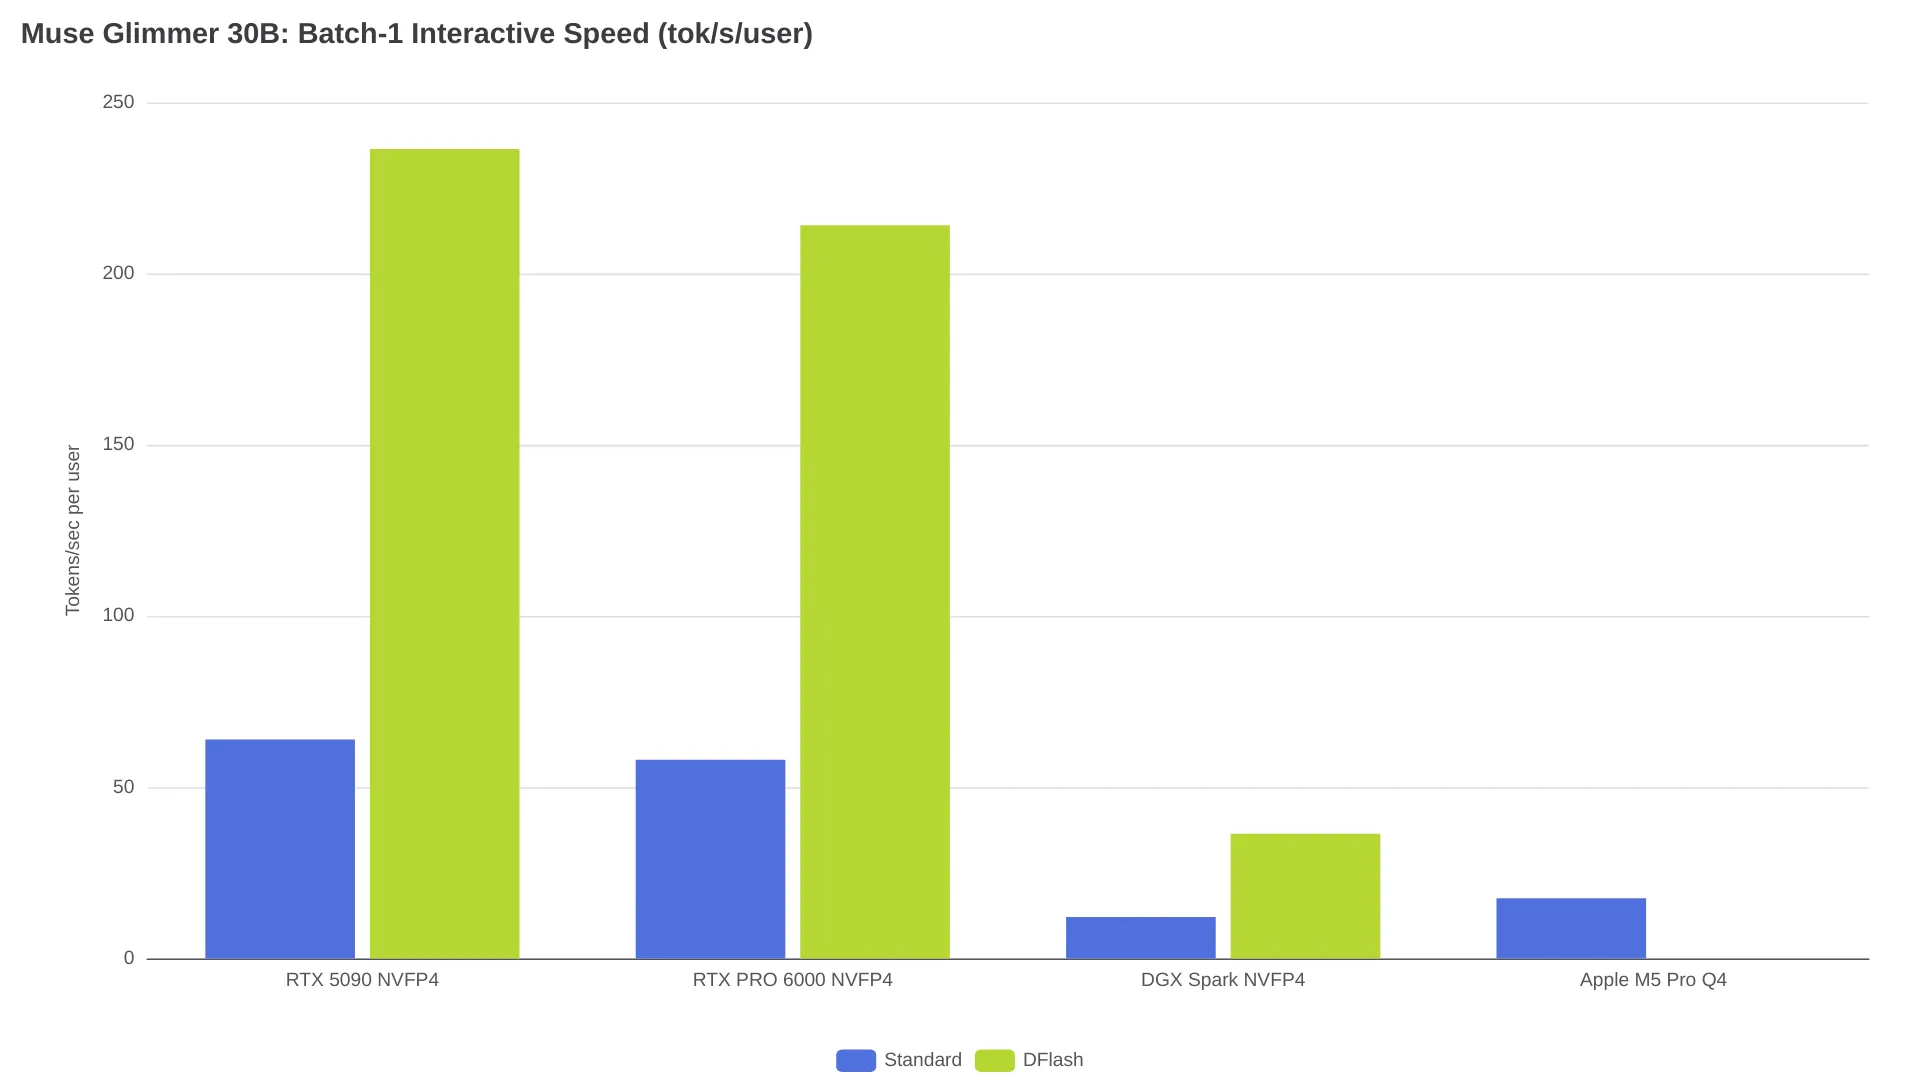
O SGLang publicou benchmarks em sete configurações de hardware, com batches de 1 a 8. A decodificação especulativa DFlash, ativada por --speculative-algorithm DFLASH, entrega entre 1,9x e 4,3x mais desempenho no throughput interativo de batch 1 nas plataformas NVIDIA.
Números principais dos benchmarks do SGLang
| Plataforma | Precisão | Decodificação | Batch 1 tok/s/usuário | Batch 8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Padrão | 17.6 | 56.9 |
Os 1.452 tokens de saída por segundo em batch 8 na RTX 5090 representam throughput agregado. Para inferência local de um único usuário, o número relevante é 236 tok/s com DFlash em NVFP4. Sem DFlash, a mesma configuração cai para 63,9 tok/s. Os relatos da comunidade são compatíveis com isso: um usuário de RTX 5090, usando a quantização Q5_K_M da Unsloth, relatou entre 220 e 253 tokens/s.
O desempenho do DFlash varia conforme as taxas de aceitação do draft. Usuários em Vulkan/RX 7900 XTX e SYCL/B70 relataram baixa aceitação do draft e throughput geral inferior.
Muse Glimmer ou Qwen 3.6 27B: qual escolher?
Desempenho no TerminalBench 2.1
| Modelo | TerminalBench 2.1 | Contexto na RTX 3090 (KV F16) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
Pontuações do TerminalBench 2.1 citadas em uma discussão da comunidade. Os números de contexto vêm de testes em uma RTX 3090.
O Qwen 3.6 27B abre 9 pontos de vantagem no TerminalBench 2.1, benchmark que boa parte da comunidade considera essencial para avaliar se um modelo consegue executar comandos de terminal confiáveis durante tarefas longas. Em testes diretos de programação, a diferença se mantém: na suíte privada de avaliação de um usuário, o Qwen marcou 12/13, contra 11/13 do Glimmer. O Qwen também gerou corretamente, na primeira tentativa, uma página de turismo sobre Tóquio com 953 linhas; o Glimmer produziu menos de 200 linhas (thread completo).
"nem chega perto do Qwen 3.6 27B" - usuário do Reddit BarberIcy366, após o Glimmer gerar apenas 220 linhas de HTML para um jogo de sinuca 8-ball, consumindo 21.000 tokens (r/LocalLLaMA). O mesmo tópico inclui o relato de que o Qwen 3.6 27B concluiu uma implementação de Tetris 1,7x mais rápido com MTP ativado.
Ainda assim, o Glimmer tem vantagens reais em cenários específicos:
- Capacidade de contexto: 262K tokens em uma única RTX 3090, contra 70K do Qwen com a mesma configuração de KV F16 — vantagem de 3,7x para trabalhar com bases de código grandes.
- Eficiência do cache KV: A proporção GQA de 16:1 torna o cache KV do Glimmer muito menor, liberando mais VRAM para contexto.
- Recursos de visão: O Glimmer já é multimodal; o Qwen 3.6 27B, em sua forma base, é apenas textual.
- MCP e perguntas sobre ferramentas: Um usuário relatou que, embora fique atrás do Qwen para programação no terminal, o Glimmer mostra potencial em busca de codebases assistida por MCP e fluxos de perguntas e respostas.
- Qualidade de escrita: Vários usuários preferiram a saída em linguagem natural do Glimmer à do Qwen.
Um comentário resumiu bem a troca: Glimmer é "Qwen 3.6 27B com mais 5% de estilo de escrita e menos 5% de capacidade agêntica".
Veredito
Se sua carga principal é programação one-shot ou agentes autônomos de terminal, o Qwen 3.6 27B continua sendo a opção mais forte: marcou 9 pontos a mais no TerminalBench 2.1 e não apresenta as recusas de segurança que prejudicam o Glimmer em automação no nível do sistema operacional. Se você precisa de recuperação em contexto longo, entrada multimodal ou fluxos assistidos por MCP em uma única GPU de consumo, vale testar o Muse Glimmer. Para automação de terminal confiável, espere por fine-tunes da comunidade.
Limitações e pontos de atenção
A armadilha do max_tokens
O Muse Glimmer consome uma parte significativa do orçamento de tokens em raciocínio interno antes de gerar a resposta. Se max_tokens estiver baixo demais, o modelo pode esgotar o limite no meio do raciocínio e devolver uma resposta vazia. Um usuário inicialmente deu nota 6/13 ao Glimmer em sua suíte de avaliação; ao elevar o orçamento de tokens de saída, a pontuação subiu para 11/13 (thread de origem). Configure max_tokens alto o suficiente para acomodar esse custo de raciocínio, ou a resposta pode ser interrompida no meio do pensamento.
Recusas em automação no nível do sistema operacional
Vários usuários relatam que o Muse Glimmer recusa tarefas que envolvem controle de mouse, automação de teclado ou outras chamadas de ferramentas no nível do sistema operacional. O modelo trata esses pedidos como possíveis riscos de segurança, mesmo quando envolvem o uso padrão de bibliotecas Python.
"Mover um mouse programaticamente pode ser usado indevidamente para automação, clickjacking ou para contornar prompts de segurança." - recusa do Muse Glimmer relatada pelo usuário do Reddit Cold_Tree190 (r/LocalLLaMA)
Iniciar uma nova sessão e fornecer mais contexto sobre o caso de uso pretendido às vezes resolve a recusa. Porém, quando o modelo já negou o pedido dentro de uma sessão, ele tende a manter a posição.
Tool calling inconsistente
Os relatos da comunidade sobre a confiabilidade de tool calling vão de "não falhou nenhuma vez" em uma codebase C a loops intermináveis e respostas vazias de API em outras configurações. Em alguns casos, as quantizações Unsloth Q4 e Q5 entraram em muitos loops durante tool calling, enquanto os GGUFs oficiais voltados a 24 GB e 32 GB de VRAM podem se comportar de forma mais confiável (thread de origem).
Restrições regionais de download
Segundo relatos, a página oficial no Hugging Face desativa downloads em Hong Kong, Macau e China. Distribuições GGUF de terceiros da Unsloth continuam disponíveis como alternativa.
Leitura relacionada: guia de preços da API Muse Spark 1.2 | melhores modelos gratuitos do OpenRouter para programação em 2026