 AIREITER
O repositório original facebookresearch/demucs está no modo somente leitura desde 1º de janeiro de 2025. Ainda assim, o Demucs continua sendo uma das melhores opções gratuitas de separação de stems para rodar na própria máquina — desde que você instale a versão pelo fork que lançou a v4.1.0 e aceite que guitarra e piano são os primeiros pontos em que o modelo começa a falhar.
Comece pelo repositório mantido do Demucs, não pelo arquivado
Existem dois repositórios no GitHub com o mesmo README, mas apenas um deles continua recebendo correções. O facebookresearch/demucs foi arquivado e está no modo somente leitura; o próprio README direciona os usuários para outro endereço. A casa mantida hoje é adefossez/demucs, onde o autor Alexandre Défossez explica que este é "o Demucs oficialmente mantido agora que deixei a Meta para entrar na Kyutai", com a ressalva de que é preciso "esperar respostas lentas e nenhum recurso novo por enquanto".
A diferença muda os comandos de instalação — não apenas a URL.
O que mudou na v4.1.0
A entrada das notas de lançamento datada de 11/07/2026 lista o Demucs v4.1.0 com "empacotamento modernizado, dependências de inferência mais leves, várias correções e modelos pré-treinados hospedados no Hugging Face". Na prática:
| Item | Repositório arquivado | Repositório mantido (v4.1.0) |
|---|---|---|
| Versão mínima do Python | 3.8 | 3.10 |
| Execução mais rápida | pip install -U demucs | uvx demucs MY_TRACK.mp3 (sem etapa de instalação) |
| Instalação permanente | pip install -U demucs | uv tool install demucs (pip continua funcionando) |
| ffmpeg | Obrigatório | Opcional; necessário para saída em FLAC e para formatos que o sphn não consegue decodificar |
| Modelos quantizados | Incluídos | Exigem o extra: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Hospedagem dos pesos | dl.fbaipublicfiles.com | Hugging Face |
Há uma armadilha importante antes de você abrir um chamado: o PyTorch abandonou o suporte a Macs Intel depois da versão 2.2, o que limita esses usuários ao Python 3.12. Por isso, a orientação é executar uvx --python 3.12 demucs.
Como escolher entre htdemucs, htdemucs_ft, htdemucs_6s e mdx
A flag -n define o modelo, e o padrão nem sempre é a melhor escolha. O Demucs oferece modelos de quatro fontes (bateria, baixo, outros e vocais), um experimento de seis fontes e os modelos mais antigos da competição MDX.
| Modelo | Fontes | Velocidade | Ressalva oficial | Use quando |
|---|---|---|---|---|
htdemucs | 4 | Base (padrão) | nenhuma mencionada | Primeira tentativa, processamento em lote ou qualquer situação em que o volume de trabalho pese |
htdemucs_ft | 4 | ~4× mais lento | "pode ser um pouco melhor" | Renderizações finais de uma faixa importante |
htdemucs_6s | 6 | Entre os dois | Guitarra "ok"; piano "não funciona muito bem", com "bastante vazamento e artefatos" | Quando você precisa especificamente de um stem de guitarra e consegue conviver com imperfeições |
hdemucs_mmi | 4 | Base | Arquitetura v3, retreinada | Fazer um A/B quando a v4 soar errada em uma mixagem específica |
mdx / mdx_extra | 4 | Base | mdx_extra foi treinado com dados que incluíam o conjunto de teste do MUSDB | Material mais antigo ou situações em que os artefatos da v4 incomodarem |
mdx_q / mdx_extra_q | 4 | Mais rápidos e menores | "a qualidade pode ser um pouco pior" | Máquinas com pouco armazenamento ou prévias rápidas |
Repare na cautela ao falar do htdemucs_ft: são quatro vezes mais processamento em troca de um ganho de qualidade que o próprio autor descreve apenas como possível. Em CPU, essa penalidade pesa muito — e os usuários fazem questão de deixar isso claro.
O que os números de 9.00 e 9.20 dB de SDR realmente medem
Os dois números aparecem no mesmo parágrafo do README, mas não são equivalentes. O Hybrid Transformer Demucs alcança 9.00 dB de SDR no conjunto de teste MUSDB HQ. O resultado superior de 9.20 dB exige kernels de atenção esparsa mais ajustes finos por fonte, e esse modelo esparso "não é disponibilizado porque exige código CUDA personalizado que ainda não está pronto para lançamento".
Ou seja: nenhum modelo que você possa baixar reproduz os 9.20 dB. Na própria tabela comparativa do README, a versão v4 ajustada e distribuída fica em 9.0 de SDR geral, empatada com a Band-Split RNN treinada em 1.7k mixagens.
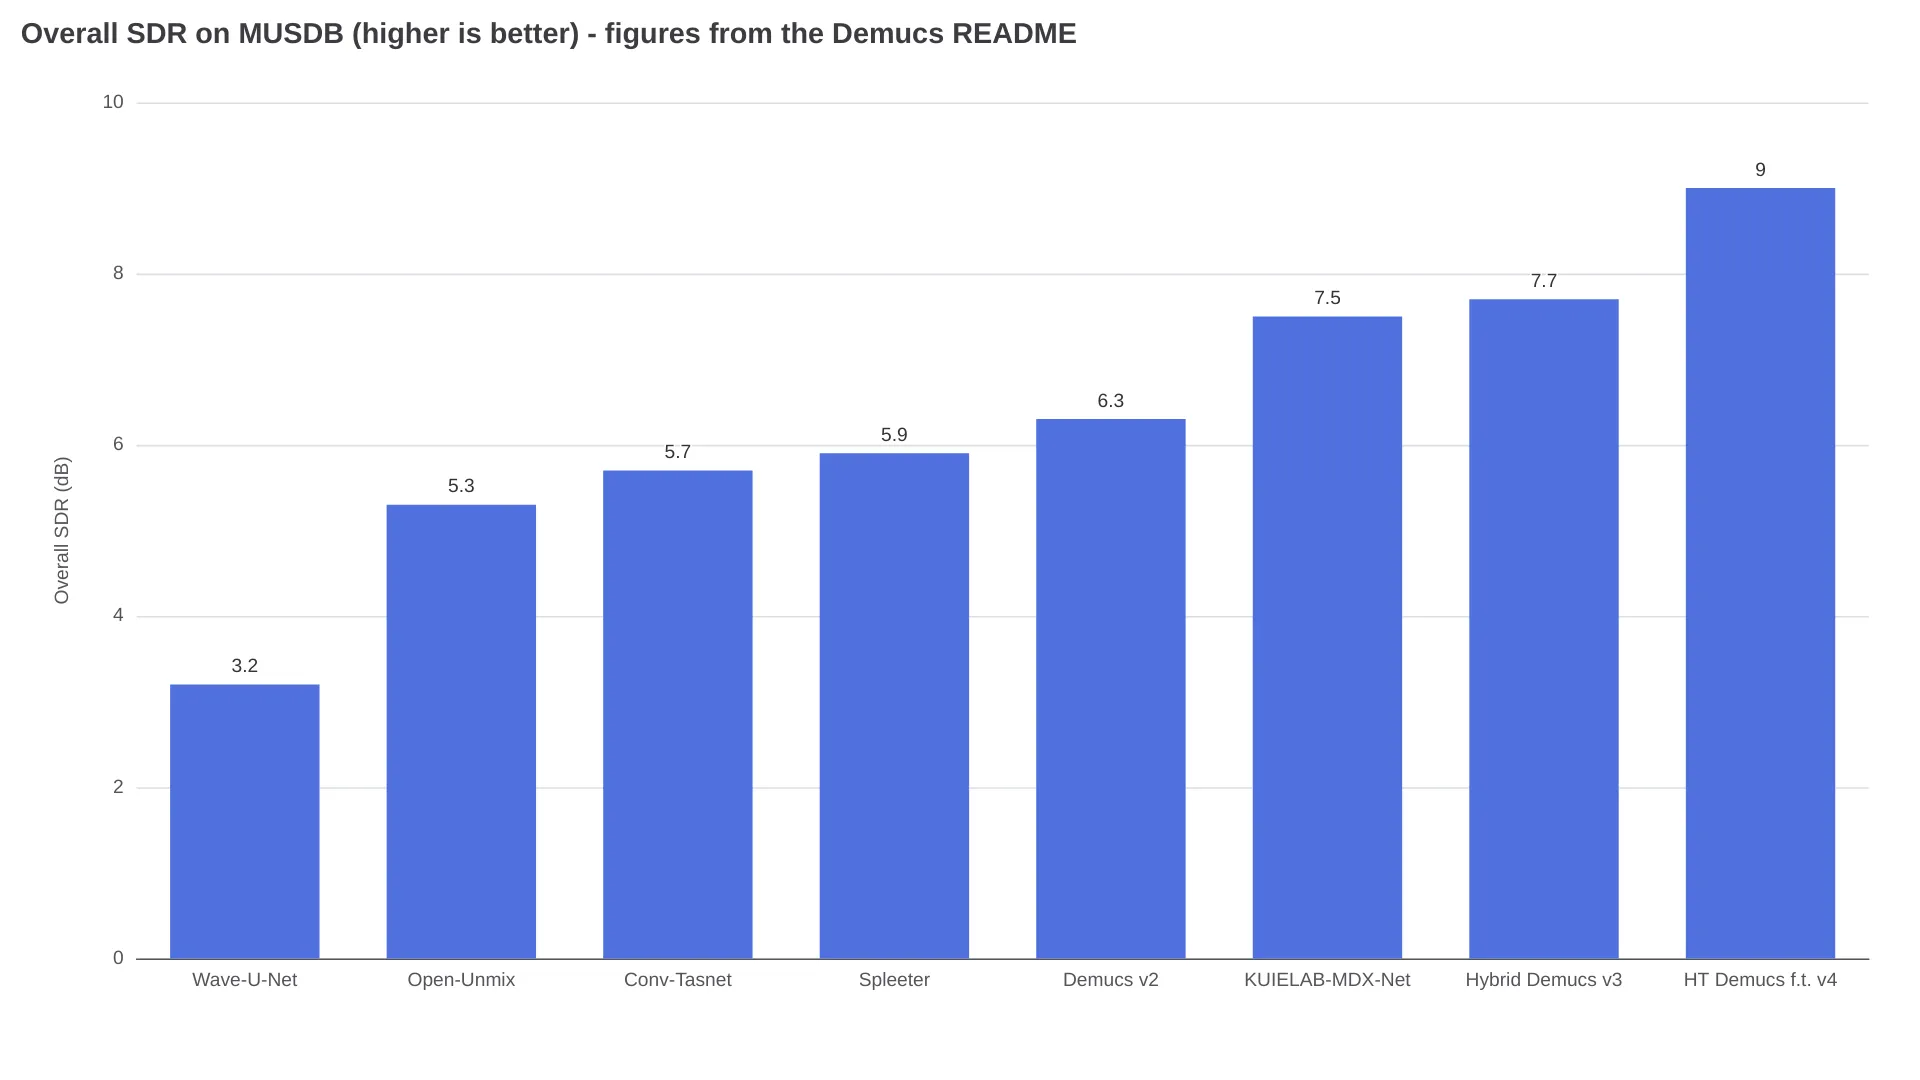
Na mesma tabela, o Spleeter aparece com 5.9 dB apesar de ter sido treinado em 25k músicas — uma diferença de aproximadamente 3 dB em relação à versão v4 ajustada.
As flags que mudam o resultado
Na maioria dos casos, executar o Demucs envolve três decisões: quantos stems gerar, quanto processamento investir e em qual formato salvar o resultado.
--two-stems=vocalsativa o modo karaokê e geravocals.waveno_vocals.wav. O programa separa a mixagem completa primeiro e faz a mixagem dos stems depois, portanto essa opção não é mais rápida nem consome menos memória que uma execução normal.--shifts=Ncalcula a média de N previsões usando entradas deslocadas aleatoriamente. Isso torna a predição N vezes mais lenta; a recomendação do README é "não usar a menos que você tenha uma GPU". O artigo usou 10 deslocamentos; o padrão hospedado do Replicate é 1.--overlapvem configurada em 0.25 por padrão e pode ser reduzida para 0.1 em troca de um pequeno ganho de velocidade.--segment Né o principal controle contra erros de falta de memória, mas há um detalhe que costuma passar despercebido em comandos copiados: os modelos Hybrid Transformer aceitam no máximo segmentos de 7.8 segundos. Portanto, valores longos de--segmentsó fazem diferença nos modelos que não são HT.- Flags de saída incluem
--mp3(320 kbps por padrão),--flac(exige ffmpeg),--int24e--float32. A saída padrão é um WAV int16 a 44.1 kHz, salvo emseparated/MODEL_NAME/TRACK_NAME. --clip-modeé mais importante do que parece: por padrão, o Demucs redimensiona os stems para evitar clipping, o que pode alterar o volume relativo entre eles. Jáclampaplica um limite rígido.
As expectativas de hardware na mesma documentação são estas: pelo menos 3 GB de RAM de GPU, cerca de 7 GB com os argumentos padrão e --segment 8 junto de PYTORCH_NO_CUDA_MEMORY_CACHING=1 para máquinas com 3 GB ou menos. Em CPU, o "tempo de processamento deve ser aproximadamente igual a 1.5 vezes a duração da faixa". É uma estimativa otimista quando comparada ao que usuários relatam com o htdemucs_ft.
Onde o Demucs deixa vazamentos — e o ajuste de duas passagens usado pelos usuários
O vazamento é uma das reclamações mais recorrentes, principalmente quando os vocais dividem a mesma região de frequência com um instrumento em destaque. Ryan Herr (@rrherr) resumiu bem o problema depois de tentar fazer uma extração:
o demucs deixou bastante saxofone vazar para a faixa de 'vocals'.
A solução adotada por usuários mais experientes não é uma flag, mas uma segunda etapa com outro modelo. O produtor japonês 夜凪P (@yonagip, 145 curtidas) descreve um fluxo em que primeiro usa o MelBand Roformer no UVR5 para separar vocais e instrumental; depois, envia apenas o instrumental ao htdemucs_ft para dividir bateria, baixo e outros:
Demucs単体だとVoが他に漏れるんだけど (com o Demucs sozinho, os vocais vazam para os outros stems)
Outros dois relatos apontam na mesma direção: um produtor mediu uma definição de baixo melhor com o htdemucs_ft, mas classificou o processamento em CPU como quatro vezes mais lento (@hachi_vm); outro publicou uma comparação de extração de guitarra em que o htdemucs-6s perde visivelmente para um modelo BS-RoFormer (@junon_12). São relatos anedóticos, não benchmarks, mas combinam com a posição oficial: quando Défossez anunciou o modelo de seis fontes em dezembro de 2022, escreveu que havia observado "algum vazamento + artefatos".
Regra prática: se a fonte tiver saxofone, guitarra solo ou piano fazendo linhas melódicas, considere uma única passagem do Demucs apenas um ponto de partida, não o arquivo final. Alternativas da classe Roformer podem ser acessadas pela interface do UVR5 quando você precisar dessa segunda passagem.
Usando o Demucs por API em vez de instalá-lo
Se você quer gerar stems sem configurar um ambiente Python, uma opção hospedada bastante usada é o cjwbw/demucs no Replicate: aproximadamente 1.5 milhão de execuções em hardware Nvidia T4, com estimativa da própria página de cerca de $0.020 por execução (~50 execuções por dólar) e previsões normalmente concluídas em até 90 segundos.
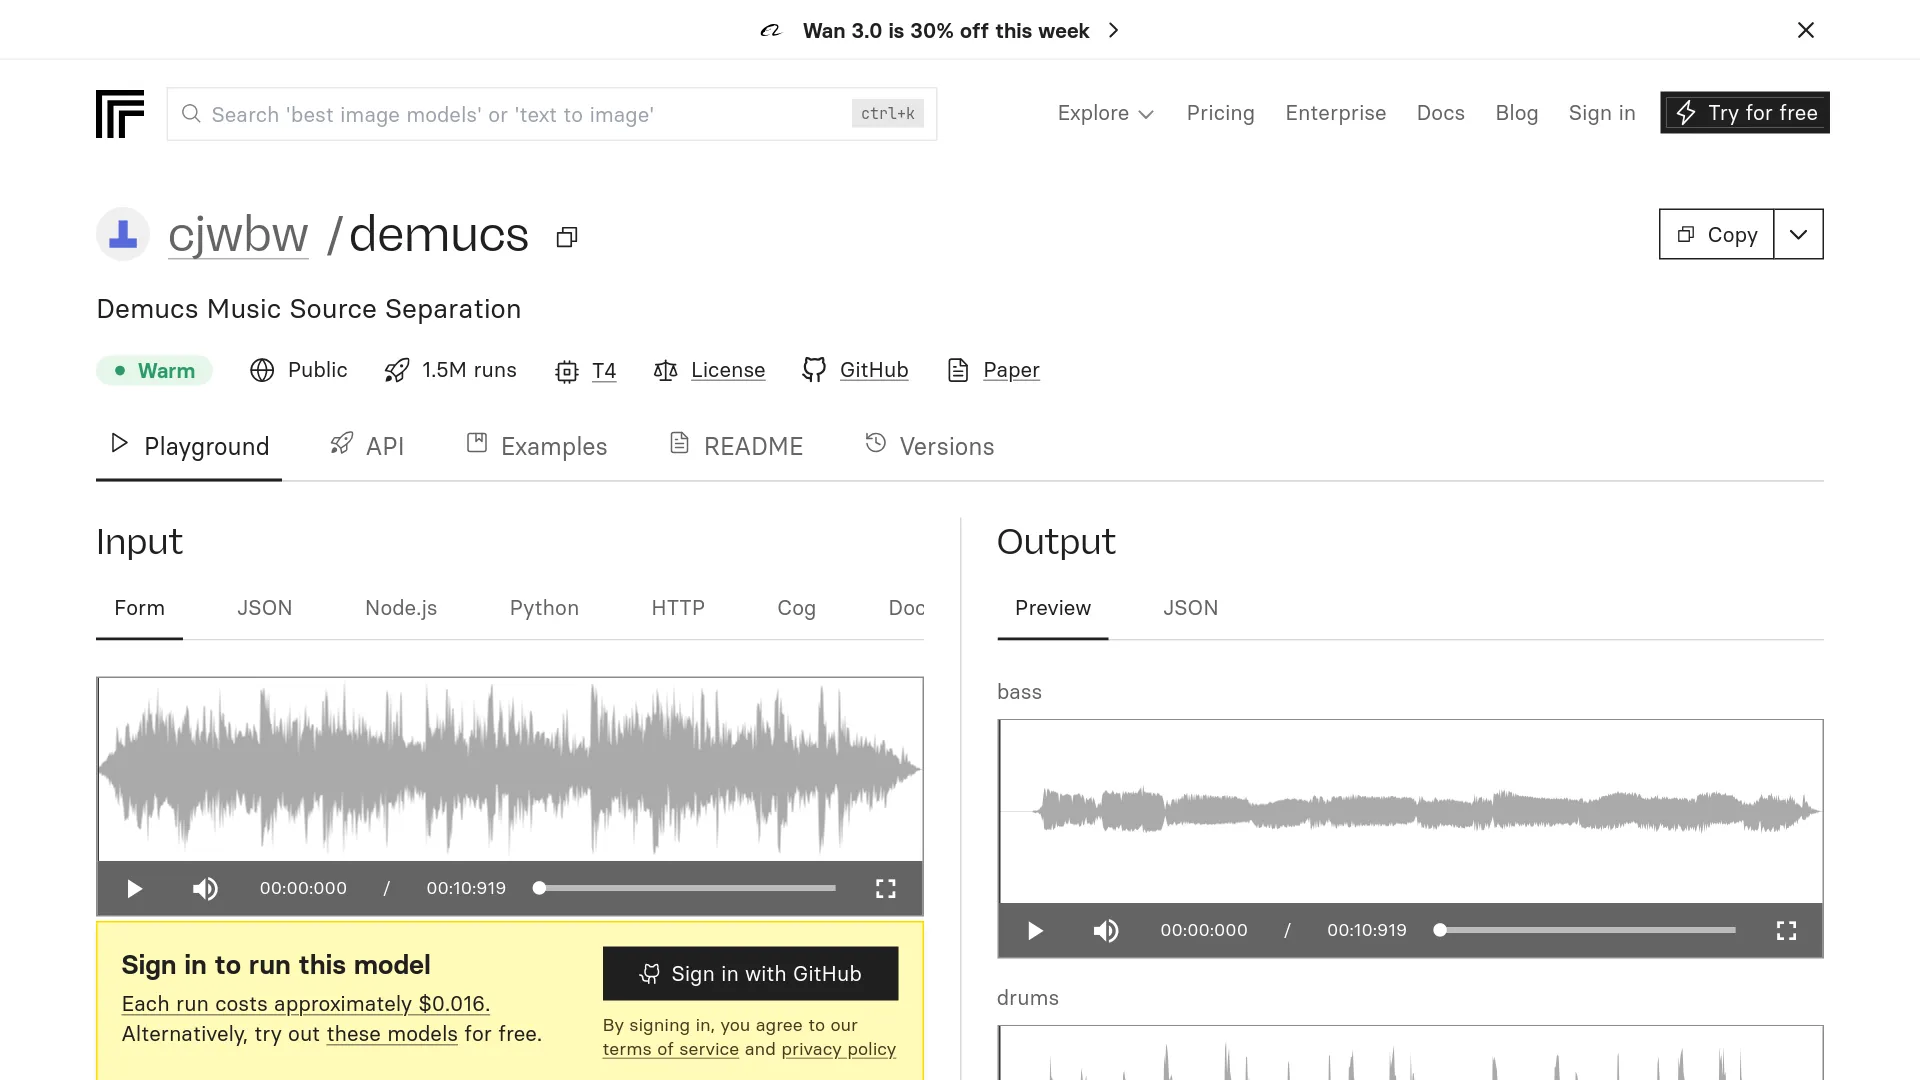
O esquema de entrada replica a CLI: model_name (padrão htdemucs), stem, shifts (padrão 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32, output_format (mp3).
Há uma ressalva que a página não destaca: a versão mais recente data de aproximadamente três anos atrás, e um endpoint hospedado fixa um snapshot. Na prática, você está chamando aquela build, não o trabalho de empacotamento e atualização de dependências da v4.1.0 de julho de 2026. O tempo de execução também varia mais do que o número principal sugere: um exemplo público de previsão no mesmo modelo levou 6 minutos e 18 segundos.
Quanto custa, de verdade, uma faixa de 4 minutos
O número que define o fluxo de trabalho é o custo por faixa — e ele depende de um detalhe de cobrança que muita gente só descobre depois de assinar.
A LALAL.AI calcula o uso como duração do arquivo × número de tipos de separação de stems selecionados. Portanto, separar uma música de 4 minutos em quatro stems consome 16 minutos, não 4.
A mesma página de preços lista recargas avulsas (verificadas em 25 de setembro de 2026): $50 por 750 minutos de Fast Queue, $190 por 3,000 e $300 por 5,000. Nesses valores, separar uma música de 4 minutos em 4 stems custa entre $0.96 e $1.07.
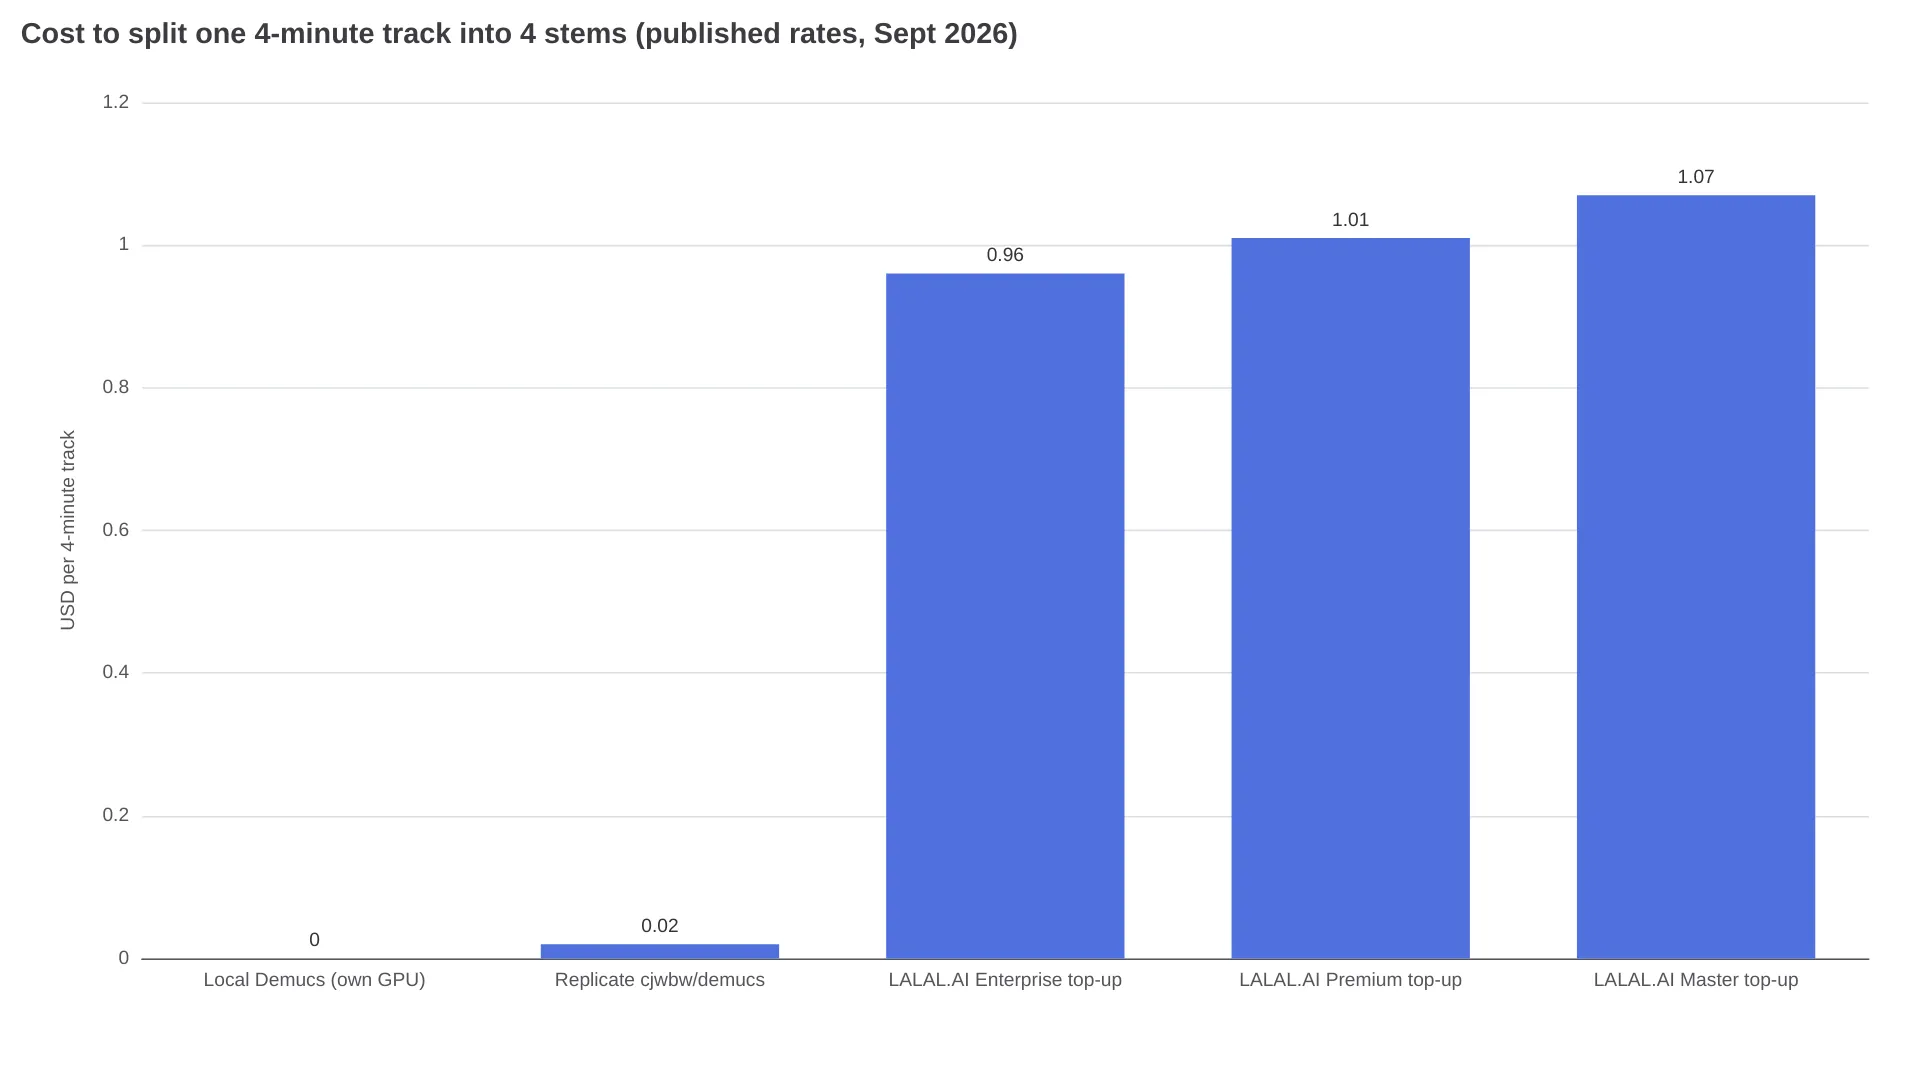
Há uma correção importante ao interpretar o gráfico: os valores da LALAL.AI representam o preço do processamento de prioridade. Os planos pagos incluem minutos ilimitados na Relaxed Queue, e a empresa afirma que as duas filas "entregam qualidade de separação idêntica". A Fast Queue compra apenas um tempo de espera menor.
| Plano | Preço | Inclui | Limitações importantes |
|---|---|---|---|
| LALAL.AI Starter | Grátis | 10 minutos na Relaxed Queue | Limite de upload de 200 MB |
| LALAL.AI Lite | €6.75/mês, €81 cobrados anualmente | Relaxed ilimitada, 90 minutos Fast | Sem processamento em lote, VST ou API; os minutos não acumulam |
| LALAL.AI Pro | €13.50/mês, €162 cobrados anualmente | Relaxed ilimitada, 250 minutos Fast | Único plano com acesso à API, plugin VST e processamento em lote |
| Moises | Não publicado publicamente | Plano gratuito com uploads mensais limitados | A tabela de preços fica atrás do login; afirma oferecer 27 tipos de stems |
Replicate cjwbw/demucs | ~$0.020/execução | T4, normalmente abaixo de 90 s | Versão fixada há ~3 anos |
| Demucs local | Grátis (licença MIT) | Ilimitado e offline | Seu tempo de GPU e o esforço de configuração |
Os 90 minutos de Fast Queue do plano Lite cobrem aproximadamente cinco faixas de 4 minutos separadas em 4 stems por mês, antes de você cair na fila relaxada. Se você processa mais de algumas músicas por semana, a conta deixa rapidamente de favorecer a cobrança por minuto — justamente o volume em que instalar o Demucs começa a compensar a tarde dedicada à configuração.
Qual caminho faz sentido para cada tarefa
| Seu cenário | Melhor caminho | Por quê |
|---|---|---|
| Separações ocasionais, sem GPU e sem terminal | LALAL.AI Starter, depois Lite | Os 10 minutos grátis permitem testar a qualidade antes de gastar |
| Aprender músicas e praticar priorizando o celular | Moises | 27 tipos de stems, além de ferramentas de tempo e acordes; confira o preço depois do login |
| Alto volume e GPU própria | uvx demucs com htdemucs | Custo marginal zero, execuções ilimitadas e nada sai da sua máquina |
| Uma renderização final importante | htdemucs_ft, --shifts 2 em GPU | Entrega aquele último ganho de qualidade ao custo de 4× mais processamento |
| Precisa de um stem de guitarra | htdemucs_6s primeiro; depois compare com um modelo da classe Roformer no UVR5 | A documentação oficial admite vazamentos no modelo de seis fontes |
| Material inédito ou protegido por NDA | Somente Demucs local | Não há upload, a licença é MIT e o processamento é offline |
| Backend de aplicativo sem orçamento para operações | Replicate cjwbw/demucs | ~$0.020/execução e nenhuma infraestrutura de GPU para administrar |
FAQ sobre separação de stems com Demucs
Qual modelo do Demucs oferece os melhores vocais?
O htdemucs_ft é o modelo distribuído de quatro fontes mais forte para vocais, com aproximadamente quatro vezes o tempo de processamento do htdemucs. Em mixagens difíceis, usuários relatam resultados melhores com um fluxo de duas passagens: primeiro uma separação vocal feita por um modelo da classe Roformer; depois, o Demucs para dividir o instrumental.
O Demucs consegue separar guitarra e piano?
Apenas por meio do htdemucs_6s. O README oficial classifica a qualidade da guitarra como "ok" em testes rápidos e afirma que a fonte de piano "não funciona muito bem", com "bastante vazamento e artefatos".
Preciso de uma GPU NVIDIA para rodar o Demucs?
Não. É possível usar CPU com -d cpu, e a documentação estima o processamento em aproximadamente 1.5× a duração da faixa. Usuários de Apple Silicon podem passar -d mps. A aceleração por GPU exige pelo menos 3 GB de VRAM, ou cerca de 7 GB com os argumentos padrão.
Por que os stems separados não se recombinam na mixagem original?
O Demucs redimensiona cada stem para evitar clipping causado por artefatos da separação, o que pode alterar os volumes relativos entre eles. Use --clip-mode clamp para aplicar clipping rígido ou reduza o volume da mixagem de entrada antes do processamento.
Onde o Demucs salva os stems?
Em separated/MODEL_NAME/TRACK_NAME/, como arquivos WAV estéreo a 44.1 kHz codificados em int16: drums.wav, bass.wav, other.wav e vocals.wav, a menos que você solicite saída em MP3, FLAC, int24 ou float32.
Como corrigir um erro de falta de memória da CUDA?
Reduza --segment (8 é o limite documentado para placas de 3 GB), defina PYTORCH_NO_CUDA_MEMORY_CACHING=1 ou recorra a -d cpu. Lembre-se de que os modelos Hybrid Transformer limitam o tamanho do segmento a 7.8 segundos; aumentar esse valor acima do limite não produz efeito neles.