 AIREITER
Claude Sonnet 5 para preservar tom e voz de marca, DeepSeek V4 Flash para grandes volumes por cerca de US$ 0,10 a cada 1.000 tarefas, e GPT-5.6 Terra como o modelo mais rápido e equilibrado no geral. Esse é o nosso veredito após testar seis modelos em 17 de julho de 2026.
Enviamos os mesmos três prompts de tradução para a API de cada modelo e comparamos as respostas brutas. A maior surpresa não foi a qualidade. Os seis traduziram corretamente o texto técnico para alemão, e cinco dos seis acertaram um diálogo em japonês com sujeitos omitidos sem cometer um único erro. O choque veio na conta: dois modelos aparentemente baratos consumiram tantos tokens de raciocínio por solicitação que ficaram entre 8 e 10 vezes mais caros por tradução do que o Claude — chegando perto das tarifas por caractere do DeepL.
Para escolher o melhor LLM de tradução em 2026, a questão deixou de ser qual modelo consegue traduzir — todos conseguem. O que importa é encontrar o que combina com seu tipo de conteúdo e seu volume, sem custos escondidos na fatura.
Qual modelo escolher para cada tipo de tradução
| Seu volume de trabalho | Escolha | Motivo | Custo medido por 1.000 tarefas |
|---|---|---|---|
| Textos de marketing e voz de marca | Claude Sonnet 5 | Parece escrito originalmente no idioma de destino, e não traduzido para ele | ~US$ 1,06 |
| Alto volume: catálogos de produtos, documentação e legendas | DeepSeek V4 Flash | Acertou os três testes e foi, de longe, o mais barato | ~US$ 0,10 |
| Cargas mistas e menor latência | GPT-5.6 Terra | Respostas em 3,0–4,3 s e formatação mais limpa | ~US$ 0,88 |
| Controle de glossário e fluxos com ferramentas CAT | DeepL | Oferece bases terminológicas e integrações que APIs de LLM ainda não trazem | US$ 27,50 por 1M de caracteres |
Os custos são médias das três tarefas testadas — tokens de saída × preços oficiais de julho de 2026 — projetadas para 1.000 traduções curtas. A tabela completa de medições está mais abaixo. Há uma categoria fora deste teste: para conversas por voz em tempo real, o Google vende uma variante dedicada Gemini 3.5 Live Translate por US$ 3,50/US$ 21 por milhão de tokens. Nós a citamos, mas não a testamos.
Como fizemos os testes
Foram três prompts, seis modelos, o mesmo texto e uma execução para cada um em 17 de julho de 2026: inglês→japonês para marketing, avaliando tom; inglês→alemão para documentação de API, avaliando terminologia; e japonês→inglês em diálogo casual, avaliando sujeitos omitidos e contexto — a falha clássica em pares CJK. CJK é a sigla para chinês, japonês e coreano, três idiomas nos quais se concentram as reclamações sobre qualidade de tradução automática.
Os modelos foram GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 e Kimi K2.6. Todas as chamadas passaram pela mesma conta de gateway, com configurações padrão. Por isso, os números de latência são comparáveis entre si, embora variem conforme sua região e a carga do provedor.
A seguir, os três textos de origem na íntegra, para que você possa repetir o teste:
EN→JA (marketing): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (técnico): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (diálogo): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Todas as medições por modelo e tarefa — latência em segundos de relógio / tokens de saída informados no objeto de uso:
| Modelo | EN→JA | EN→DE | JA→EN | Custo médio por tarefa |
|---|---|---|---|---|
| GPT-5.6 Terra | 3,0s / 46 | 4,3s / 67 | 3,2s / 63 | US$ 0,00088 |
| Claude Sonnet 5 | 3,5s / 60 | 4,0s / 146 | 3,5s / 111 | US$ 0,00106 |
| DeepSeek V4 Flash | 5,2s / 421 | 4,3s / 371 | 4,7s / 323 | US$ 0,00010 |
| DeepSeek V4 Pro | 16,5s / 769 | 18,0s / 989 | 19,6s / 946 | US$ 0,00078 |
| GLM-5.2 | 30,8s / 1.906 | 29,0s / 1.590 | 35,2s / 1.985 | US$ 0,00804 |
| Kimi K2.6 | 19,6s / 2.849 | 48,5s / 2.235 | 23,6s / 2.413 | US$ 0,01000 |
Custo por tarefa = tokens de saída × preço oficial de saída do provedor. A entrada fica entre 60 e 110 tokens por tarefa e acrescenta menos de US$ 0,0003 mesmo nas tarifas do GPT-5.6 Terra; o gráfico por milhão de caracteres mais abaixo inclui esse valor. Todos os preços são as tarifas oficiais de tabela em 17 de julho de 2026, não os preços com desconto cobrados da nossa conta.
Uma checagem pontual de três tarefas não permite ranquear modelos em 100 pares de idiomas, e não afirmamos que permite. Mas ela pode revelar diferenças que aparecem mesmo em uma amostra pequena. Neste caso, elas foram grandes.
Teste 1: marketing de inglês para japonês
O prompt pedia uma versão natural e polida em japonês para esta frase de landing page SaaS: "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
O Claude Sonnet 5 escreveu:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
É o registro que um redator japonês usaria: o カタチ estilizado — katakana para “forma” — e o ritmo separado por vírgulas são convenções de landing pages, não gramática de livro didático. GPT-5.6 Terra e DeepSeek V4 Pro vieram logo atrás, com versões claras e profissionais, como 「アイデアを、より迅速に形に。」.
O DeepSeek V4 Flash foi o mais literal dos seis: 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」. A gramática está correta, mas a leitura entrega que se trata de uma tradução. Em uma página de produto, seria melhor fazer uma revisão humana. Para artigos de suporte ou documentos internos, funciona perfeitamente.
A diferença existe, mas é pequena: os seis modelos entregaram japonês utilizável. Em trabalho de voz de marca, o custo extra de cerca de US$ 1 por 1.000 tarefas do Claude se paga. Em nenhum outro teste a diferença teve tanto peso.
Teste 2: documentação técnica de inglês para alemão
Traduzimos duas frases de documentação de API sobre limites de taxa, HTTP 429, exponential backoff e chaves de idempotência. Todos os seis modelos acertaram os termos técnicos e usaram as convenções naturais de documentação em alemão: Ratenlimit, Statuscode 429, exponentielles Backoff e Idempotenzschlüssel.
A única diferença visível foi que o GPT-5.6 Terra colocou Retry-After em formatação de código, como se vê em documentação real de APIs em alemão ao citar nomes de cabeçalhos. É um detalhe bem-vindo, não uma diferença de qualidade.
Em prosa padrão de documentação entre idiomas europeus com bons recursos, nenhum modelo da amostra cometeu erro. Nesta geração, as diferenças de qualidade foram pequenas demais para serem observadas. Se essa é toda a sua demanda, decida por preço e velocidade, não por qualidade. Isso faz do DeepSeek V4 Flash a escolha padrão, a US$ 0,14 de entrada / US$ 0,28 de saída por milhão de tokens.
Teste 3: diálogo de japonês para inglês com sujeitos omitidos
O japonês omite o sujeito das frases com frequência, e quem traduz precisa deduzir quem faz o quê. Nosso diálogo também incluía 根回し (nemawashi), o processo de construir consenso discretamente antes de uma decisão formal — um conceito cultural sem equivalente direto em inglês.
Cinco dos seis modelos acertaram tudo. Os sujeitos foram atribuídos corretamente, e nemawashi apareceu como "lay the groundwork", "sound him out beforehand" ou "give him a heads-up", todas escolhas defensáveis. A versão do Claude soou mais como diálogo nativo: "he's probably gonna chew me out".
O único erro de fato entre as 18 respostas veio do DeepSeek V4 Pro. Ele traduziu 「先に根回ししといたほうがいい」 — um conselho sobre o que fazer em seguida — como "You should've laid the groundwork first", um arrependimento no passado sobre algo cuja oportunidade já passou. Poucas palavras, sentido oposto. Se um colega dissesse uma coisa e você entendesse a outra, sua ação seria diferente.
Um erro de tempo verbal em uma única execução é um dado, não um veredito sobre o modelo — comparamos as duas versões do DeepSeek com mais profundidade em nossa comparação entre DeepSeek V4 Flash e Pro. Ainda assim, é um lembrete útil de que fluência e fidelidade são propriedades diferentes: a frase pode soar perfeita e transmitir o sentido errado. Para contratos, conteúdo médico ou qualquer contexto em que interpretar mal um tempo verbal custe dinheiro, reserve revisão humana independentemente do modelo escolhido.
A armadilha do consumo de tokens: por que a tabela de preços engana
Este é o achado que muda a decisão de compra. Por milhão de tokens de saída, o GLM-5.2 custa US$ 4,40 e o Kimi K2.6 custa US$ 4,00 — menos da metade dos US$ 10 do Claude Sonnet 5. Só que, por tradução efetivamente realizada, eles foram entre 8 e 10 vezes mais caros.
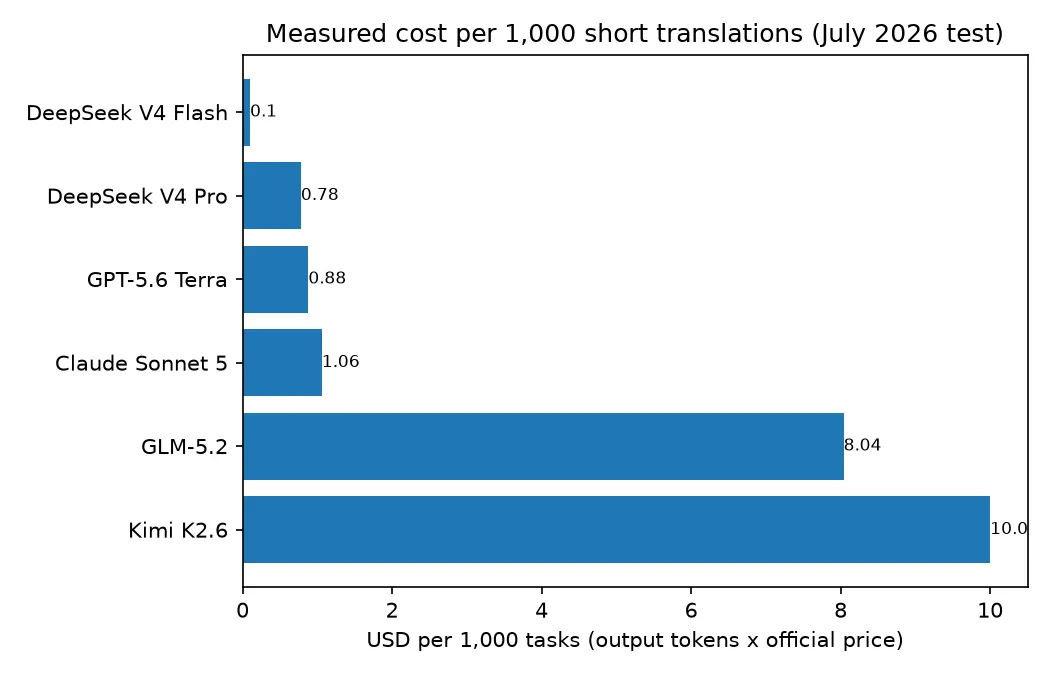
O motivo é que os dois modelos executam uma cadeia de raciocínio visível antes de responder, e tokens de raciocínio são cobrados como saída. Para traduzir uma frase de marketing, o Kimi K2.6 gerou 2.849 tokens de saída e o GLM-5.2, 1.906, para traduções de 40–60 tokens. O Claude Sonnet 5 usou 60 tokens na mesma tarefa; o GPT-5.6 Terra, 46.
A latência seguiu o mesmo padrão. GPT-5.6 Terra e Claude Sonnet 5 responderam em 3–4 segundos nas três tarefas. O DeepSeek V4 Flash levou 4–5s, o DeepSeek V4 Pro ficou entre 16–20s, e GLM-5.2 e Kimi K2.6 variaram de 20 a 48 segundos por solicitação.
Daí saem duas regras práticas. Primeiro: em tarefas curtas e de alto volume, como tradução, compare os modelos pelo custo medido por tarefa, não pelo preço de tabela. Rode 20 solicitações e confira o campo de uso. Segundo: desligue ou reduza o raciocínio para tradução. O DeepSeek separa endpoints com e sem thinking, enquanto GLM e Kimi expõem parâmetros de thinking no corpo da solicitação. Nas três tarefas, a cadeia de raciocínio não trouxe nenhum ganho detectável de qualidade na saída.
Quanto custa traduzir em escala
Ao projetar o consumo medido de tokens para um milhão de caracteres de texto de origem em inglês — aproximadamente 250.000 tokens — a diferença se torna dramática:
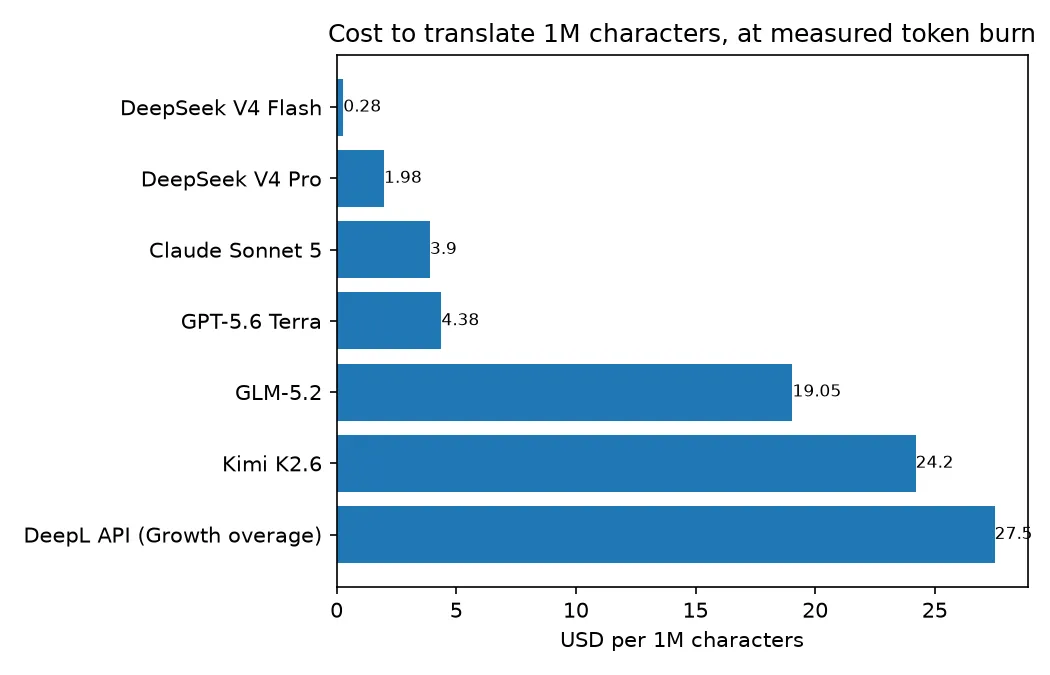
O DeepSeek V4 Flash traduz o equivalente a um romance inteiro por cerca de US$ 0,28. O mesmo volume pela API do DeepL custa US$ 27,50 nas tarifas de excedente do plano Growth — uma diferença de 98x. Isso está na mesma direção de uma análise amplamente compartilhada no r/LocalLLaMA, intitulada "LLMs are 800x cheaper for translation than DeepL", cujo multiplicador maior vinha de modelos menores hospedados localmente.
Observe o topo do gráfico: com o consumo de tokens medido, os modelos de pesos abertos que usam bastante raciocínio quase eliminam a diferença em relação ao DeepL. Preço unitário sem medir tokens não é estimativa de custo.
Três pontos sobre preço que vale saber antes de se comprometer, todos verificados em 17 de julho de 2026:
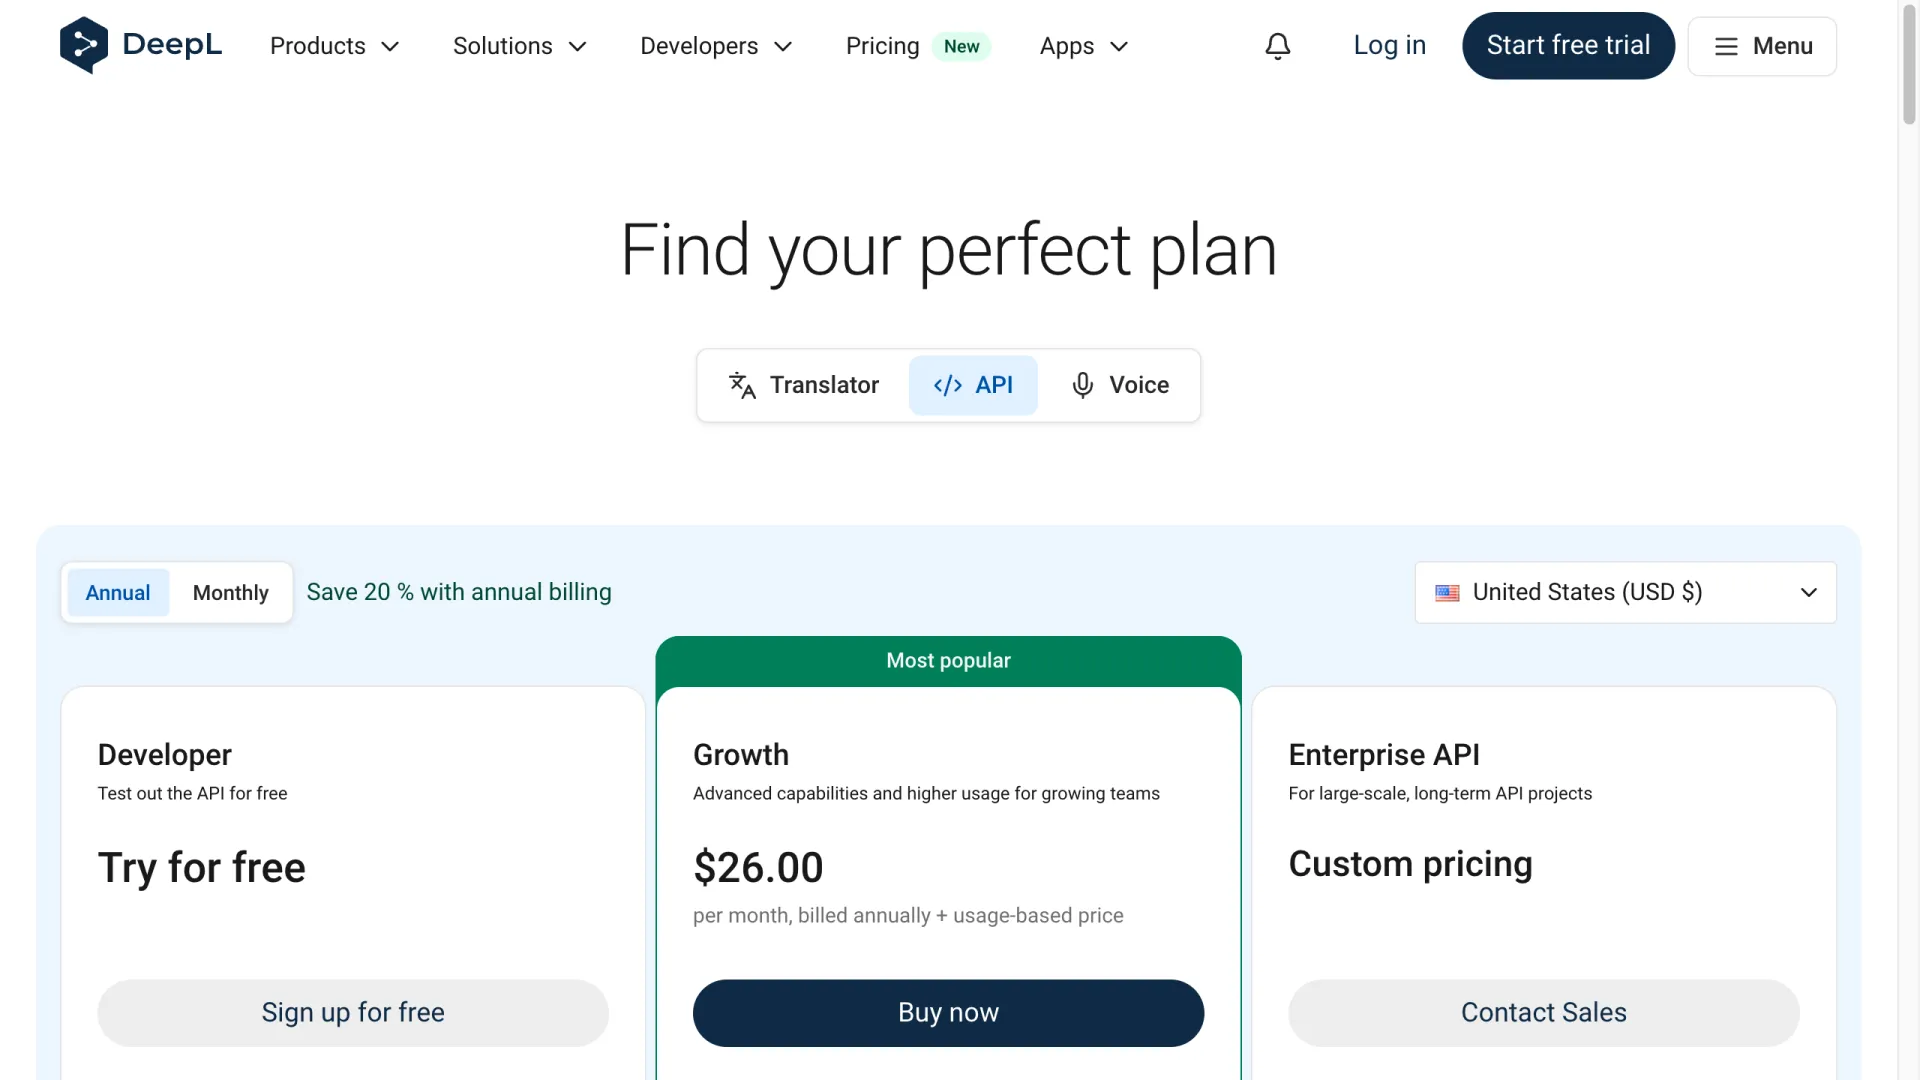
- O plano gratuito do DeepL mudou. O plano API Developer agora oferece um crédito único de 1.000.000 de caracteres, não a franquia mensal de 500.000 caracteres que ainda aparece em documentações antigas e respostas de fóruns. O Growth custa US$ 26/mês, cobrados anualmente, com 12M de caracteres/ano incluídos; depois disso, são US$ 27,50 por milhão extra.
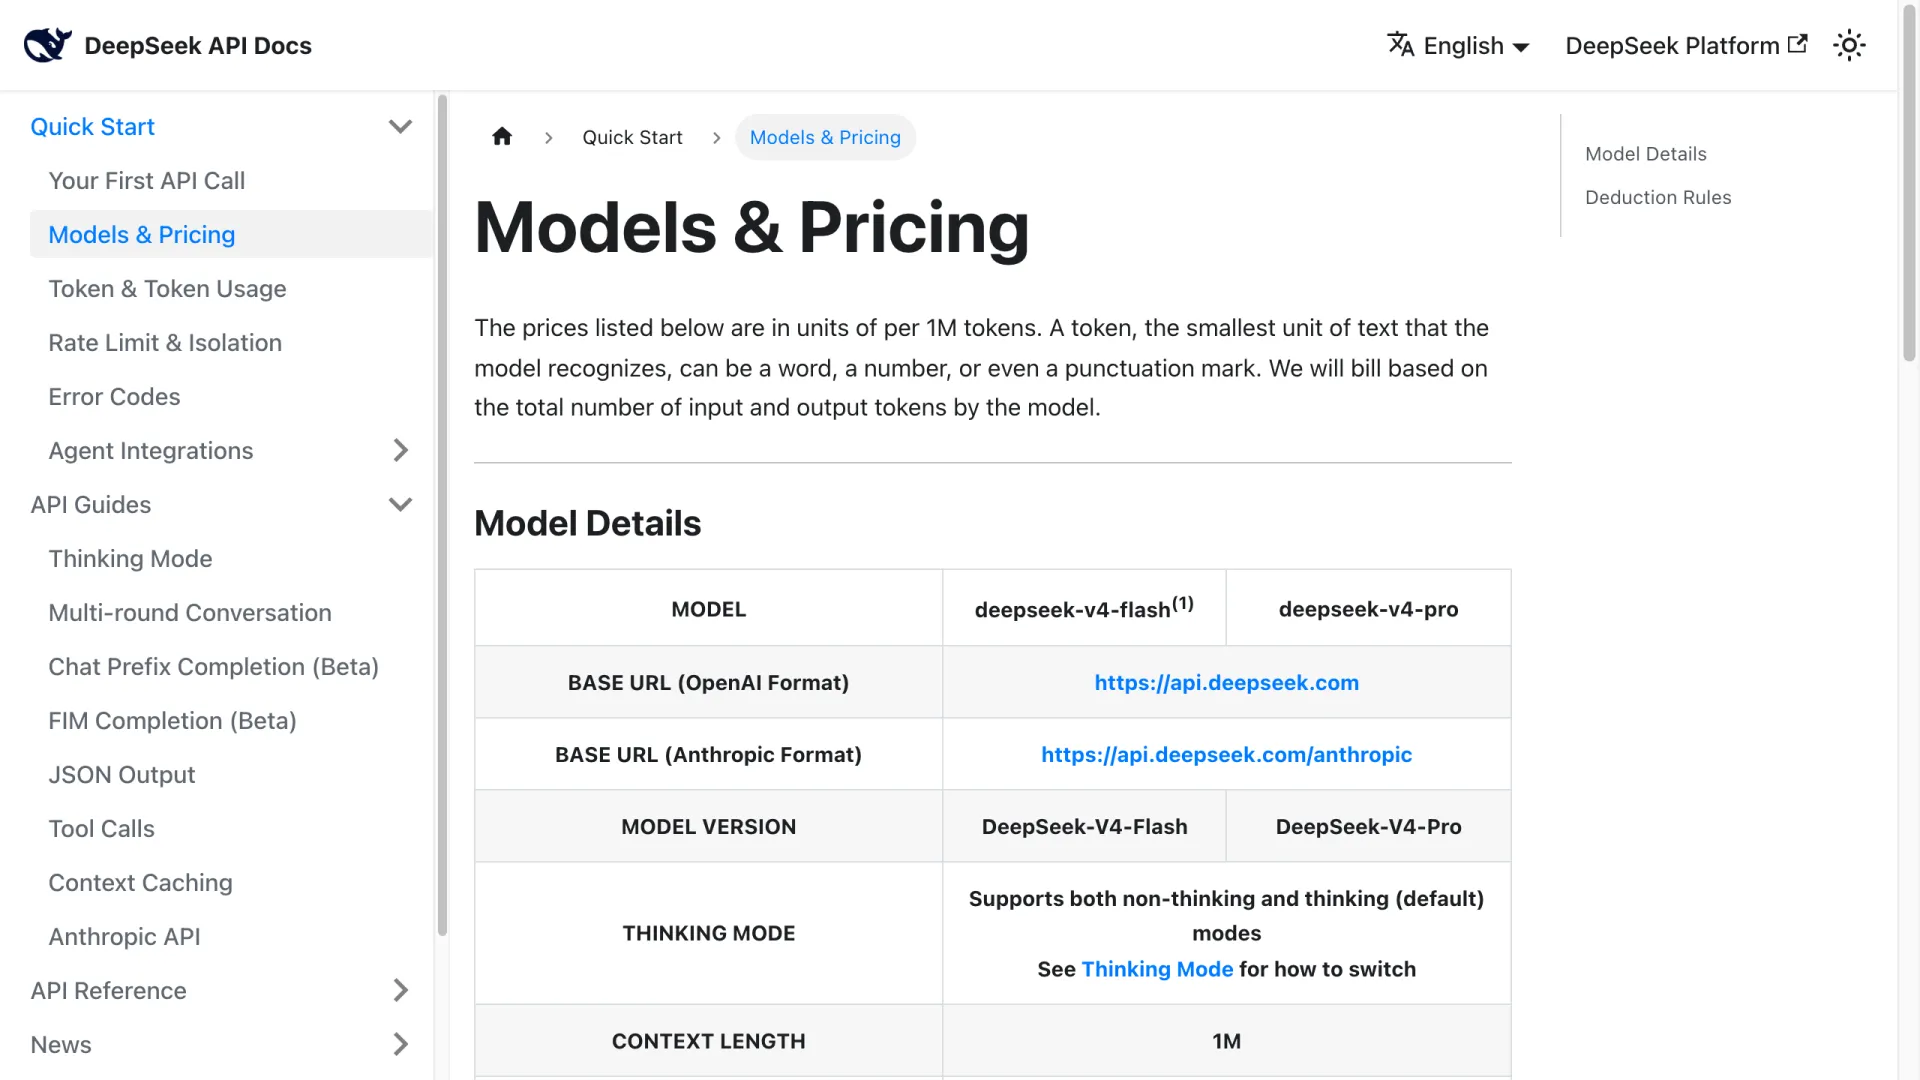
- O DeepSeek cobra uma fração do preço dos demais. São US$ 0,14 de entrada / US$ 0,28 de saída por milhão de tokens no V4 Flash, e a entrada com cache hit cai para US$ 0,0028. O antigo nome de modelo deepseek-chat será descontinuado em 24 de julho de 2026.
- Claude Sonnet 5 está com preço introdutório. US$ 2/US$ 10 por milhão de tokens até 31 de agosto de 2026; depois, US$ 3/US$ 15. Seu tokenizer mais novo também gera cerca de 30% mais tokens para o mesmo texto, algo já incluído em nossos cálculos de custo. Se o planejamento vai além de setembro, considere os dois fatores.
- APIs batch cortam a conta pela metade. OpenAI, Anthropic e Google oferecem descontos de aproximadamente 50% para processamento batch assíncrono. Tradução normalmente não exige baixa latência, então é economia sem contrapartida: o preço batch leva o GPT-5.6 Terra a ~US$ 2,19 e o Claude Sonnet 5 a ~US$ 1,95 por milhão de caracteres.
Quando DeepL ou Google Translate ainda são melhores opções
Na conta por caractere, os LLMs levam vantagem. Mas três exigências ainda apontam para o outro lado:
- Terminologia obrigatória. O DeepL oferece glossários e bases terminológicas que garantem a mesma tradução para um termo em todas as ocorrências. Com um LLM, você orienta por prompt e verifica o resultado; é probabilístico, não imposto.
- Integração com ferramentas CAT e pipelines. Se sua memória de tradução está em uma ferramenta CAT, de tradução assistida por computador, os conectores do DeepL se integram diretamente.
- Latência abaixo de um segundo em escala. Motores tradicionais de tradução automática neural normalmente respondem mais rápido do que LLMs de uso geral. Para tradução embutida na interface, isso importa.
Para voz ao vivo, nem a NMT clássica nem um LLM de chat têm o formato ideal. O Google cobra por uma variante dedicada do Gemini 3.5 Live Translate US$ 3,50/US$ 21 por milhão de tokens, além de tarifas de áudio por minuto, tema que detalhamos em nossa análise do Gemini 3.5 Live Translate.
Para idiomas raros e de poucos recursos, cobertura vem antes de rankings de qualidade: confirme se o par de idiomas tem suporte antes de comparar qualquer outra coisa. O DeepL suporta cerca de 30 idiomas; LLMs grandes lidam com mais de uma centena, com qualidade que cai nos idiomas menos atendidos.
Alternativas open source e locais
Tanto o GLM-5.2 quanto a série K do Kimi publicam pesos abertos. Portanto, o problema de consumo de tokens acima pode ser resolvido com hospedagem própria: você controla os parâmetros de amostragem e pode eliminar completamente as cadeias de raciocínio.
Para tradução local em uma única GPU, o Qwen3-30B-A3B é a recomendação recorrente nas discussões do r/LocalLLaMA sobre modelos locais de tradução para pares de idiomas europeus rumo ao inglês. À medida que o par fica mais incomum, a recomendação é subir para modelos maiores. A motivação costuma ser privacidade — contratos e produtos ainda não lançados — ou custo marginal zero, não qualidade. Nas mesmas discussões, modelos de ponta hospedados continuam sendo descritos como tradutores melhores.
Vale acompanhar: o Kimi K3 foi lançado esta semana com pesos abertos, por US$ 3/US$ 15 por milhão de tokens na versão hospedada. Testamos o K2.6 porque o acesso à API do K3 ainda estava sendo liberado; se o K3 herdar o apetite por tokens da série K, a mesma ressalva sobre custo medido continuará valendo.
Como reproduzir esta comparação
Você consegue reproduzir tudo o que está acima com cerca de 20 chamadas de API: selecione duas frases do seu próprio conteúdo, envie-as a cada modelo candidato e confira o objeto de uso de cada resposta para obter as contagens reais de tokens. O custo total da nossa rodada de 18 solicitações ficou abaixo de US$ 0,15.
A parte chata é manter seis chaves de API de cinco provedores. Nós executamos os seis modelos por uma única conta AIReiter, que revende acesso à API dos principais modelos — com chaves da família Claude por aproximadamente um quinto do preço de tabela — por trás de um único endpoint compatível com Anthropic. É uma chave e o mesmo formato de integração para todos os modelos acima.
Se seu volume de tradução é relevante, uma hora de checagens pontuais com seu próprio conteúdo vale mais do que qualquer ranking, inclusive este. Os modelos são próximos o bastante em qualidade para que seu par de idiomas, suas exigências de tom e suas medições de tokens decidam a escolha.
Perguntas frequentes
ChatGPT ou Gemini: qual traduz melhor?
Nos nossos testes, o GPT-5.6 Terra foi rápido, preciso e manteve a formatação limpa nas três tarefas. Não testamos o Gemini lado a lado, pois ele não estava disponível no nosso gateway, mas seu preço publicado é competitivo — US$ 1,50/US$ 9 por milhão de tokens para o 3.5 Flash — e ele é o único provedor com um modelo dedicado à tradução de voz ao vivo.
Qual é o tradutor de IA mais preciso neste momento?
Em pares de idiomas com muitos recursos, as diferenças de precisão entre modelos de ponta são pequenas. Os seis modelos testados traduziram o texto técnico para alemão sem erros. As diferenças se concentram no tom — o Claude liderou no texto de marketing para japonês — e em casos-limite como sujeitos omitidos e tempos verbais, em que o DeepSeek V4 Pro cometeu o único erro relevante da amostra.
Qual é o melhor LLM open source para tradução?
GLM-5.2 e Kimi K2.6 publicam pesos e traduziram corretamente em nossos testes; com hospedagem própria, é possível desativar as cadeias de raciocínio que tornam suas APIs hospedadas caras por tarefa. Para hardware de consumidor, o Qwen3-30B-A3B é a recomendação mais comum da comunidade.
Um LLM pode substituir um tradutor humano?
Para documentos internos, conteúdo de suporte e texto em massa de produtos: em grande parte, sim, por 1–16% do custo por caractere do DeepL, dependendo do modelo — DeepSeek V4 Flash ~1%, Claude Sonnet 5 ~14% e GPT-5.6 Terra ~16%. Para contratos, textos médicos e campanhas de marca, o erro de tempo verbal do Teste 3 serve de alerta. Uma saída fluente ainda pode inverter o sentido; mantenha a revisão humana onde uma interpretação errada é cara.
O DeepL ainda vale a pena em 2026?
Sim, em três situações: glossários obrigatórios, integração com ferramentas CAT e latência abaixo de um segundo. Fora disso, a conta por caractere é difícil de justificar. E atenção: a faixa gratuita agora é um crédito único de 1M de caracteres, não mensal.