 AIREITER
Per curare tono e voce del brand scegliamo Claude Sonnet 5; per i grandi volumi, DeepSeek V4 Flash, che arriva a circa $0.10 ogni 1.000 attività; per un modello rapido e versatile, GPT-5.6 Terra. È il nostro verdetto dopo aver testato sei modelli il 17 luglio 2026.
Abbiamo inviato gli stessi tre prompt di traduzione alle API di ciascun modello e confrontato gli output senza filtri. La qualità non è stata la sorpresa: tutti e sei hanno tradotto correttamente il tedesco tecnico, e cinque su sei hanno gestito un dialogo giapponese con soggetti sottintesi senza un singolo errore. La vera sorpresa è arrivata dai costi. Due modelli apparentemente economici hanno consumato così tanti token di ragionamento per richiesta da risultare 8–10 volte più costosi di Claude per singola traduzione, avvicinandosi alle tariffe per carattere di DeepL.
Nel 2026, scegliere il miglior LLM per tradurre non significa più capire quale modello sia in grado di farlo: lo fanno tutti. Conta piuttosto individuare quello più adatto al tipo e al volume dei contenuti, senza ritrovarsi costi nascosti in fattura.
Quale modello scegliere in base al lavoro
| Tipo di lavoro | Scelta consigliata | Motivo | Costo misurato ogni 1.000 attività |
|---|---|---|---|
| Copy marketing e voce del brand | Claude Sonnet 5 | Sembra scritto direttamente nella lingua di arrivo, non tradotto | ~$1.06 |
| Grandi volumi: feed prodotto, documenti, sottotitoli | DeepSeek V4 Flash | Corretto in tutti e tre i test, di gran lunga il più economico | ~$0.10 |
| Carichi misti e latenza minima | GPT-5.6 Terra | Risposte in 3.0–4.3s, formattazione più pulita | ~$0.88 |
| Glossari obbligatori e flussi CAT tool | DeepL | Termbase e integrazioni che le API LLM non offrono | $27.50 per 1M di caratteri |
I costi sono medie dei tre test svolti, calcolate sui token di output alle tariffe ufficiali di luglio 2026 e proiettate su 1.000 traduzioni brevi; la tabella completa delle misurazioni è più avanti. Una categoria resta fuori dal test: per le conversazioni vocali in diretta, Google vende una variante Gemini 3.5 Live Translate progettata appositamente, a $3.50/$21 per milione di token. La citiamo, ma non l'abbiamo provata.
Metodo di prova
Tre prompt, sei modelli, formulazione identica e una sola esecuzione per modello il 17 luglio 2026: testo marketing dall'inglese al giapponese per valutare il tono; documentazione API dall'inglese al tedesco per verificare la terminologia; dialogo colloquiale dal giapponese all'inglese per mettere alla prova soggetti impliciti e contesto, il classico punto debole delle coppie CJK. CJK è l'abbreviazione di cinese, giapponese e coreano, le tre lingue per cui si concentrano spesso le lamentele sulla qualità della traduzione automatica.
I modelli testati sono GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 e Kimi K2.6. Tutte le chiamate sono passate dallo stesso account gateway con impostazioni predefinite: i tempi di latenza sono quindi confrontabili fra loro, ma possono cambiare in base alla regione e al carico del provider.
Ecco i tre testi sorgente, riportati integralmente per chi volesse ripetere il test:
EN→JA (marketing): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (tecnico): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (dialogo): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Tutte le rilevazioni, per modello e attività: latenza in secondi effettivi / token di output indicati nell'oggetto usage.
| Modello | EN→JA | EN→DE | JA→EN | Costo medio per attività |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
Costo per attività = token di output × prezzo ufficiale di output del provider. L'input pesa 60–110 token per attività e aggiunge meno di $0.0003 anche alle tariffe di GPT-5.6 Terra; il grafico più avanti, espresso per milione di caratteri, lo include. Tutti i prezzi sono prezzi di listino ufficiali al 17 luglio 2026, non le tariffe scontate fatturate al nostro account.
Un controllo a campione su tre attività non può classificare i modelli su 100 coppie linguistiche, e non sosteniamo di farlo. Può però far emergere differenze visibili anche con un campione limitato. In questo caso, le differenze sono state notevoli.
Test 1: copy marketing dall'inglese al giapponese
Il prompt chiedeva una resa giapponese naturale e cortese di una frase per landing page SaaS: "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
Claude Sonnet 5 ha prodotto questo copy:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
È il registro che userebbe un copywriter giapponese: il カタチ stilizzato, in katakana per “forma”, e il ritmo scandito dalla virgola sono convenzioni tipiche delle landing page, non grammatica da manuale. GPT-5.6 Terra e DeepSeek V4 Pro seguono a poca distanza, con versioni pulite e professionali come 「アイデアを、より迅速に形に。」.
DeepSeek V4 Flash è stato il più letterale dei sei: 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」 è grammaticalmente corretto, ma suona come una traduzione. Su una pagina prodotto richiederebbe una revisione umana; per articoli di supporto o documentazione interna resta più che adeguato.
La distanza esiste, ma è contenuta: tutti e sei hanno generato un giapponese utilizzabile. Il sovrapprezzo di circa ~$1 ogni 1.000 attività per Claude si giustifica nel lavoro sulla voce del brand; in nessun altro test è emerso con altrettanta evidenza.
Test 2: documentazione tecnica dall'inglese al tedesco
Abbiamo tradotto due frasi di documentazione API su rate limit, HTTP 429, backoff esponenziale e chiavi di idempotenza. Tutti e sei i modelli hanno reso correttamente i termini tecnici e adottato le convenzioni idiomatiche della documentazione tedesca: Ratenlimit, Statuscode 429, exponentielles Backoff, Idempotenzschlüssel.
L'unica differenza visibile: GPT-5.6 Terra ha racchiuso Retry-After nella formattazione da codice, proprio come accade nella documentazione API tedesca reale. Un dettaglio apprezzabile, non un divario qualitativo.
Sulla prosa documentale standard tra lingue europee ben supportate, nessun modello del campione ha commesso errori; a questa generazione, le differenze di qualità erano troppo piccole per essere osservate. Se questo è tutto il vostro carico di lavoro, scegliete in base a costo e velocità, non alla qualità. DeepSeek V4 Flash diventa quindi la risposta predefinita, a $0.14 in input / $0.28 in output per milione di token.
Test 3: dialogo giapponese-inglese con soggetti sottintesi
In giapponese il soggetto viene omesso di frequente: chi traduce deve dedurre chi fa cosa. Il dialogo di prova includeva anche 根回し (nemawashi), ovvero la costruzione discreta del consenso prima di una decisione formale, un termine legato al contesto culturale e privo di un equivalente inglese diretto.
Cinque modelli su sei hanno gestito tutto correttamente. I soggetti sono stati attribuiti nel modo giusto e nemawashi è stato reso come "lay the groundwork", "sound him out beforehand" o "give him a heads-up": tutte scelte difendibili. La versione di Claude era quella più vicina a un dialogo madrelingua, con "he's probably gonna chew me out".
L'unico errore concreto tra tutti i 18 output è arrivato da DeepSeek V4 Pro. Ha tradotto 「先に根回ししといたほうがいい」, un consiglio su cosa fare in seguito, con "You should've laid the groundwork first", esprimendo invece il rimpianto al passato per qualcosa che non è stato fatto. Poche parole, significato opposto. Se un collega dicesse l'una e voi capiste l'altra, agireste diversamente.
Un errore di tempo verbale in una singola esecuzione è un dato, non una sentenza sul modello; il confronto fra i due livelli DeepSeek è approfondito nella nostra comparazione DeepSeek V4 Flash vs Pro. Resta però un promemoria utile: fluidità e fedeltà non sono la stessa cosa. La frase suona perfetta, ma comunica il significato sbagliato. Per contratti, contenuti medici o qualsiasi testo in cui interpretare male un tempo verbale costa denaro, prevedete una revisione umana indipendentemente dal modello scelto.
La trappola dei token: perché il listino non basta
Questo è il dato che cambia la decisione d'acquisto. Per milione di token di output, GLM-5.2 costa $4.40 e Kimi K2.6 $4.00, meno della metà dei $10 di Claude Sonnet 5. Per ogni traduzione eseguita, però, sono risultati 8–10 volte più costosi.
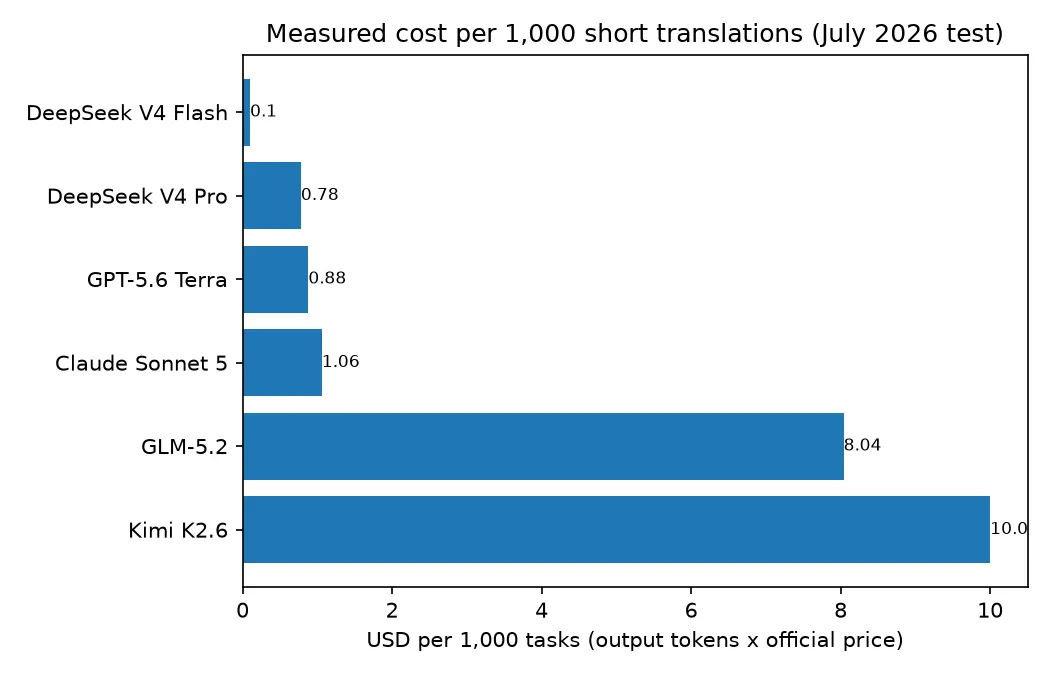
Il motivo è semplice: entrambi i modelli producono una catena di ragionamento visibile prima della risposta, e i token di ragionamento vengono fatturati come output. Per tradurre una sola frase marketing, Kimi K2.6 ha emesso 2,849 token di output e GLM-5.2 1,906, a fronte di traduzioni da 40–60 token. Claude Sonnet 5 ha impiegato 60 token sullo stesso compito; GPT-5.6 Terra, 46.
La latenza segue lo stesso schema. GPT-5.6 Terra e Claude Sonnet 5 hanno risposto in 3–4 secondi in tutti e tre i test. DeepSeek V4 Flash ha richiesto 4–5s, DeepSeek V4 Pro 16–20s, mentre GLM-5.2 e Kimi K2.6 sono rimasti fra 20 e 48 secondi per richiesta.
Da qui derivano due regole pratiche. Primo: per attività brevi e ad alto volume come la traduzione, confrontate i modelli sul costo misurato per attività, non sul prezzo di listino; fate 20 richieste e controllate il campo usage. Secondo: disattivate, o almeno riducete, il ragionamento per le traduzioni. DeepSeek separa endpoint con e senza thinking, mentre GLM e Kimi espongono parametri thinking nel body della richiesta. Nei nostri tre test, la catena di ragionamento non ha aggiunto nulla di rilevabile alla qualità dell'output.
Il costo della traduzione su larga scala
Proiettando il consumo di token misurato su un milione di caratteri di testo sorgente inglese, circa 250,000 token, la differenza diventa enorme:
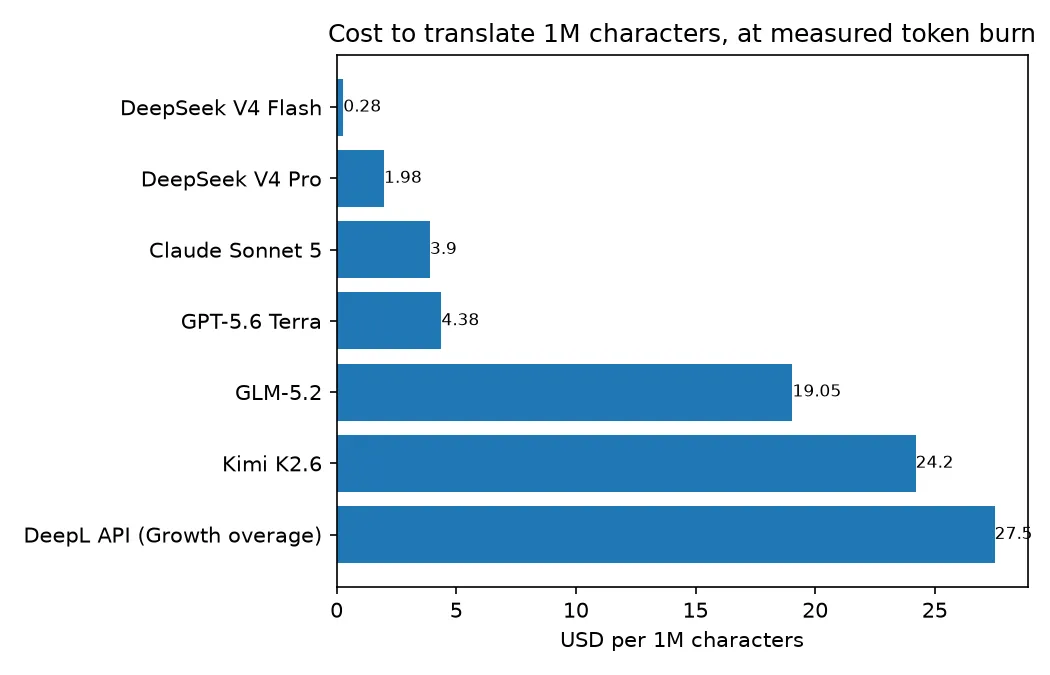
DeepSeek V4 Flash traduce un volume di testo pari a un intero romanzo per circa $0.28. Lo stesso volume tramite l'API di DeepL costa $27.50 alle tariffe per eccedenza del piano Growth: una differenza di 98 volte. Il dato è coerente con l'analisi molto condivisa su r/LocalLLaMA, intitolata "LLMs are 800x cheaper for translation than DeepL", il cui moltiplicatore più alto dipendeva da modelli self-hosted più piccoli.
Osservate però la parte alta del grafico: con il consumo di token effettivamente misurato, i modelli open-weight che ragionano intensivamente arrivano quasi a colmare il divario con DeepL. Il prezzo unitario, senza misurare i token, non è una stima di costo.
Prima di impegnarvi, ci sono tre aspetti tariffari da conoscere, tutti verificati il 17 luglio 2026:
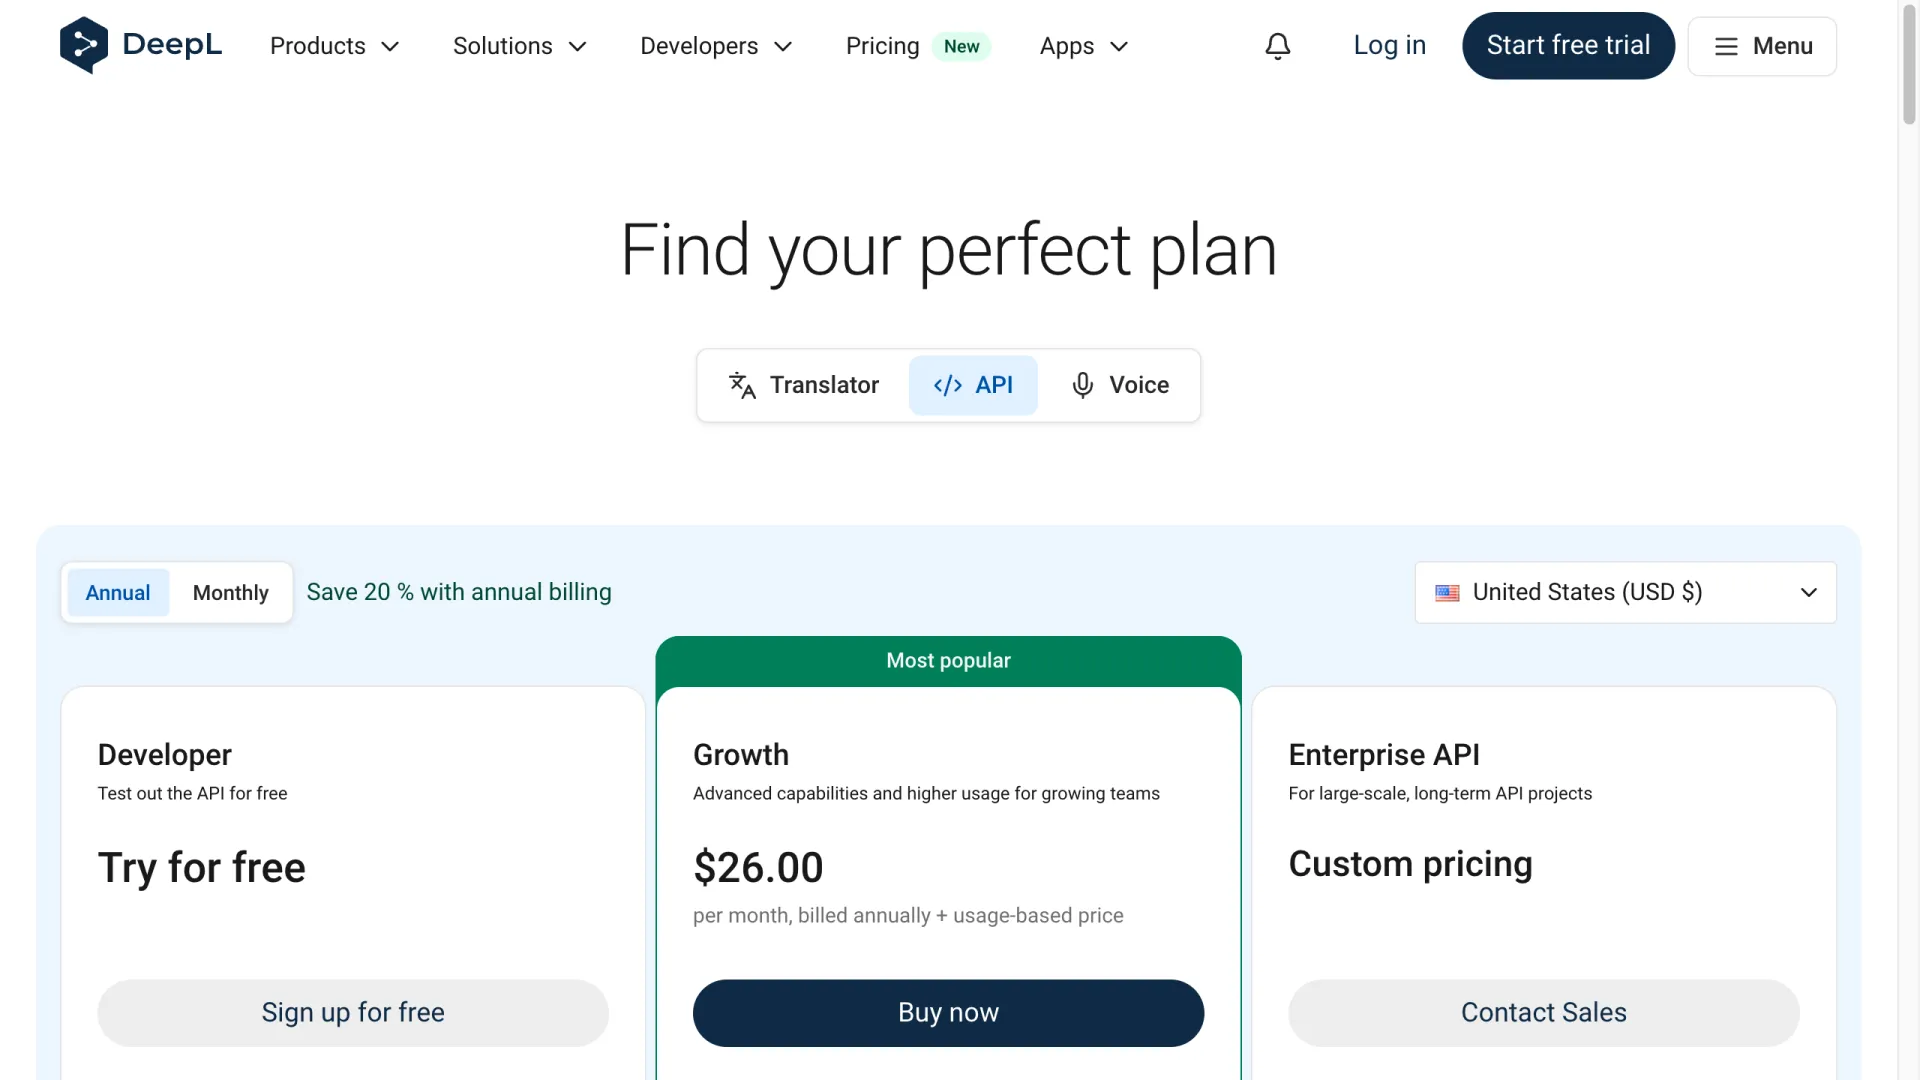
- Il piano gratuito di DeepL è cambiato. Il piano API Developer offre ora un credito una tantum di 1,000,000 di caratteri, non i 500,000 caratteri mensili ancora citati in vecchia documentazione e discussioni sui forum. Growth costa $26/mese con fatturazione annuale, include 12M di caratteri/anno e poi applica $27.50 per ogni milione aggiuntivo.
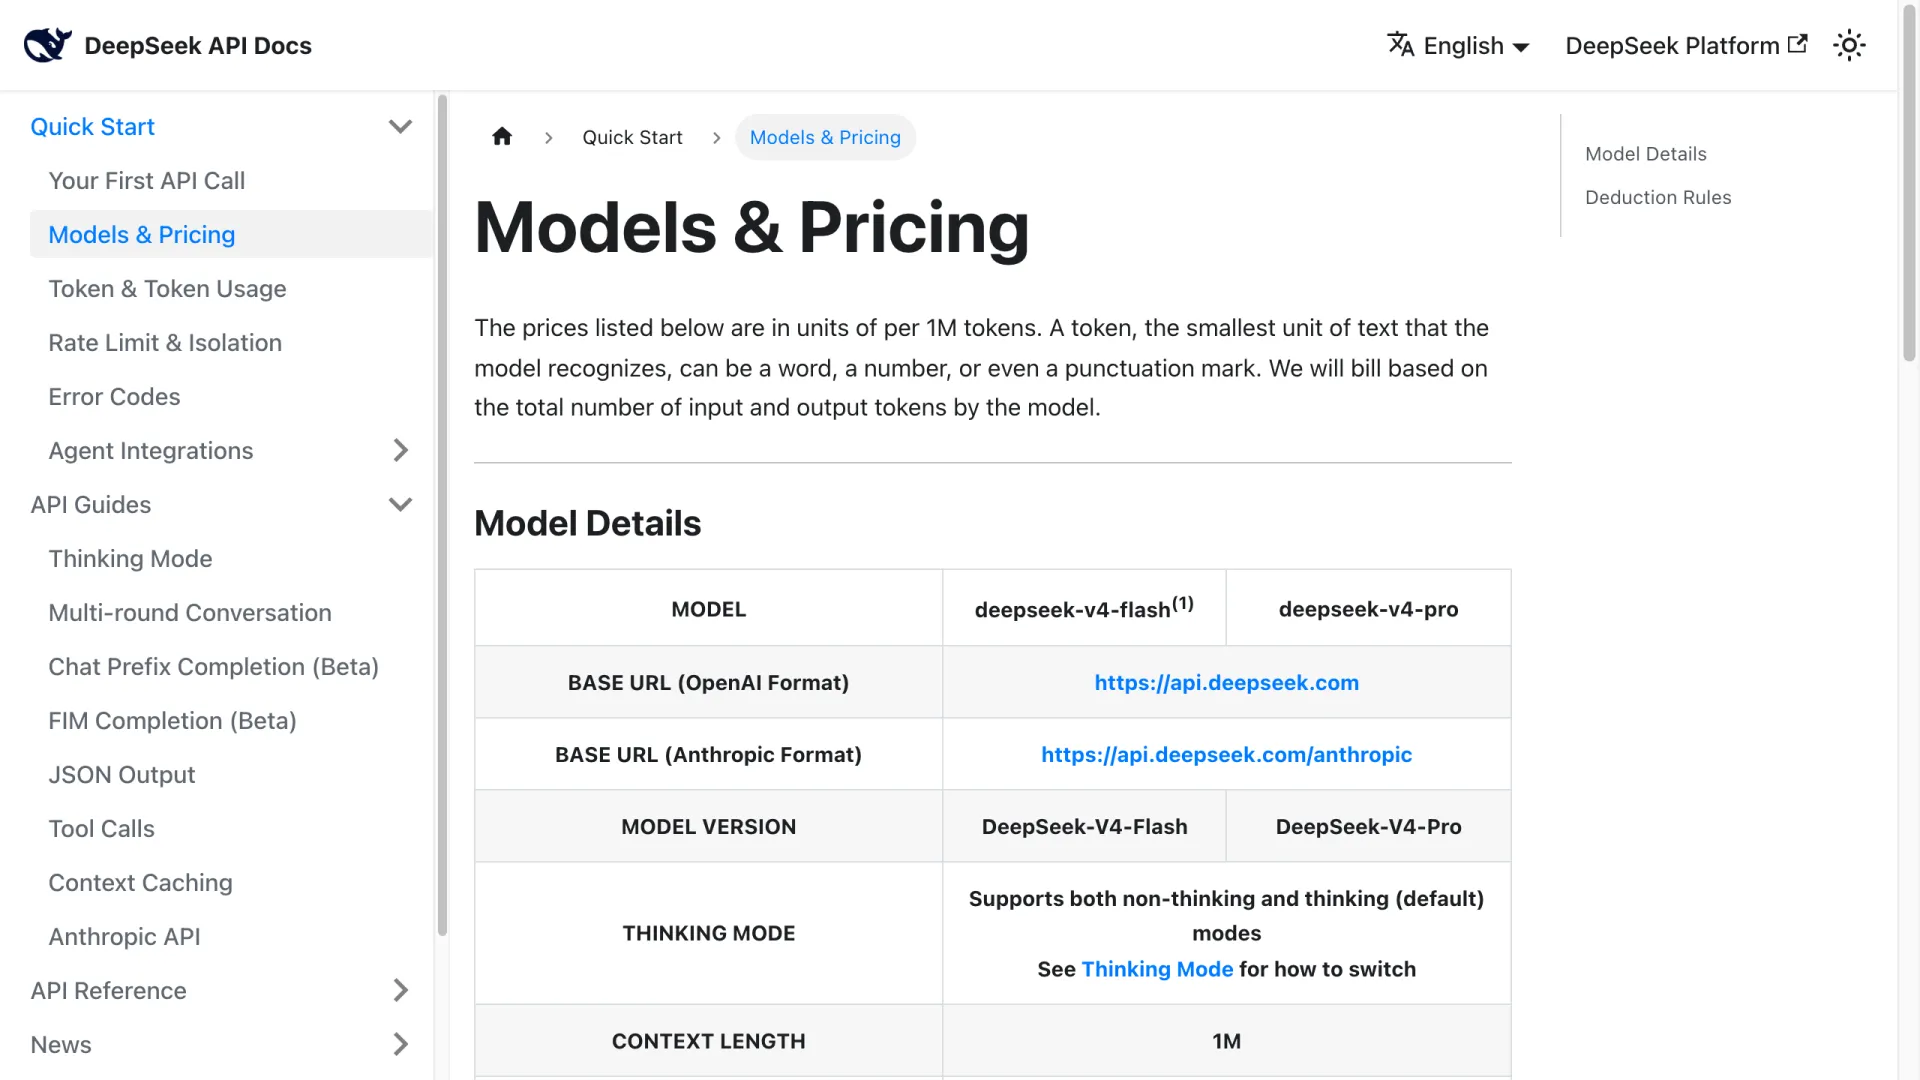
- DeepSeek fattura una frazione rispetto agli altri. Per V4 Flash: $0.14 in input / $0.28 in output per milione di token; l'input da cache-hit scende a $0.0028. Il vecchio nome del modello deepseek-chat verrà ritirato il 24 luglio 2026.
- Claude Sonnet 5 è in prezzo promozionale. $2/$10 per milione di token fino al 31 agosto 2026, poi $3/$15. Il suo tokenizer più recente produce inoltre circa il 30% di token in più a parità di testo, fattore già incluso nei nostri calcoli. Se pianificate oltre settembre, considerate entrambi gli aspetti nel budget.
- Le API batch dimezzano la spesa. OpenAI, Anthropic e Google offrono tutti sconti di circa il 50% per l'elaborazione batch asincrona. Le traduzioni di solito non sono sensibili alla latenza, quindi è un risparmio senza controindicazioni: il batch porta GPT-5.6 Terra a circa ~$2.19 e Claude Sonnet 5 a circa ~$1.95 per milione di caratteri.
Quando DeepL o Google Translate restano preferibili
Sul costo per carattere gli LLM vincono, ma tre esigenze portano ancora nella direzione opposta:
- Terminologia vincolante. DeepL offre glossari e termbase che assicurano la stessa traduzione per un termine, ogni volta. Con un LLM potete chiederlo nel prompt e verificarlo, ma è un comportamento probabilistico, non garantito.
- Integrazione con CAT tool e pipeline. Se la vostra memoria di traduzione vive in un CAT tool, gli adattatori DeepL si collegano direttamente.
- Latenza sotto il secondo su scala. I motori NMT tradizionali rispondono in genere più rapidamente degli LLM generici; per tradurre elementi dell'interfaccia in linea, fa la differenza.
Per la voce in tempo reale, né l'NMT classico né un LLM conversazionale hanno il formato giusto. Google propone una variante dedicata di Gemini 3.5 Live Translate, a $3.50/$21 per milione di token più tariffe audio al minuto, descritta nel nostro approfondimento su Gemini 3.5 Live Translate.
Per lingue rare o con poche risorse, la copertura conta più delle classifiche qualitative: prima di confrontare qualsiasi altro parametro, verificate che la coppia linguistica sia supportata. DeepL copre circa 30 lingue; i grandi LLM ne gestiscono oltre un centinaio, con qualità in calo procedendo verso le lingue meno diffuse.
Alternative open source e locali
Sia GLM-5.2 sia la serie K di Kimi pubblicano pesi open, quindi il problema del consumo di token visto sopra è risolvibile in self-hosting: controllate le impostazioni di sampling e potete eliminare del tutto le catene di ragionamento.
Per la traduzione locale su una sola GPU, Qwen3-30B-A3B è il nome che ricorre più spesso nelle discussioni r/LocalLLaMA sui modelli di traduzione locale per le lingue europee verso l'inglese; al crescere dell'originalità della coppia linguistica, vengono consigliati modelli più grandi. La motivazione principale è in genere la privacy, per contratti o prodotti non ancora annunciati, oppure l'assenza di costo marginale, più che la qualità. Nelle stesse discussioni, i modelli frontier in hosting vengono ancora descritti come superiori nella traduzione.
Da tenere d'occhio: Kimi K3 è arrivato questa settimana con pesi open e un prezzo hosted di $3/$15 per milione di token. Abbiamo testato K2.6 perché l'accesso API a K3 era ancora in fase di rollout; se K3 erediterà l'appetito di token della serie K, varrà la stessa avvertenza sul costo misurato.
Come ripetere il confronto
Tutto quanto descritto qui è riproducibile con circa 20 chiamate API: scegliete due frasi dei vostri contenuti, inviatele a ogni modello candidato e leggete l'oggetto usage in ciascuna risposta per ottenere i conteggi token reali. Il costo totale della nostra esecuzione di prova da 18 richieste è stato inferiore a $0.15.
La parte scomoda è gestire sei chiavi API di cinque provider. Noi abbiamo eseguito tutti e sei i modelli attraverso un unico account AIReiter, che rivende l'accesso API ai principali modelli, comprese chiavi della famiglia Claude a circa un quinto del prezzo di listino, dietro un solo endpoint compatibile con Anthropic: una chiave e lo stesso formato wire per tutti i modelli qui elencati.
Se i vostri volumi di traduzione sono reali, dedicare un'ora a test a campione sui vostri contenuti vale più di qualsiasi classifica, inclusa questa. I modelli sono abbastanza vicini sul piano qualitativo da rendere decisivi la coppia linguistica, i requisiti di tono e le misurazioni dei token.
FAQ
ChatGPT o Gemini: qual è migliore per tradurre?
Nei nostri test, GPT-5.6 Terra è stato rapido, accurato e ordinato nella formattazione in tutte e tre le attività. Non abbiamo confrontato Gemini direttamente, perché non era disponibile sul nostro gateway, ma i suoi prezzi pubblicati sono competitivi: $1.50/$9 per milione di token per 3.5 Flash. Inoltre, è l'unico provider con un modello dedicato alla traduzione vocale live.
Qual è oggi il traduttore AI più accurato?
Per le coppie linguistiche ad alta disponibilità di dati, le differenze di accuratezza tra i modelli frontier sono ridotte: tutti e sei i modelli testati hanno tradotto il tedesco tecnico senza errori. Le differenze si concentrano nel tono, dove Claude ha primeggiato nel copy marketing giapponese, e nei casi limite legati a soggetti sottintesi e tempi verbali, in cui DeepSeek V4 Pro ha commesso l'unico errore concreto del campione.
Qual è il miglior LLM open source per la traduzione?
GLM-5.2 e Kimi K2.6 pubblicano entrambi i pesi e hanno tradotto correttamente nei nostri test; con il self-hosting potete disattivare le catene di ragionamento che rendono costose le loro API hosted per singola attività. Per hardware consumer, Qwen3-30B-A3B è il suggerimento più comune nella community.
Un LLM può sostituire un traduttore umano?
Per documentazione interna, contenuti di supporto e grandi quantità di testo prodotto: in larga parte sì, a un costo pari all'1–16% di DeepL per carattere a seconda del modello: DeepSeek V4 Flash ~1%, Claude Sonnet 5 ~14%, GPT-5.6 Terra ~16%. Per contratti, testi medici e campagne di brand, l'errore di tempo verbale del Test 3 è un monito. Un output fluido può comunque ribaltare il significato: mantenete una revisione umana quando una lettura errata è costosa.
DeepL vale ancora la pena nel 2026?
Sì, in tre casi: glossari obbligatori, integrazione con CAT tool e latenza sotto il secondo. Al di fuori di questi scenari, il calcolo per carattere è difficile da giustificare. Da ricordare inoltre che il piano gratuito è ora un credito una tantum da 1M di caratteri, non un credito mensile.