 AIREITER
Pour le ton, choisissez Claude Sonnet 5. Pour les très gros volumes, DeepSeek V4 Flash revient à environ 0,10 $ pour 1 000 tâches. Et pour le meilleur compromis global en vitesse, GPT-5.6 Terra arrive en tête. Voilà notre conclusion après avoir testé six modèles le 17 juillet 2026.
Nous avons envoyé les trois mêmes prompts de traduction à l’API de chaque modèle, puis comparé leurs sorties brutes. La vraie surprise n’était pas la qualité : les six ont correctement traduit l’allemand technique, et cinq sur six ont restitué un dialogue japonais aux sujets implicites sans la moindre erreur. C’est le coût qui a changé la lecture des résultats. Deux modèles présentés comme bon marché ont consommé tant de tokens de raisonnement par requête qu’ils ont finalement coûté 8 à 10 fois plus cher par traduction que Claude, se rapprochant dangereusement des tarifs de DeepL au caractère.
En 2026, choisir le meilleur LLM de traduction ne consiste donc pas tant à chercher un modèle capable de traduire — ils le sont tous — qu’à trouver celui qui convient à votre contenu et à vos volumes sans faire exploser la facture en silence.
Quel modèle choisir selon vos traductions
| Votre usage | Choix recommandé | Pourquoi | Coût mesuré pour 1 000 tâches |
|---|---|---|---|
| Textes marketing, voix de marque | Claude Sonnet 5 | Le texte semble avoir été écrit dans la langue cible, pas traduit | ~1,06 $ |
| Gros volumes : catalogues produits, documentation, sous-titres | DeepSeek V4 Flash | Correct sur les trois tests, et de très loin le moins cher | ~0,10 $ |
| Charges mixtes, latence minimale | GPT-5.6 Terra | Réponses en 3,0–4,3 s, mise en forme la plus propre | ~0,88 $ |
| Respect des glossaires, flux avec outils de TAO | DeepL | Bases terminologiques et intégrations absentes des API de LLM | 27,50 $ par 1M de caractères |
Les coûts sont des moyennes issues de nos trois tâches de test — tokens de sortie × tarifs officiels de juillet 2026 — extrapolées à 1 000 courtes traductions. Le tableau de mesures complet se trouve plus bas. Une catégorie reste hors test : pour la conversation vocale en direct, Google commercialise une variante Gemini 3.5 Live Translate dédiée à 3,50 $/21 $ par million de tokens. Nous la mentionnons, mais ne l’avons pas testée.
Notre protocole de test
Trois prompts, six modèles, une seule exécution chacun, le 17 juillet 2026, avec exactement le même libellé : anglais→japonais pour un texte marketing afin d’évaluer le ton ; anglais→allemand pour de la documentation API afin de vérifier la terminologie ; et japonais→anglais pour un dialogue familier afin de tester les sujets implicites et le contexte, l’échec classique des paires CJK. CJK désigne le chinois, le japonais et le coréen, les trois langues où se concentrent les plaintes sur la qualité de la traduction automatique.
Les modèles testés : GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 et Kimi K2.6. Tous les appels sont passés par le même compte de passerelle, avec les réglages par défaut. Les chiffres de latence sont donc comparables entre eux, mais varieront selon votre région et la charge du fournisseur.
Voici les trois textes source, reproduits à l’identique pour vous permettre de relancer les essais :
EN→JA (marketing) : "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (technique) : "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (dialogue) : 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Toutes les mesures, modèle par modèle et tâche par tâche — latence en secondes réelles / tokens de sortie issus de l’objet d’usage :
| Modèle | EN→JA | EN→DE | JA→EN | Coût moyen par tâche |
|---|---|---|---|---|
| GPT-5.6 Terra | 3,0 s / 46 | 4,3 s / 67 | 3,2 s / 63 | 0,00088 $ |
| Claude Sonnet 5 | 3,5 s / 60 | 4,0 s / 146 | 3,5 s / 111 | 0,00106 $ |
| DeepSeek V4 Flash | 5,2 s / 421 | 4,3 s / 371 | 4,7 s / 323 | 0,00010 $ |
| DeepSeek V4 Pro | 16,5 s / 769 | 18,0 s / 989 | 19,6 s / 946 | 0,00078 $ |
| GLM-5.2 | 30,8 s / 1 906 | 29,0 s / 1 590 | 35,2 s / 1 985 | 0,00804 $ |
| Kimi K2.6 | 19,6 s / 2 849 | 48,5 s / 2 235 | 23,6 s / 2 413 | 0,01000 $ |
Coût par tâche = tokens de sortie × tarif officiel de sortie du fournisseur. L’entrée représente 60–110 tokens par tâche et ajoute moins de 0,0003 $, même aux tarifs de GPT-5.6 Terra ; le graphique par million de caractères, plus bas, l’inclut. Tous les prix sont les tarifs catalogue officiels au 17 juillet 2026, et non les tarifs remisés facturés à notre compte.
Un contrôle ponctuel sur trois tâches ne permet pas de classer les modèles sur 100 paires de langues, et nous ne prétendons pas le faire. En revanche, il suffit à faire ressortir les écarts qui subsistent même sur un petit échantillon. Ils se sont révélés importants.
Test 1 : texte marketing anglais→japonais
Le prompt demandait une adaptation japonaise naturelle et polie d’une phrase destinée à une landing page SaaS : "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
Claude Sonnet 5 a produit ce texte :
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
C’est le registre qu’emploierait un rédacteur publicitaire japonais : le カタチ stylisé, en katakana pour « forme », et le rythme scandé par les virgules relèvent des codes des landing pages, pas de la grammaire scolaire. GPT-5.6 Terra et DeepSeek V4 Pro suivent de près avec des formulations nettes et professionnelles, comme 「アイデアを、より迅速に形に。」.
DeepSeek V4 Flash est le plus littéral des six : 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」est grammaticalement irréprochable, mais sonne comme une traduction. Pour une page produit, une relecture humaine serait souhaitable. Pour des articles d’assistance ou de la documentation interne, le résultat reste tout à fait exploitable.
L’écart est réel, mais limité : les six modèles livrent un japonais utilisable. C’est pour les contenus de marque que le surcoût d’environ 1 $ pour 1 000 tâches de Claude se justifie ; aucun autre test ne l’a rendu aussi déterminant.
Test 2 : documentation technique anglais→allemand
Nous avons traduit deux phrases de documentation API portant sur les limites de débit, le HTTP 429, le backoff exponentiel et les clés d’idempotence. Les six modèles ont employé les bons termes techniques et les conventions naturelles de la documentation allemande : Ratenlimit, Statuscode 429, exponentielles Backoff et Idempotenzschlüssel.
Une seule différence visible : GPT-5.6 Terra a placé Retry-After en formatage code, comme le feraient de véritables documents API allemands avec un nom d’en-tête. C’est une attention appréciable, pas un écart de qualité.
Sur une prose documentaire standard entre langues européennes bien dotées, aucun modèle de notre échantillon n’a fait d’erreur. À cette génération, les différences de qualité étaient trop faibles pour être observées. Si cela représente l’intégralité de votre charge, choisissez selon le prix et la vitesse, pas selon la qualité. Avec 0,14 $ en entrée et 0,28 $ en sortie par million de tokens, DeepSeek V4 Flash devient alors le choix par défaut.
Test 3 : dialogue japonais→anglais et sujets implicites
Le japonais omet couramment le sujet d’une phrase ; le traducteur doit donc déduire qui fait quoi. Notre dialogue contenait aussi 根回し (nemawashi), qui désigne la construction discrète d’un consensus avant une décision formelle : un terme culturel sans véritable équivalent direct en anglais.
Cinq modèles sur six ont tout bien géré. Les sujets étaient correctement attribués, et nemawashi a été rendu par « lay the groundwork », « sound him out beforehand » ou « give him a heads-up », trois choix défendables. La version de Claude était la plus naturelle à l’oreille dans le dialogue, avec « he’s probably gonna chew me out ».
La seule véritable erreur parmi les 18 sorties vient de DeepSeek V4 Pro. Il a traduit 「先に根回ししといたほうがいい」, un conseil sur ce qu’il faut faire ensuite, par « You should’ve laid the groundwork first », soit le regret au passé d’une occasion déjà manquée. Quelques mots seulement, mais un sens inversé. Si un collègue disait l’un et que vous entendiez l’autre, votre réaction ne serait pas la même.
Une erreur de temps sur une seule exécution est un point de donnée, pas un verdict sur le modèle — nous comparons plus en détail les deux niveaux DeepSeek dans notre comparatif DeepSeek V4 Flash vs Pro. Mais elle rappelle utilement que fluidité et fidélité sont deux qualités distinctes : la phrase semble parfaite tout en disant l’inverse. Pour les contrats, les contenus médicaux ou tout texte où une mauvaise lecture d’un temps verbal coûte de l’argent, prévoyez une révision humaine, quel que soit le modèle retenu.
Le piège des tokens : pourquoi les grilles tarifaires trompent
C’est le constat qui change réellement la décision d’achat. Au million de tokens de sortie, GLM-5.2 coûte 4,40 $ et Kimi K2.6 4,00 $, soit moins de la moitié des 10 $ de Claude Sonnet 5. Pourtant, sur chaque traduction effectivement réalisée, ils se sont avérés 8 à 10 fois plus chers.
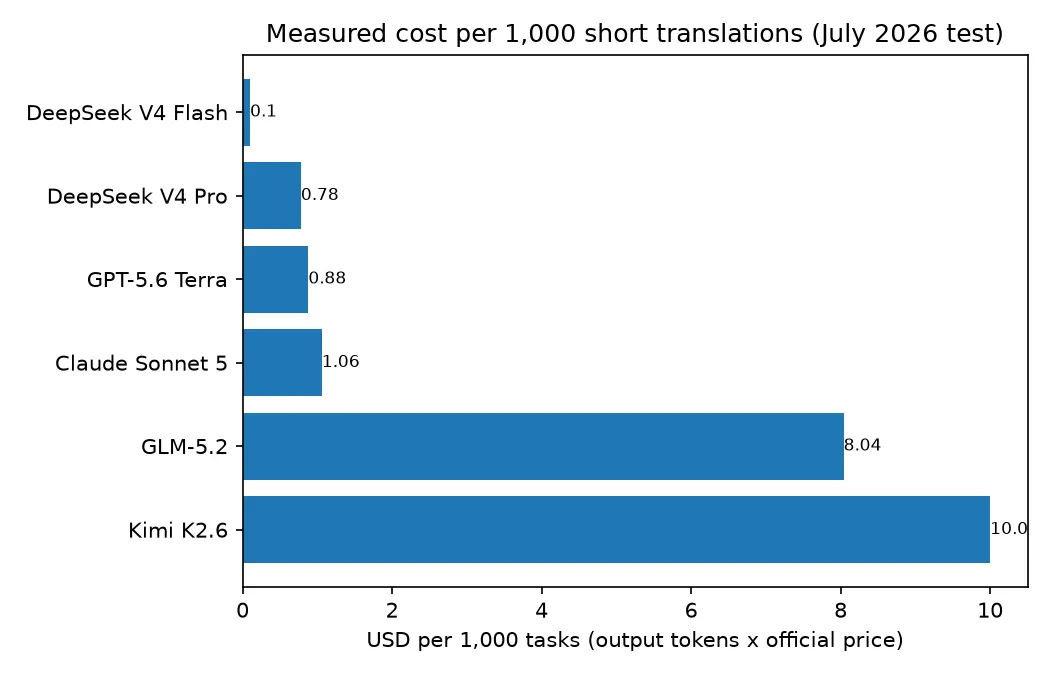
Le mécanisme est simple : ces deux modèles déroulent une chaîne de raisonnement visible avant de répondre, et ces tokens de raisonnement sont facturés comme des tokens de sortie. Pour traduire une phrase marketing, Kimi K2.6 a émis 2 849 tokens de sortie et GLM-5.2, 1 906, pour des traductions de 40 à 60 tokens. Claude Sonnet 5 en a consommé 60 pour la même tâche ; GPT-5.6 Terra, 46.
La latence suit le même schéma. GPT-5.6 Terra et Claude Sonnet 5 ont répondu en 3 à 4 secondes sur les trois tâches. DeepSeek V4 Flash a pris 4 à 5 s, DeepSeek V4 Pro 16 à 20 s, tandis que GLM-5.2 et Kimi K2.6 ont mis entre 20 et 48 secondes par requête.
Deux règles pratiques en découlent. D’abord, pour les tâches courtes et volumineuses comme la traduction, comparez les modèles selon leur coût réel par tâche, et non leur prix catalogue : lancez 20 requêtes et consultez le champ d’usage. Ensuite, désactivez ou réduisez le raisonnement pour la traduction : DeepSeek sépare ses endpoints avec et sans réflexion, tandis que GLM et Kimi exposent des paramètres de réflexion dans le corps de la requête. Sur nos trois tâches, la chaîne de raisonnement n’a apporté aucune amélioration détectable à la qualité finale.
Le coût de la traduction à grande échelle
En extrapolant la consommation mesurée à un million de caractères de texte source anglais, soit environ 250 000 tokens, l’écart devient spectaculaire :
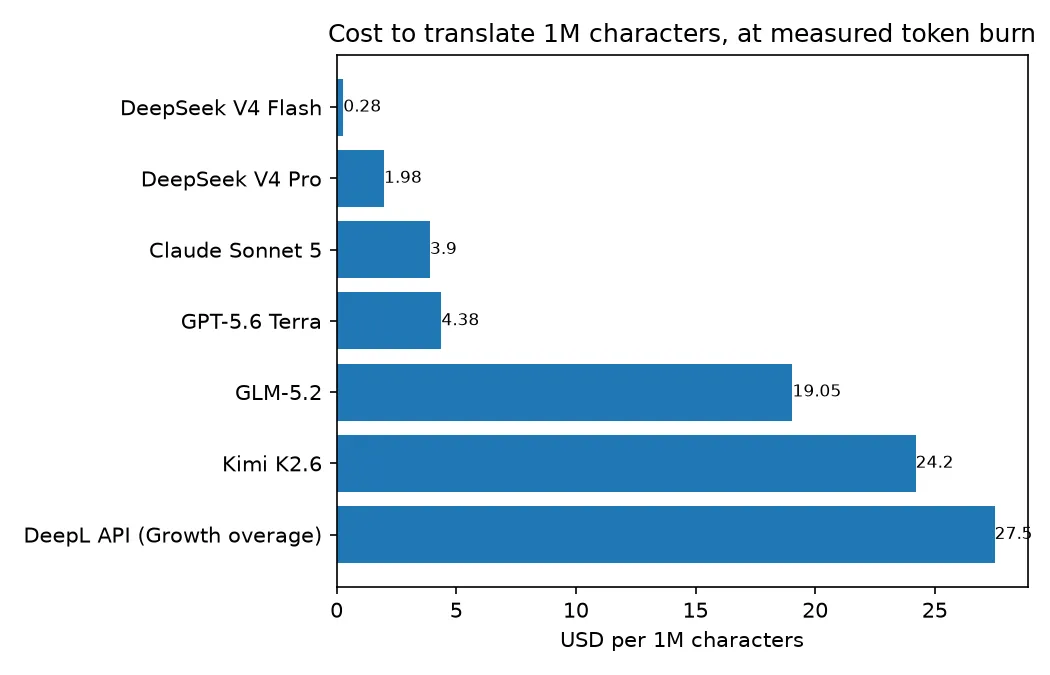
DeepSeek V4 Flash traduit l’équivalent d’un roman complet pour environ 0,28 $. Le même volume via l’API DeepL coûte 27,50 $ aux tarifs de dépassement du plan Growth : un rapport de 98×. Cela va dans le même sens qu’une analyse très partagée sur r/LocalLLaMA, intitulée "LLMs are 800x cheaper for translation than DeepL", dont le multiplicateur plus élevé reposait sur de plus petits modèles auto-hébergés.
Regardez toutefois le haut du graphique : avec leur consommation réelle de tokens, les modèles open-weight gourmands en raisonnement comblent presque l’écart avec DeepL. Sans mesure des tokens, le prix unitaire n’est pas une estimation de coût.
Avant de vous engager, voici trois éléments tarifaires à connaître, tous vérifiés le 17 juillet 2026 :
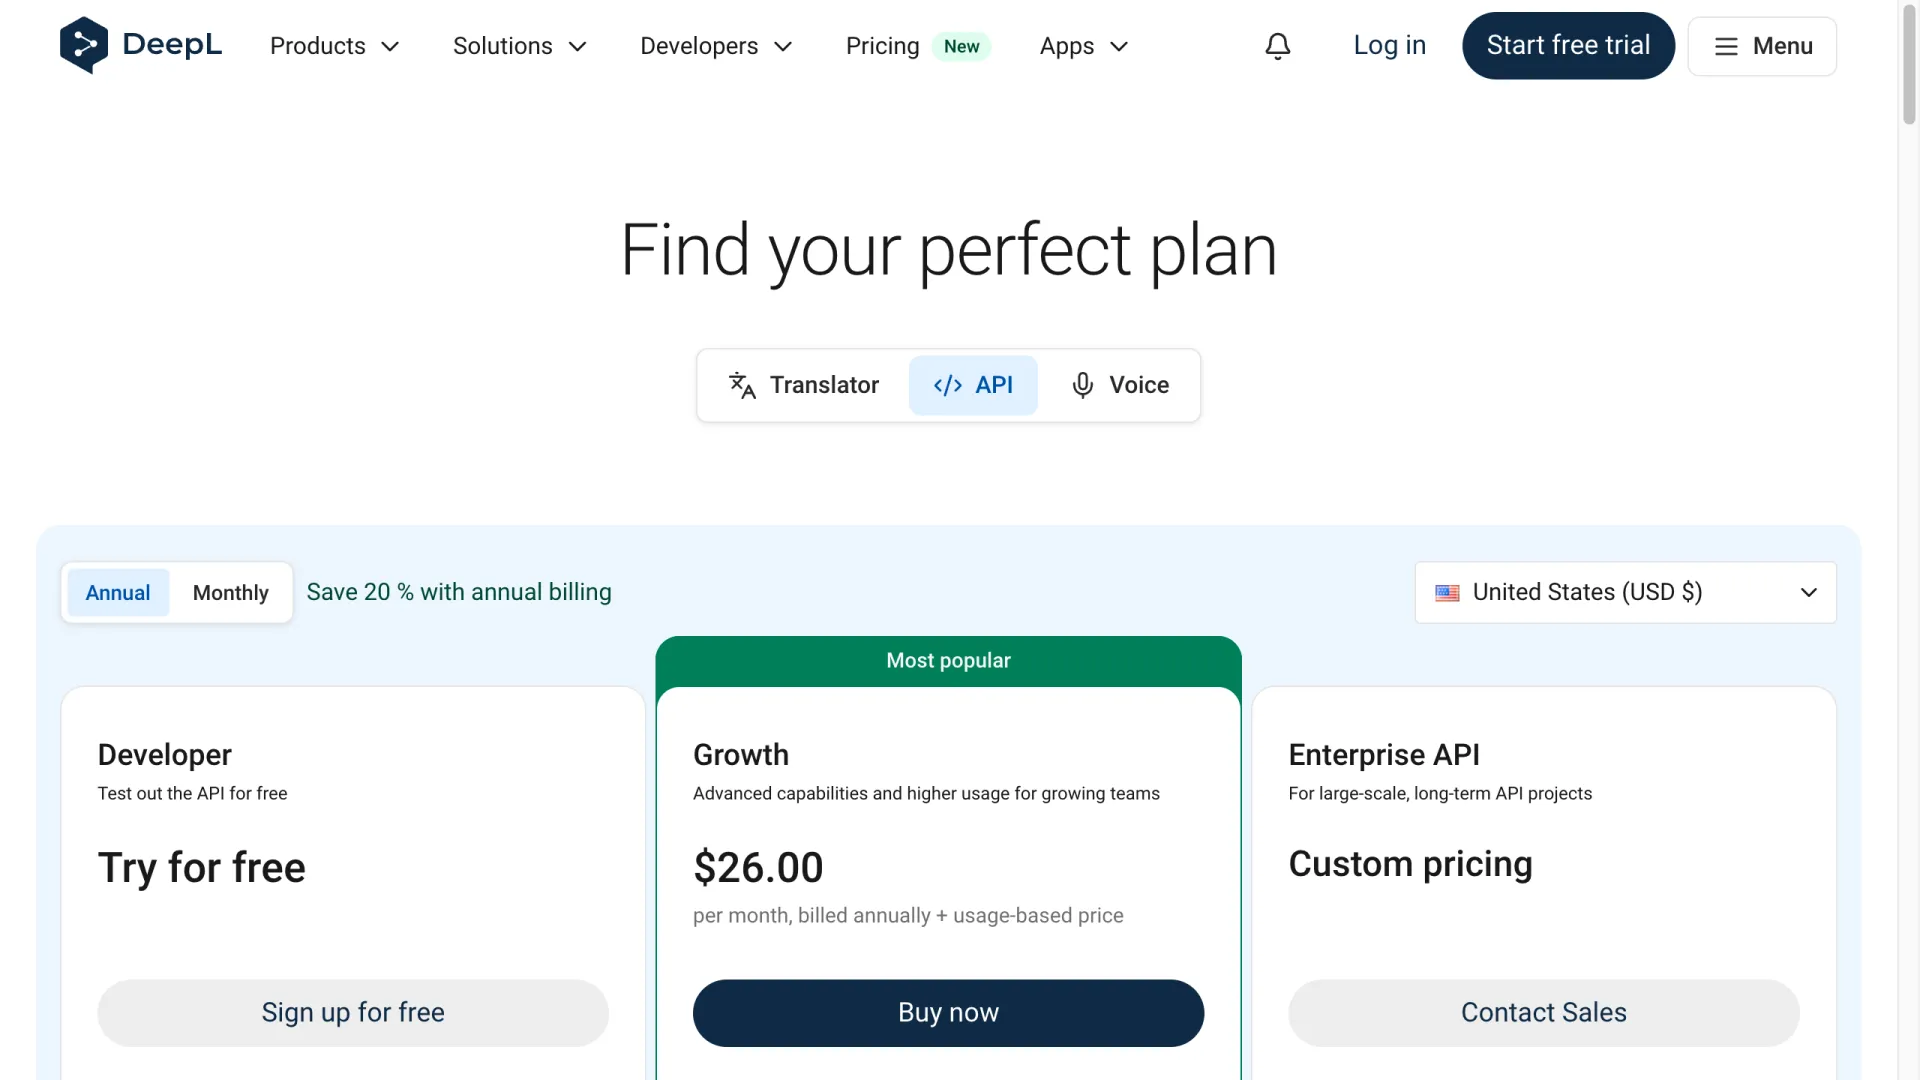
- L’offre gratuite de DeepL a changé. Le plan API Developer accorde désormais un crédit unique de 1 000 000 de caractères, et non l’allocation mensuelle de 500 000 caractères encore citée dans d’anciens documents et sur les forums. Growth coûte 26 $/mois, facturés annuellement, avec 12M de caractères/an inclus, puis 27,50 $ par million supplémentaire.
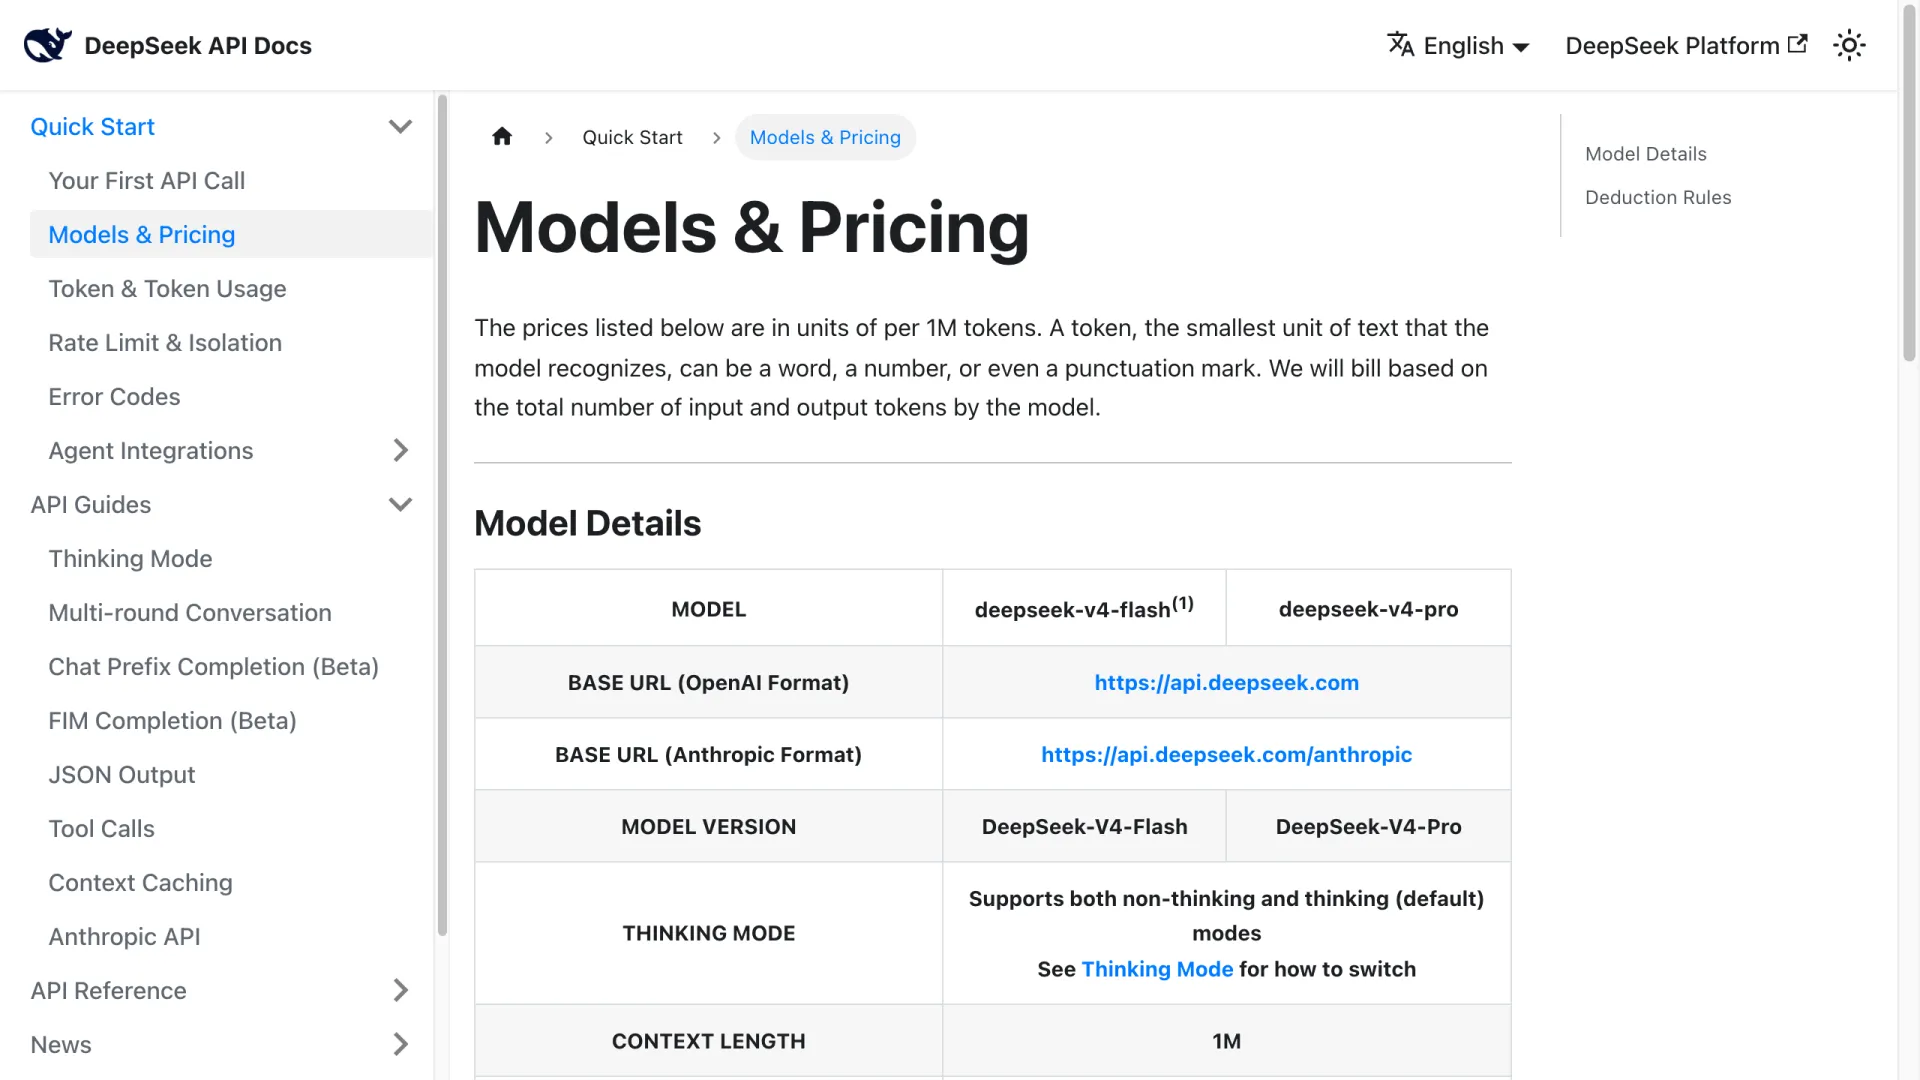
- DeepSeek facture une fraction des autres fournisseurs. V4 Flash coûte 0,14 $ en entrée / 0,28 $ en sortie par million de tokens, avec une entrée sur cache-hit qui tombe à 0,0028 $. L’ancien nom de modèle deepseek-chat est retiré le 24 juillet 2026.
- Claude Sonnet 5 bénéficie d’un tarif de lancement. 2 $/10 $ par million de tokens jusqu’au 31 août 2026, puis 3 $/15 $. Son tokenizer plus récent produit aussi environ 30 % de tokens supplémentaires à texte égal, ce que notre calcul inclut. Tenez compte des deux facteurs si votre budget dépasse septembre.
- Les API batch divisent la facture par deux. OpenAI, Anthropic et Google proposent tous environ 50 % de remise pour le traitement asynchrone par lots. La traduction est généralement peu sensible à la latence : c’est une économie facile. En batch, GPT-5.6 Terra descend à environ 2,19 $ et Claude Sonnet 5 à environ 1,95 $ par million de caractères.
Dans quels cas DeepL ou Google Translate restent meilleurs
Les LLM gagnent sur l’économie au caractère, mais trois besoins font encore pencher la balance de l’autre côté :
- Terminologie imposée. DeepL fournit des glossaires et des bases terminologiques qui garantissent qu’un terme sera toujours traduit de la même façon. Avec un LLM, vous l’indiquez dans le prompt puis le vérifiez : c’est probabiliste, pas imposé.
- Intégration aux outils de TAO et aux pipelines. Si votre mémoire de traduction vit dans un outil de TAO, ou traduction assistée par ordinateur, les connecteurs DeepL s’y branchent directement.
- Latence inférieure à la seconde à grande échelle. Les moteurs de traduction neuronale classiques répondent généralement plus vite que les LLM généralistes ; pour une traduction intégrée dans l’interface, cela compte.
Pour la voix en direct, ni la NMT classique ni un LLM conversationnel ne sont vraiment adaptés. Google facture une variante Gemini 3.5 Live Translate dédiée à 3,50 $/21 $ par million de tokens, avec des tarifs audio à la minute. Nous l’avons détaillée dans notre analyse de Gemini 3.5 Live Translate.
Pour les langues rares et peu dotées, la couverture compte davantage qu’un classement de qualité : vérifiez d’abord que votre paire linguistique est prise en charge. DeepL prend en charge environ 30 langues ; les grands LLM en gèrent plus d’une centaine, avec une qualité qui se dégrade vers les langues les moins représentées.
Options open source et locales
GLM-5.2 comme la série K de Kimi publient leurs poids open source. Si vous les auto-hébergez, le problème de consommation de tokens évoqué plus haut devient donc corrigeable : vous contrôlez les paramètres d’échantillonnage et pouvez supprimer entièrement les chaînes de raisonnement.
Pour traduire localement sur un seul GPU, Qwen3-30B-A3B est la recommandation qui revient régulièrement dans les fils r/LocalLLaMA consacrés aux modèles de traduction locaux, pour les langues européennes vers l’anglais. Des modèles plus grands sont conseillés à mesure que la paire devient plus exotique. La motivation est généralement la confidentialité — contrats, produits non annoncés — ou l’absence de coût marginal, plutôt que la qualité : dans ces mêmes discussions, les modèles de pointe hébergés sont encore considérés comme meilleurs traducteurs.
À surveiller : Kimi K3 est sorti cette semaine avec des poids ouverts, à 3 $/15 $ par million de tokens en hébergé. Nous avons testé K2.6 car l’accès API de K3 était encore en cours de déploiement ; si K3 hérite de l’appétit en tokens de la série K, la même réserve sur le coût réel s’appliquera.
Refaire la comparaison vous-même
Tout ce qui précède est reproductible avec une vingtaine d’appels API : choisissez deux phrases issues de votre propre contenu, envoyez-les à chaque modèle candidat, puis consultez l’objet d’usage de chaque réponse pour obtenir les vrais volumes de tokens. Coût total de notre série de 18 requêtes : moins de 0,15 $.
La partie pénible consiste à gérer six clés API provenant de cinq fournisseurs. Nous avons exécuté les six modèles via un compte AIReiter, qui revend l’accès API aux principaux modèles — avec des clés de la famille Claude à environ un cinquième du prix catalogue — derrière un endpoint unique compatible Anthropic : une clé, et le même format d’échange pour tous les modèles ci-dessus.
Si vos volumes de traduction sont conséquents, une heure de vérifications sur votre propre contenu vaut mieux que n’importe quel classement, y compris celui-ci. Les modèles sont assez proches en qualité pour que votre paire linguistique, vos exigences de ton et vos mesures de tokens tranchent la décision.
FAQ
ChatGPT ou Gemini : lequel traduit le mieux ?
Dans nos tests, GPT-5.6 Terra s’est montré rapide, précis et propre sur la mise en forme dans les trois tâches. Nous n’avons pas confronté Gemini directement, car il n’était pas disponible sur notre passerelle, mais ses tarifs publiés sont compétitifs — 1,50 $/9 $ par million de tokens pour 3.5 Flash — et c’est le seul fournisseur à proposer un modèle dédié à la traduction vocale en direct.
Quel est actuellement le traducteur IA le plus précis ?
Pour les paires de langues bien dotées, les écarts de précision entre modèles de pointe sont faibles : les six modèles testés ont traduit l’allemand technique sans erreur. Les différences se concentrent sur le ton — Claude a dominé le texte marketing japonais — et sur les cas limites, comme les sujets implicites et les temps verbaux, où DeepSeek V4 Pro a commis la seule vraie erreur de notre échantillon.
Quel est le meilleur LLM open source pour la traduction ?
GLM-5.2 et Kimi K2.6 publient tous deux leurs poids et ont correctement traduit lors de nos tests. L’auto-hébergement permet de désactiver les chaînes de raisonnement qui rendent leurs API hébergées coûteuses par tâche. Sur du matériel grand public, Qwen3-30B-A3B est la recommandation la plus fréquente de la communauté.
Un LLM peut-il remplacer un traducteur humain ?
Pour la documentation interne, les contenus d’assistance et les textes produits en masse : largement oui, pour 1–16 % du coût au caractère de DeepL selon le modèle — DeepSeek V4 Flash ~1 %, Claude Sonnet 5 ~14 %, GPT-5.6 Terra ~16 %. Pour les contrats, les textes médicaux et les campagnes de marque, l’erreur de temps du Test 3 doit servir d’avertissement. Un texte fluide peut toujours inverser le sens : gardez une révision humaine là où une mauvaise interprétation coûte cher.
DeepL vaut-il encore le coup en 2026 ?
Oui dans trois cas : glossaires imposés, intégration aux outils de TAO et latence sous la seconde. En dehors de ces scénarios, le calcul au caractère est difficile à défendre. Notez aussi que l’offre gratuite est désormais un crédit unique de 1M de caractères, et non plus une allocation mensuelle.