 AIREITER
Claude Sonnet 5 liefert den besten Ton, DeepSeek V4 Flash ist mit rund 0,10 $ pro 1.000 Aufgaben die günstigste Lösung für große Mengen, und GPT-5.6 Terra ist der schnellste Allrounder. Das ist unser Fazit nach dem Test von sechs Modellen am 17. Juli 2026.
Alle Modelle bekamen über ihre APIs dieselben drei Übersetzungs-Prompts, anschließend haben wir die unbearbeiteten Ergebnisse verglichen. Die eigentliche Überraschung war nicht die Qualität: Technisches Deutsch übersetzten alle sechs korrekt, und fünf von sechs meisterten einen japanischen Dialog mit ausgelassenen Subjekten fehlerfrei. Auffällig waren die Kosten. Zwei vermeintlich günstige Modelle verbrauchten pro Anfrage so viele Reasoning-Tokens, dass eine Übersetzung am Ende 8- bis 10-mal mehr kostete als bei Claude – und damit in die Nähe der zeichenbasierten DeepL-Preise kam.
Wer 2026 das beste LLM zum Übersetzen sucht, sollte daher weniger fragen, welches Modell übersetzen kann – das können alle –, sondern welches zu Content-Typ und Volumen passt, ohne unbemerkt die Kosten hochzutreiben.
Welches Modell passt zu welchem Übersetzungsjob?
| Ihr Einsatzbereich | Empfehlung | Warum | Gemessene Kosten pro 1.000 Aufgaben |
|---|---|---|---|
| Marketingtexte, Markenstimme | Claude Sonnet 5 | Liest sich, als wäre es direkt in der Zielsprache geschrieben worden | ~$1.06 |
| Große Mengen: Produktfeeds, Dokumentation, Untertitel | DeepSeek V4 Flash | In allen drei Tests korrekt und mit großem Abstand am günstigsten | ~$0.10 |
| Gemischte Workloads, geringste Latenz | GPT-5.6 Terra | Antworten in 3.0–4.3s, sauberste Formatierung | ~$0.88 |
| Verbindliche Glossare, CAT-Tool-Workflows | DeepL | Terminologiedatenbanken und Integrationen, die LLM-APIs nicht mitbringen | $27.50 pro 1M Zeichen |
Die Kosten sind Mittelwerte aus unseren drei Testaufgaben (Output-Tokens × offizielle Preise vom Juli 2026), hochgerechnet auf 1.000 kurze Übersetzungen; die vollständige Messtabelle folgt weiter unten. Eine Kategorie liegt außerhalb des Tests: Für Live-Sprachgespräche bietet Google eine speziell entwickelte Variante von Gemini 3.5 Live Translate für $3.50/$21 pro Million Tokens an. Wir erwähnen sie, haben sie aber nicht getestet.
So haben wir getestet
Drei Prompts, sechs Modelle, identische Formulierung und je ein Durchlauf am 17. Juli 2026: englisch→japanischer Marketingtext zur Prüfung des Tons, englisch→deutsche API-Dokumentation für Fachterminologie sowie japanisch→englischer Alltagsdialog. Letzterer prüft ausgelassene Subjekte und Kontext – ein klassischer Schwachpunkt bei CJK-Sprachpaaren. CJK steht für Chinesisch, Japanisch und Koreanisch, also jene drei Sprachen, bei denen sich Beschwerden über maschinelle Übersetzungsqualität häufen.
Getestet wurden GPT-5.6 Terra, Claude Sonnet 5, DeepSeek V4 Flash, DeepSeek V4 Pro, GLM-5.2 und Kimi K2.6. Sämtliche Aufrufe liefen mit Standardeinstellungen über dasselbe Gateway-Konto. Die Latenzwerte sind deshalb untereinander vergleichbar, können sich aber je nach Region und Auslastung des Anbieters unterscheiden.
Hier die drei Quelltexte im Wortlaut, damit Sie den Test selbst wiederholen können:
EN→JA (Marketing): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE (technisch): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN (Dialog): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
Alle Messwerte nach Modell und Aufgabe, mit Latenz in Echtzeitsekunden und Output-Tokens aus dem Usage-Objekt:
| Modell | EN→JA | EN→DE | JA→EN | Ø Kosten pro Aufgabe |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
Kosten pro Aufgabe = Output-Tokens × offizieller Output-Preis des Anbieters. Der Input liegt bei 60–110 Tokens pro Aufgabe und schlägt selbst zu den Preisen von GPT-5.6 Terra mit weniger als $0.0003 zu Buche; die Grafik pro Million Zeichen weiter unten berücksichtigt ihn. Alle Preise sind offizielle Listenpreise vom 17. Juli 2026, nicht die vergünstigten Preise, die unserem Konto berechnet wurden.
Ein Stichprobentest mit drei Aufgaben kann keine Rangliste für 100 Sprachpaare erstellen – und genau das behaupten wir auch nicht. Er kann aber Unterschiede sichtbar machen, die selbst bei einer kleinen Stichprobe bestehen bleiben. Und diese Unterschiede waren erheblich.
Test 1: Englische Marketingtexte auf Japanisch
Der Prompt verlangte eine natürliche, höfliche japanische Fassung einer SaaS-Landingpage-Zeile: "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters."
Claude Sonnet 5 formulierte daraus:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
Das entspricht dem Register eines japanischen Copywriters: Das stilisierte カタチ – Katakana für „Form“ – und der durch Kommata gegliederte Rhythmus sind typische Landingpage-Konventionen, keine Lehrbuchgrammatik. GPT-5.6 Terra und DeepSeek V4 Pro folgten dicht dahinter mit klaren, geschäftsmäßigen Fassungen wie 「アイデアを、より迅速に形に。」.
DeepSeek V4 Flash übersetzte am wörtlichsten: 「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」. Grammatikalisch ist das völlig in Ordnung, klingt aber nach Übersetzung. Für eine Produktseite wäre ein menschliches Lektorat sinnvoll; für Support-Artikel oder interne Dokumentation reicht es problemlos aus.
Der Unterschied ist vorhanden, aber klein: Alle sechs Modelle lieferten brauchbares Japanisch. Bei der Markenstimme amortisieren sich die zusätzlichen rund $1 pro 1.000 Aufgaben für Claude; in keinem anderen Test war der Vorsprung so relevant.
Test 2: Englische technische Dokumentation auf Deutsch
Wir übersetzten zwei Sätze API-Dokumentation mit Rate Limits, HTTP 429, exponentiellem Backoff und Idempotency Keys. Alle sechs Modelle trafen die Fachbegriffe korrekt und nutzten die üblichen deutschen Dokumentationskonventionen: Ratenlimit, Statuscode 429, exponentielles Backoff und Idempotenzschlüssel.
Der einzige sichtbare Unterschied: GPT-5.6 Terra setzte Retry-After als Code, wie es in echten deutschen API-Dokumentationen bei Header-Namen üblich ist. Ein nettes Detail, aber kein Qualitätsunterschied.
Bei normaler Dokumentationsprosa zwischen gut abgedeckten europäischen Sprachen produzierte kein Modell unserer Stichprobe einen Fehler; in dieser Modellgeneration waren Qualitätsunterschiede zu klein, um sie zu beobachten. Wer ausschließlich solche Inhalte übersetzt, sollte nach Preis und Geschwindigkeit entscheiden, nicht nach Qualität. Damit ist DeepSeek V4 Flash mit $0.14 Input / $0.28 Output pro Million Tokens die Standardempfehlung.
Test 3: Japanisch→Englisch – Dialog mit ausgelassenen Subjekten
Im Japanischen wird das Subjekt eines Satzes oft weggelassen; Übersetzer müssen daher aus dem Kontext erschließen, wer was tut. Unser Testdialog enthielt außerdem 根回し (nemawashi): einen kulturell geprägten Begriff für das informelle Herstellen von Zustimmung vor einer formellen Entscheidung, ohne direkte englische Entsprechung.
Fünf der sechs Modelle lösten alle Aspekte korrekt. Die Subjekte waren richtig zugeordnet, und nemawashi erschien als „lay the groundwork“, „sound him out beforehand“ oder „give him a heads-up“ – alles vertretbare Varianten. Claudes Fassung klang am ehesten wie natürlicher Dialog: „he's probably gonna chew me out“.
Der einzige echte Fehler unter allen 18 Ausgaben kam von DeepSeek V4 Pro. Das Modell übersetzte 「先に根回ししといたほうがいい」 – einen Rat dazu, was als Nächstes zu tun ist – mit „You should've laid the groundwork first“, also als Bedauern in der Vergangenheit über eine bereits verpasste Handlung. Wenige kleine Wörter, aber die gegenteilige Bedeutung. Würde ein Kollege das eine sagen und Sie das andere verstehen, handelten Sie anders.
Ein Tempusfehler in einem Durchlauf ist ein Datenpunkt, kein abschließendes Urteil über das Modell; die beiden DeepSeek-Stufen vergleichen wir ausführlicher in unserem Vergleich DeepSeek V4 Flash vs Pro. Dennoch ist es eine hilfreiche Erinnerung daran, dass flüssig und sinngenau zwei verschiedene Eigenschaften sind: Der Satz liest sich perfekt, bedeutet aber das Falsche. Bei Verträgen, medizinischen Inhalten oder allem, bei dem ein falsch verstandenes Tempus Geld kostet, sollten Sie unabhängig vom gewählten Modell ein menschliches Review einplanen.
Die Token-Falle: Warum die Preistabelle täuscht
Dieses Ergebnis verändert die Kaufentscheidung. Pro Million Output-Tokens kosten GLM-5.2 $4.40 und Kimi K2.6 $4.00 – also weniger als die Hälfte von Claude Sonnet 5 mit $10. Pro tatsächlich ausgeführter Übersetzung waren sie jedoch 8- bis 10-mal teurer.
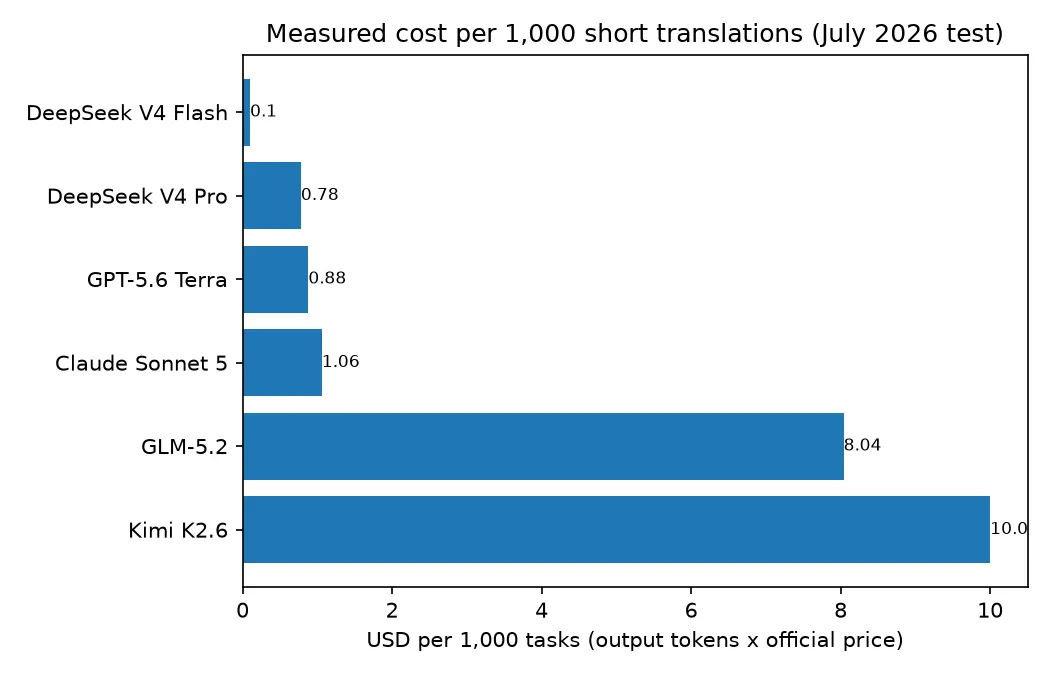
Der Grund: Beide Modelle durchlaufen vor der Antwort eine sichtbare Reasoning-Kette, und diese Reasoning-Tokens werden als Output abgerechnet. Für die Übersetzung eines einzigen Marketing-Satzes gab Kimi K2.6 2,849 Output-Tokens und GLM-5.2 1,906 aus, obwohl die Übersetzungen nur 40–60 Tokens lang waren. Claude Sonnet 5 benötigte für dieselbe Aufgabe 60 Tokens, GPT-5.6 Terra 46.
Die Latenz folgte demselben Muster. GPT-5.6 Terra und Claude Sonnet 5 antworteten bei allen drei Aufgaben in 3–4 Sekunden. DeepSeek V4 Flash brauchte 4–5s, DeepSeek V4 Pro 16–20s, während GLM-5.2 und Kimi K2.6 pro Anfrage zwischen 20 und 48 Sekunden lagen.
Daraus ergeben sich zwei praktische Regeln. Erstens: Bei kurzen Aufgaben mit hohem Volumen wie Übersetzungen sollten Sie Modelle anhand der gemessenen Kosten pro Aufgabe vergleichen, nicht anhand der Listenpreise. Führen Sie 20 Anfragen aus und prüfen Sie das Usage-Feld. Zweitens: Deaktivieren oder reduzieren Sie Reasoning für Übersetzungen. DeepSeek trennt Thinking- und Non-Thinking-Endpunkte, GLM und Kimi bieten Thinking-Parameter im Request-Body. Über alle drei Aufgaben hinweg brachte die Reasoning-Kette keinen erkennbaren Qualitätsgewinn.
Übersetzungskosten bei großen Mengen
Rechnet man den gemessenen Tokenverbrauch auf eine Million Zeichen englischen Quelltexts hoch – ungefähr 250.000 Tokens –, wird der Abstand drastisch:
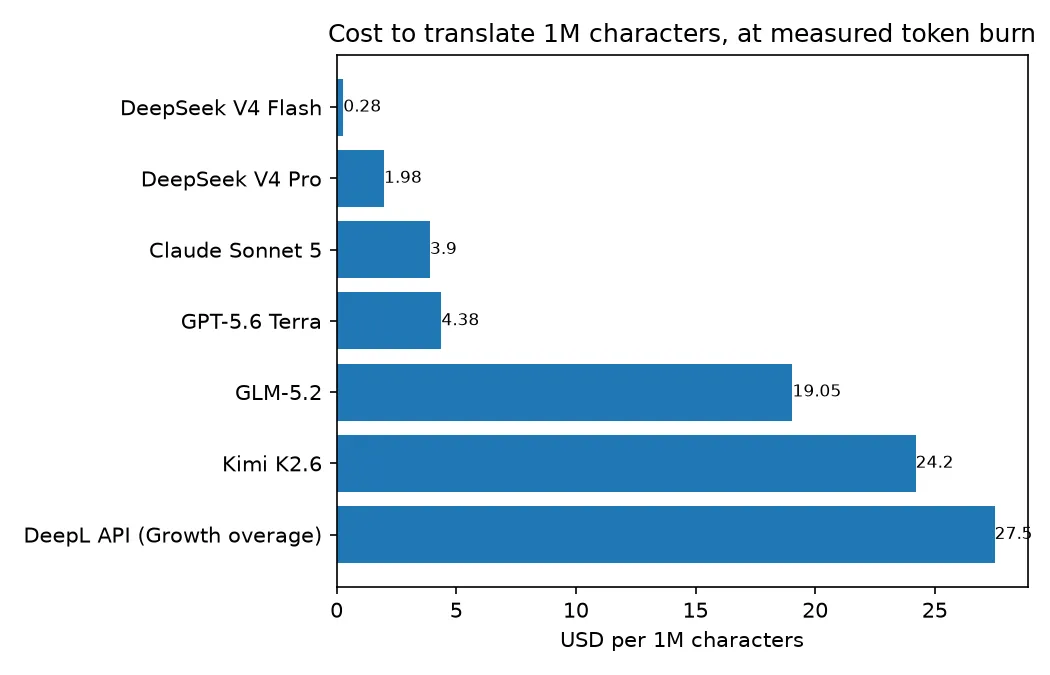
DeepSeek V4 Flash übersetzt Text im Umfang eines ganzen Romans für etwa $0.28. Dasselbe Volumen kostet über die DeepL-API zu den Mehrverbrauchspreisen des Growth-Plans $27.50 – ein Unterschied um den Faktor 98. Das deckt sich in der Richtung mit einer viel geteilten r/LocalLLaMA-Analyse unter dem Titel "LLMs are 800x cheaper for translation than DeepL"; der größere Faktor dort ergab sich aus kleineren selbst gehosteten Modellen.
Beachten Sie das obere Ende der Grafik: Bei gemessenem Tokenverbrauch schließen die Reasoning-intensiven Open-Weight-Modelle fast zu DeepL auf. Ein Stückpreis ohne Tokenmessung ist keine Kostenprognose.
Drei Preisfakten, die Sie vor einer Entscheidung kennen sollten; alle am 17. Juli 2026 geprüft:
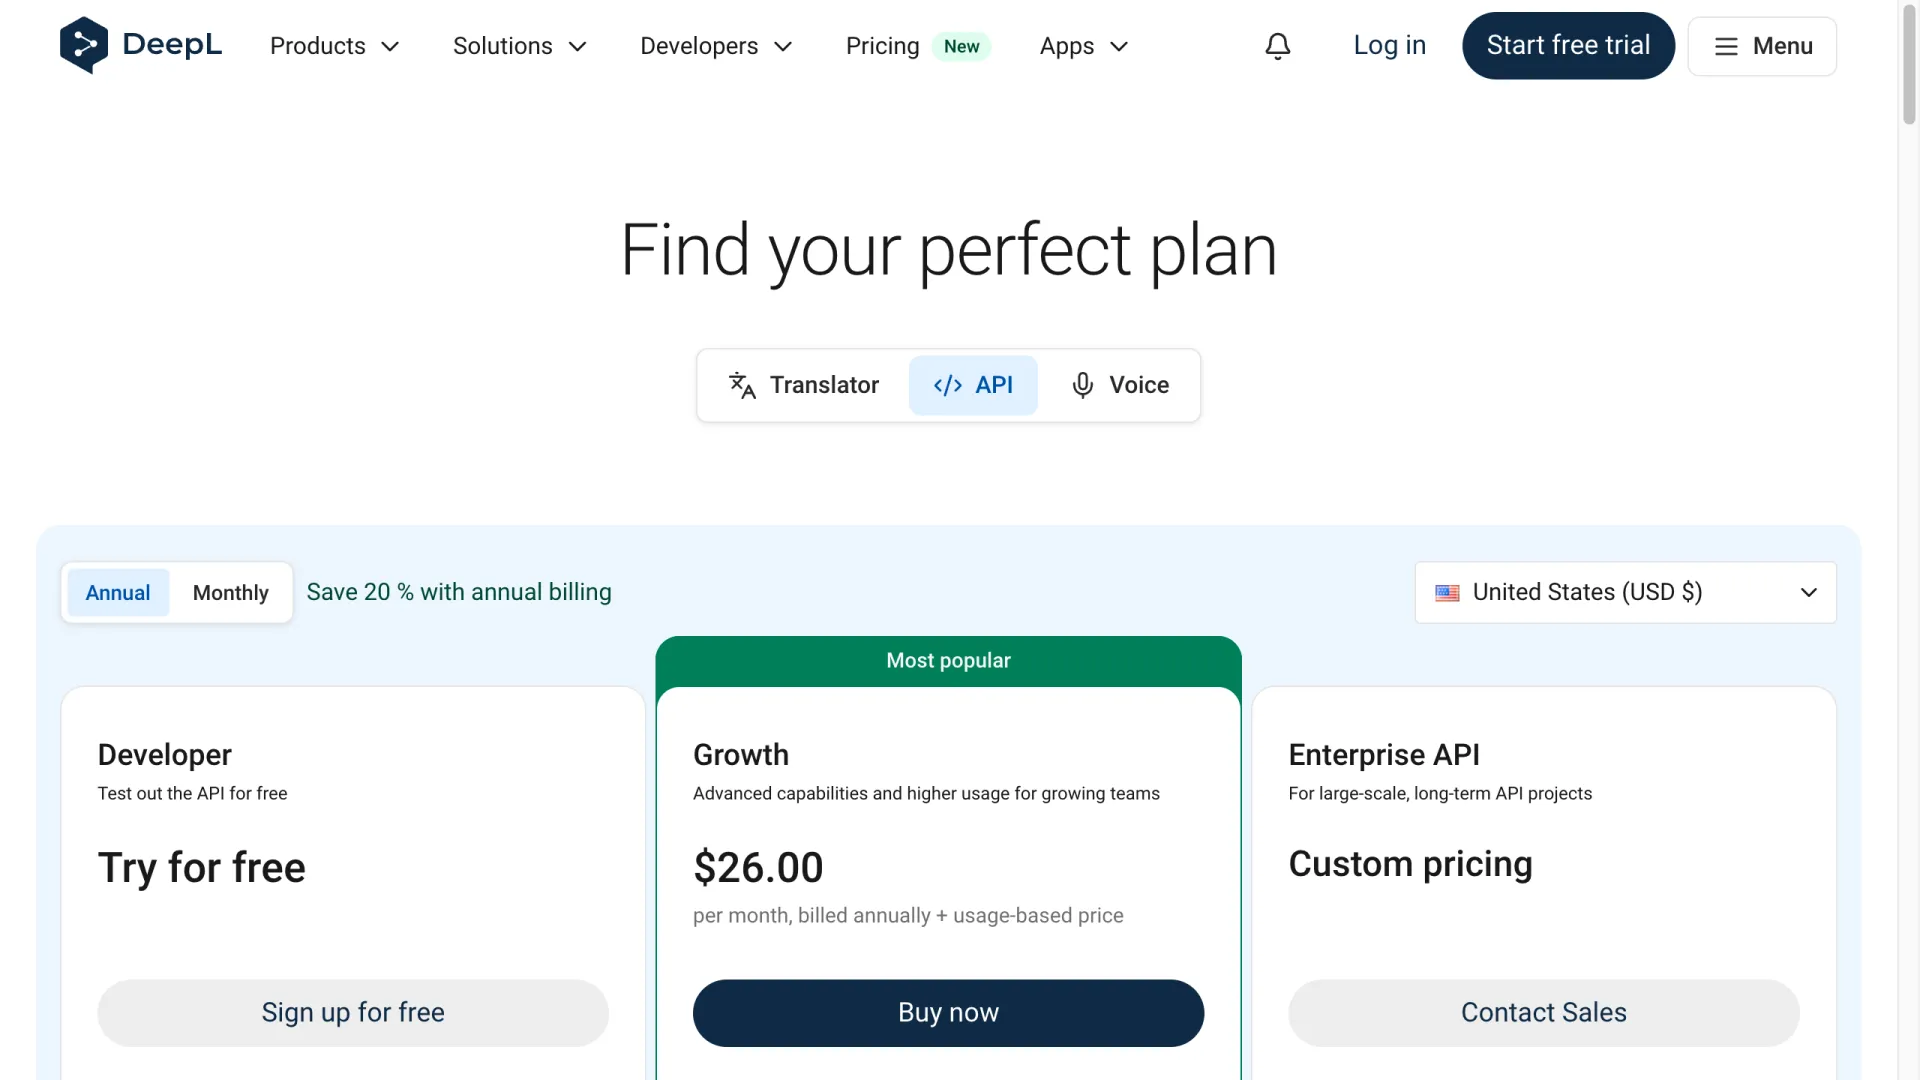
- DeepLs Free-Tier hat sich geändert. Der API-Developer-Plan gewährt jetzt ein einmaliges Guthaben von 1,000,000 Zeichen statt der monatlichen Freimenge von 500,000 Zeichen, die in älteren Dokumentationen und Forenantworten noch häufig genannt wird. Growth kostet $26/Monat bei jährlicher Abrechnung, enthält 12M Zeichen/Jahr und berechnet danach $27.50 pro zusätzlicher Million.
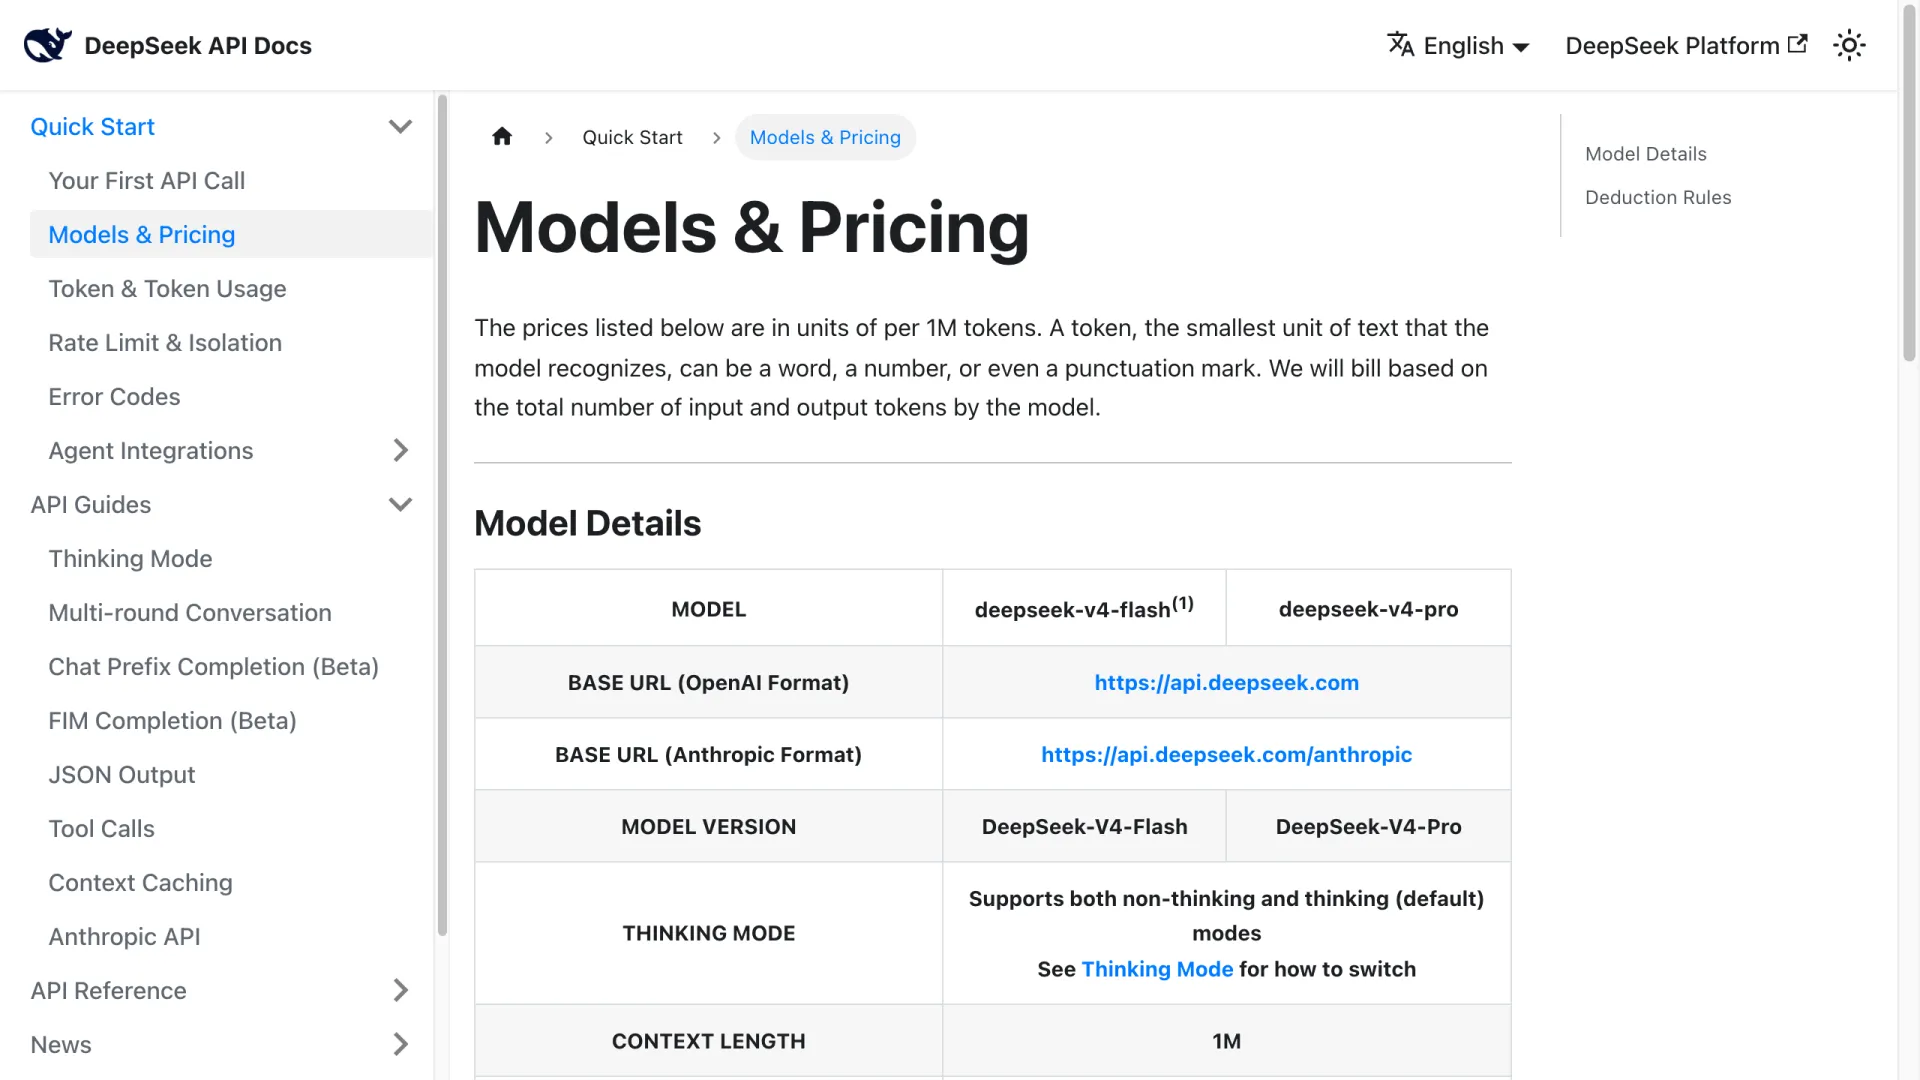
- DeepSeek rechnet nur einen Bruchteil der Preise anderer Anbieter ab. Für V4 Flash gelten $0.14 Input / $0.28 Output pro Million Tokens; bei Cache-Hits sinkt der Input auf $0.0028. Der bisherige Modellname deepseek-chat wird am 24. Juli 2026 eingestellt.
- Claude Sonnet 5 hat Einführungspreise. Bis zum 31. August 2026 kostet es $2/$10 pro Million Tokens, danach $3/$15. Sein neuerer Tokenizer erzeugt für denselben Text außerdem ungefähr 30% mehr Tokens, was unsere Kostenrechnung bereits berücksichtigt. Wer über September hinaus plant, sollte beides einbudgetieren.
- Batch-APIs halbieren die Rechnung. OpenAI, Anthropic und Google bieten für asynchrone Batch-Verarbeitung jeweils rund 50% Rabatt. Übersetzungs-Workloads sind meist nicht latenzkritisch, daher ist das praktisch gespartes Geld: Mit Batch-Preisen sinkt GPT-5.6 Terra auf ~$2.19 und Claude Sonnet 5 auf ~$1.95 pro Million Zeichen.
Wann DeepL oder Google Translate weiterhin gewinnt
Bei den Kosten pro Zeichen liegen LLMs vorn, doch drei Anforderungen sprechen weiterhin für die anderen Lösungen:
- Verbindliche Terminologie. DeepL bietet Glossare und Terminologiedatenbanken, die sicherstellen, dass ein Begriff jedes Mal gleich übersetzt wird. Bei einem LLM geben Sie dies per Prompt vor und kontrollieren das Ergebnis; das ist probabilistisch, nicht erzwungen.
- CAT-Tool- und Pipeline-Integrationen. Liegt Ihr Translation Memory in einem CAT-Tool (computer-assisted translation), lassen sich DeepLs Konnektoren direkt anbinden.
- Latenz unter einer Sekunde bei Skalierung. Klassische neuronale MT-Engines reagieren typischerweise schneller als allgemeine LLMs. Für Inline-Übersetzungen in Benutzeroberflächen ist das relevant.
Für Live-Sprache sind weder klassische NMT noch Chat-LLMs die passende Form. Google berechnet für eine dedizierte Variante von Gemini 3.5 Live Translate $3.50/$21 pro Million Tokens sowie Audiopreise pro Minute; Details dazu finden sich in unserer Analyse von Gemini 3.5 Live Translate.
Bei seltenen Sprachen und Sprachen mit wenigen Ressourcen ist die Abdeckung wichtiger als jede Qualitätsrangliste: Prüfen Sie zuerst, ob Ihr Sprachpaar überhaupt unterstützt wird. DeepL unterstützt rund 30 Sprachen; große LLMs beherrschen mehr als hundert, wobei die Qualität zu den Randbereichen hin nachlässt.
Open Source und lokale Modelle
GLM-5.2 und Kimis K-Serie veröffentlichen beide offene Gewichte. Damit lässt sich das oben beschriebene Tokenverbrauchsproblem beim Self-Hosting beheben: Sie kontrollieren die Sampling-Einstellungen und können Reasoning-Ketten vollständig unterdrücken.
Für lokale Übersetzungen auf einer einzelnen GPU taucht Qwen3-30B-A3B in r/LocalLLaMA-Diskussionen über lokale Übersetzungsmodelle immer wieder als Empfehlung für europäische Sprachen ins Englische auf. Bei exotischeren Sprachpaaren werden größere Modelle empfohlen. Der Grund ist meist Datenschutz – etwa bei Verträgen oder noch nicht veröffentlichten Produkten – oder der Wegfall variabler Kosten, nicht bessere Qualität. In denselben Diskussionen werden gehostete Frontier-Modelle weiterhin als die besseren Übersetzer beschrieben.
Beobachtenswert: Kimi K3 erschien diese Woche mit offenen Gewichten und kostet gehostet $3/$15 pro Million Tokens. Wir testeten K2.6, weil der API-Zugang zu K3 noch ausgerollt wurde. Falls K3 den Tokenhunger der K-Serie übernimmt, gilt derselbe Vorbehalt zu gemessenen Kosten.
So führen Sie den Vergleich selbst durch
Alles oben lässt sich mit etwa 20 API-Aufrufen reproduzieren: Wählen Sie zwei Sätze aus Ihren eigenen Inhalten, schicken Sie sie an jedes Kandidatenmodell und lesen Sie für die tatsächlichen Tokenzahlen das Usage-Objekt jeder Antwort aus. Die Gesamtkosten unseres Tests mit 18 Anfragen: unter $0.15.
Unangenehm ist vor allem die Verwaltung von sechs API-Keys bei fünf Anbietern. Wir haben alle sechs Modelle über ein AIReiter-Konto ausgeführt. Der Dienst verkauft API-Zugang zu großen Modellen weiter – Keys der Claude-Familie etwa zu rund einem Fünftel des Listenpreises – und bündelt alles hinter einem Anthropic-kompatiblen Endpunkt: ein Key, dasselbe Wire-Format für jedes hier genannte Modell.
Wenn Ihr Übersetzungsvolumen relevant ist, schlägt eine Stunde Stichproben mit Ihren eigenen Inhalten jede Rangliste – auch diese. Bei der Qualität liegen die Modelle nah genug beieinander, dass Sprachpaar, Tonanforderungen und gemessene Tokenwerte die Entscheidung bestimmen sollten.
FAQ
Ist ChatGPT oder Gemini besser zum Übersetzen?
In unseren Tests war GPT-5.6 Terra bei allen drei Aufgaben schnell, präzise und sauber formatiert. Gemini haben wir nicht direkt getestet, weil es nicht über unser Gateway verfügbar war. Die veröffentlichten Preise sind jedoch konkurrenzfähig ($1.50/$9 pro Million Tokens für 3.5 Flash), und Google ist der einzige Anbieter mit einem dedizierten Modell für Live-Sprachübersetzung.
Welcher KI-Übersetzer ist derzeit am genauesten?
Bei Sprachpaaren mit guter Datenabdeckung sind die Genauigkeitsunterschiede zwischen Frontier-Modellen gering; alle sechs getesteten Modelle übersetzten technisches Deutsch fehlerfrei. Unterschiede zeigen sich vor allem beim Ton – Claude führte bei japanischen Marketingtexten – und bei Sonderfällen wie ausgelassenen Subjekten und Tempus. Hier machte DeepSeek V4 Pro den einzigen echten Fehler unserer Stichprobe.
Welches Open-Source-LLM eignet sich am besten für Übersetzungen?
GLM-5.2 und Kimi K2.6 veröffentlichen beide Gewichte und übersetzten in unseren Tests korrekt. Beim Self-Hosting lassen sich die Reasoning-Ketten abschalten, welche die gehosteten APIs pro Aufgabe teuer machen. Für Consumer-Hardware ist Qwen3-30B-A3B die übliche Community-Empfehlung.
Kann ein LLM einen menschlichen Übersetzer ersetzen?
Für interne Dokumentation, Support-Inhalte und große Mengen an Produkttexten: weitgehend ja, bei je nach Modell 1–16% von DeepLs Kosten pro Zeichen (DeepSeek V4 Flash ~1%, Claude Sonnet 5 ~14%, GPT-5.6 Terra ~16%). Bei Verträgen, medizinischen Texten und Markenkampagnen ist der Tempusfehler aus Test 3 die Warnung. Flüssige Ausgaben können die Bedeutung trotzdem umkehren; wo ein Missverständnis teuer wird, bleibt menschliches Review notwendig.
Lohnt sich DeepL 2026 noch?
Ja, in drei Fällen: bei verbindlichen Glossaren, CAT-Tool-Integration und Latenzen unter einer Sekunde. Außerhalb dieser Szenarien sind die Kosten pro Zeichen schwer zu rechtfertigen. Beachten Sie außerdem: Das kostenlose Kontingent ist jetzt ein einmaliges Guthaben von 1M Zeichen, nicht monatlich.